Zum Hauptinhalt springen

DeepSeekSprachmodellAktiv

DeepSeek-V4.1-Flash

DeepSeek-V4.1-Flash liegt im oberen Mittelfeld: Platz 29 von 91 im Gesamtindex. Per API ist es günstig.

LeistungPlatz 29 von 91

99,7Gesamtindexhöher ist besser

TempoPlatz 14 von 100

176Token pro Sekundehöher ist besser

PreisPlatz 12 von 94

Eingabe 0,15 $ · Ausgabe 0,60 $

0,26 $je 1 Mio. Tokenniedriger ist besser

KontextPlatz 31 von 101

1 Mio.Token auf einmal≈ 1.500 A4-Seiten

BeliebtheitPlatz 312 von 876

38von 100wie im Vormonat

Zusammenfassung

Es ist günstig: 0,26 $ je 1 Mio. Token (Eingabe und Ausgabe gemischt), ein typisches Modell kostet 1,56 $. Mit 176 Token pro Sekunde schreibt es schneller als ein typisches Modell (87). Geschätzt, ohne eigene Werte in: Schlussfolgern und Wissen.

Neu an DeepSeek-V4.1-Flash sind native Bildverarbeitung und die asymmetrische Aktivierung. DeepSeek nennt 552 Milliarden Backbone-Parameter, 8 Milliarden aktive Parameter beim Prefill, 16 Milliarden bei der Ausgabe und 1.000.000 Token Kontext. Der Reasoning-Aufwand lässt sich feiner staffeln als in der ursprünglichen V4-Flash-Linie.

Am 10. September 2026 stellte DeepSeek die alten V4-Flash- und V4-Flash-Vision-Exp-Routen ein und leitete sie vorübergehend hierher um. deepseek-flash bezeichnet damit standardmäßig den aktuellen Dienst, nicht die alten Gewichte.

Benchmarks von DeepSeek-V4.1-Flash

Gesamtindex (Gradually Meta-Score v4)

20 von 91 Modellen

4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

GPT-6 Astramax121,3
GPT-6.1 Solmax119,2
Muse Wondermax113,4
GPT-6 Solmax110,6
GPT-5.6 Solmax108,7
DeepSeek-V4.1-Flashmax99,7

DeepSeek-V4.1-Flash nach Reasoning-Stufe

Punkte auf der Skala des Gesamtindex. Der Wert bei max ist der Gesamtindex von DeepSeek-V4.1-Flash, die übrigen Stufen leiten sich aus denselben Testreihen von Artificial Analysis ab. Fehlende Stufen werden nie geschätzt.

6080100120ohnelowmediumhighxhighmaxGLM-5.3 · low: 89,3GLM-5.3 · max: 100,7GPT-5.6 Terra · low: 83,4GPT-5.6 Terra · medium: 88,1GPT-5.6 Terra · high: 93,7GPT-5.6 Terra · xhigh: 96,3GPT-5.6 Terra · max: 100,7DeepSeek-V4.1-Flash · ohne: 84,6DeepSeek-V4.1-Flash · max: 99,7
DeepSeek-V4.1-Flashohne 84,6 · max 99,7GLM-5.3low 89,3 · max 100,7GPT-5.6 Terralow 83,4 · medium 88,1 · high 93,7 · xhigh 96,3 · max 100,7Gefüllter Punkt: Stufe des Gesamtindex. Schattierung: 95-%-Bereich.

Quelle: Meta-Score v4; Stufen: Artificial Analysis

Tempo

20 von 100 Modellen

Mercury 2.5576Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.1 Flash-Lite336Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash-Lite299Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Nemotron 3.5 Lightning245Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Haiku 5.5236Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
o3-mini230Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Ling 3.0 Flash199Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V3 0324195Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 mini191Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3 Flash Preview191Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash184Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.6 Flash182Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Command A Plus177Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V4.1-Flash176Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek V4.1 Flash 1017172Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Qwen 3.7 Max165Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 nano153Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 20B152Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 120B151Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Sonnet 5.5151Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06

Ausgabe-Token pro Sekunde, gemessen von Artificial Analysis

Leistung gegen Preis

lohnendster Bereich: stärker und günstiger als die Hälfte der gezeigten Modellebeste Leistung für den Preis

801001200,10 $0,50 $2 $10 $20 $Gemini 3.6 Flash: 96,7, 1,50 $Step 5 Preview: 97,3, 1,43 $MiMo V2.6 Flash: 98,3, 0,18 $Claude Opus 4.8: 99,0, 10 $Qwen 3.8 Max 0902: 100,3, 2,48 $GLM-5.3: 100,7, 2,15 $GPT-5.6 Terra: 100,7, 4,50 $MiMo V2.6 Pro: 100,9, 0,54 $GPT-5.5: 100,9, 11,25 $Kimi K3: 101,2, 6 $Grok 4.6: 102,4, 3 $Grok 4.7: 103,3, 3 $Claude Haiku 5.5: 103,4, 0,20 $GPT-6.1 Terra: 105,2, 2 $Gemini 3.8 Flash: 106,5, 1,50 $DeepSeek V4.1 Flash 1017: 106,6, 0,26 $Muse Spark 1.3: 107,4, 2 $GPT-5.6 Sol: 108,7, 8 $GPT-6 Sol: 110,6, 4 $Claude Fable 5: 112,5, 20 $Kimi K3.1 Pro: 112,9, 4 $Muse Wonder: 113,4, 8 $Claude Opus 5: 117,2, 10 $GPT-6.1 Sol: 119,2, 4 $GPT-6 Astra: 121,3, 20 $Gemini 4 Argon: 122,3, 4 $Claude Sonnet 5.5: 122,8, 4 $Claude Fable 5.1: 123,8, 20 $Claude Opus 5.5: 126,1, 8 $DeepSeek-V4.1-Flash: 99,7, 0,26 $DeepSeek-V4.1-FlashClaude Opus 5.5Claude Fable 5.1Claude Sonnet 5.5Gemini 4 ArgonGPT-6 AstraGPT-6.1 SolClaude Opus 5Muse WonderKimi K3.1 ProClaude Fable 5GPT-6 SolGPT-5.6 SolMuse Spark 1.3DeepSeek V4.1 Flash 1017Gemini 3.8 FlashGPT-6.1 TerraClaude Haiku 5.5Grok 4.7Grok 4.6Kimi K3GPT-5.5MiMo V2.6 ProGPT-5.6 TerraGLM-5.3Qwen 3.8 Max 0902Claude Opus 4.8MiMo V2.6 FlashStep 5 PreviewGemini 3.6 FlashPreis je 1 Mio. Token (Mischpreis)Gesamtindex

DeepSeek-V4.1-Flash nach Aufgabenbereich

Punkte, 100 = Durchschnitt der Referenzgruppe · höher ist besser

AgentenPlatz 17 von 83106,4
FinanzenPlatz 24 von 96103,7
RechtPlatz 29 von 66100,8
ProgrammierenPlatz 30 von 9098,8
Mathematikzu wenig Daten97,3
AllgemeinPlatz 28 von 6097,1
MultimodalPlatz 17 von 4695,7
GesundheitPlatz 27 von 6895,5

Heller Balken: noch zu wenig Ergebnisse für einen Platz. Noch keine Tests: Schlussfolgern, Wissen.

Text-Arena

Wie Menschen die Antworten im Blindvergleich bewerten, Elo-Punkte mit Stilkontrolle · höher ist besser

20 von 40 Modellen

Stand 30. Oktober 2026 · Quelle: LMArena

WebDev-Arena

Wie Menschen gebaute Webseiten und Web-Apps im Blindvergleich bewerten, Elo-Punkte · höher ist besser

20 von 43 Modellen

Stand 30. Oktober 2026 · Quelle: LMArena

Terminal-Bench 4.0

Anteil gelöster Aufgaben, die das Modell als Agent im Terminal erledigt, in Prozent · höher ist besser

20 von 38 Modellen

Stand 6. November 2026 · Quelle: Vals AI

Vibe Code Bench

Anteil der Apps, die das Modell aus einer Beschreibung korrekt baut, in Prozent · höher ist besser

20 von 51 Modellen

Stand 6. November 2026 · Quelle: Vals AI

Alle 723 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 62

Veröffentlichte Benchmarks

LMArena Text, Style Control

Russian prompts

Hinweis (DeepSeek-V4.1-Flash): Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.

DeepSeek-V4.1-Flash1.479,62 Bewertung
GPT-6 Astra1.470,69 Bewertung

höhere Werte sind besserStand 30. Oktober 2026Skala: 0 Bewertung - 1.479,62 Bewertung

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Vergleichskohorte
lmarena-text-style-control:2026-10-28:russian
Messgröße
style-controlled Bradley-Terry rating
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
2
Methodik und Einordnung
Arena-Bewertung aus 1.938 veröffentlichten Paarvergleichen.. Kennung des Quellmodells: lmarena/DeepSeek-V4.1-Flash-20260910 (Max). Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Modellstand: DeepSeek-V4.1-Flash-20260910 (Max). Evaluator: LMArena. Datensatztyp: public-crowdsourced-preferences. Stand der Rangliste: 2026-10-28. Harness: Arena Text, style control. Reasoning-Stufe: max. Quellenkennung: lmarena. Kennung der Evidenzaufnahme: lmarena-323062f70843f40e3f739865c3fe9d806126e412-c2c334909874. Prüfsumme der Quelldaten: c2c334909874e3f6fdc66b3dd9ed16f71e1a541453d48b55891e61757486d682. Parserversion: lmarena-dataset-v1. Importiert am: 2026-10-30
Quelle: LMArena

Programmieren

Code Migration v1.1

TeilaufgabeDeepSeek-V4.1-Flash (Dieses Modell)DeepSeek V4.1 Flash 1017
CLI47,75 %59,2 % (bester Wert dieser Zeile)
COBOL92,5 % (bester Wert dieser Zeile)92,5 % (bester Wert dieser Zeile)
Code Quality3,68 % (bester Wert dieser Zeile)3,48 %
Overall58,94 %67,52 % (bester Wert dieser Zeile)

höhere Werte sind besserStand 6. November 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg

Methodik und Einordnung
Messgröße
accuracy

Dokumentierte Messdetails

LMArena Text, Style Control: Russian prompts (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1479.6194284504727
Bewertung
1479.6194284504727
Messgröße
style-controlled Bradley-Terry rating
Einheit
rating
Benchmark-Version
style-control-v1
Kategorie
general
Aufgabe
russian
Aufgabenbezeichnung
Russian prompts
Richtung
Mehr ist besser
Vergleichskohorte
lmarena-text-style-control:2026-10-28:russian
Konfidenzintervall
13.751435
Quellentyp
official-leaderboard
Auswertung
LMArena
Status
active
Abrufdatum
2026-10-30
Methodik
Arena-Bewertung aus 1.938 veröffentlichten Paarvergleichen.. Kennung des Quellmodells: lmarena/DeepSeek-V4.1-Flash-20260910 (Max). Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Modellstand: DeepSeek-V4.1-Flash-20260910 (Max). Evaluator: LMArena. Datensatztyp: public-crowdsourced-preferences. Stand der Rangliste: 2026-10-28. Harness: Arena Text, style control. Reasoning-Stufe: max. Quellenkennung: lmarena. Kennung der Evidenzaufnahme: lmarena-323062f70843f40e3f739865c3fe9d806126e412-c2c334909874. Prüfsumme der Quelldaten: c2c334909874e3f6fdc66b3dd9ed16f71e1a541453d48b55891e61757486d682. Parserversion: lmarena-dataset-v1. Importiert am: 2026-10-30
Vergleichsmethodik
Arena-Bewertung aus 1.938 veröffentlichten Paarvergleichen.. Harness: Arena Text, style control. Reasoning-Stufe: max
Einordnung
Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Quelle LMArena
Code Migration v1.1: CLI (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
47.747
Bewertung
47.747
Messgröße
accuracy
Einheit
%
Benchmark-Version
1.1
Kategorie
coding
Aufgabe
cli
Aufgabenbezeichnung
CLI
Richtung
Mehr ist besser
Vergleichskohorte
vals-code-migration-v1-1:1.1:cli
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-06
Methodik
Kennung des Quellmodells: deepseek/deepseek-v4.1-flash. Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-30. Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000. Latenz in Sekunden: 7584.512. Standardfehler: 2.674. Kosten je Aufgabe in USD: 1.270159. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-v1-1-2026-11-06-4085f8f7e916. Prüfsumme der Quelldaten: 4085f8f7e916ea8f5f458829ef9b624e3f87c68dc0e79642e03f1c9b679b61c0. Parserversion: vals-astro-v4. Importiert am: 2026-11-06
Vergleichsmethodik
Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000
Quelle Vals AI
Code Migration v1.1: COBOL (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
92.5
Bewertung
92.5
Messgröße
accuracy
Einheit
%
Benchmark-Version
1.1
Kategorie
coding
Aufgabe
cobol
Aufgabenbezeichnung
COBOL
Richtung
Mehr ist besser
Vergleichskohorte
vals-code-migration-v1-1:1.1:cobol
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-06
Methodik
Kennung des Quellmodells: deepseek/deepseek-v4.1-flash. Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-30. Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000. Latenz in Sekunden: 4505.811. Standardfehler: 6.962. Kosten je Aufgabe in USD: 0.54491. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-v1-1-2026-11-06-4085f8f7e916. Prüfsumme der Quelldaten: 4085f8f7e916ea8f5f458829ef9b624e3f87c68dc0e79642e03f1c9b679b61c0. Parserversion: vals-astro-v4. Importiert am: 2026-11-06
Vergleichsmethodik
Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000
Quelle Vals AI
Code Migration v1.1: Code Quality (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
3.675
Bewertung
3.675
Messgröße
accuracy
Einheit
%
Benchmark-Version
1.1
Kategorie
coding
Aufgabe
code_quality
Aufgabenbezeichnung
Code Quality
Richtung
Mehr ist besser
Vergleichskohorte
vals-code-migration-v1-1:1.1:code_quality
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-06
Methodik
Kennung des Quellmodells: deepseek/deepseek-v4.1-flash. Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-30. Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000. Latenz in Sekunden: 6814.837. Standardfehler: 0.036. Kosten je Aufgabe in USD: 1.088847. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-v1-1-2026-11-06-4085f8f7e916. Prüfsumme der Quelldaten: 4085f8f7e916ea8f5f458829ef9b624e3f87c68dc0e79642e03f1c9b679b61c0. Parserversion: vals-astro-v4. Importiert am: 2026-11-06
Vergleichsmethodik
Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000
Quelle Vals AI
Code Migration v1.1: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
58.936
Bewertung
58.936
Messgröße
accuracy
Einheit
%
Benchmark-Version
1.1
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Vergleichskohorte
vals-code-migration-v1-1:1.1:overall
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-06
Methodik
Kennung des Quellmodells: deepseek/deepseek-v4.1-flash. Name des Quellmodells: DeepSeek-V4.1-Flash. Anbieter laut Quelle: DeepSeek. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-30. Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000. Latenz in Sekunden: 6814.837. Standardfehler: 2.656. Kosten je Aufgabe in USD: 1.088847. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-v1-1-2026-11-06-4085f8f7e916. Prüfsumme der Quelldaten: 4085f8f7e916ea8f5f458829ef9b624e3f87c68dc0e79642e03f1c9b679b61c0. Parserversion: vals-astro-v4. Importiert am: 2026-11-06
Vergleichsmethodik
Reasoning-Stufe: max. Temperatur: 1. Top P: 1. Maximale Ausgabetoken: 384000
Quelle Vals AI

Seite 1 von 62

Selbst ansehen: ein Auftrag, ein Versuch

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

DeepSeek-V4.1-Flash

DeepSeek-V4.1-Flash: SVG-Kurztest

Auftrag

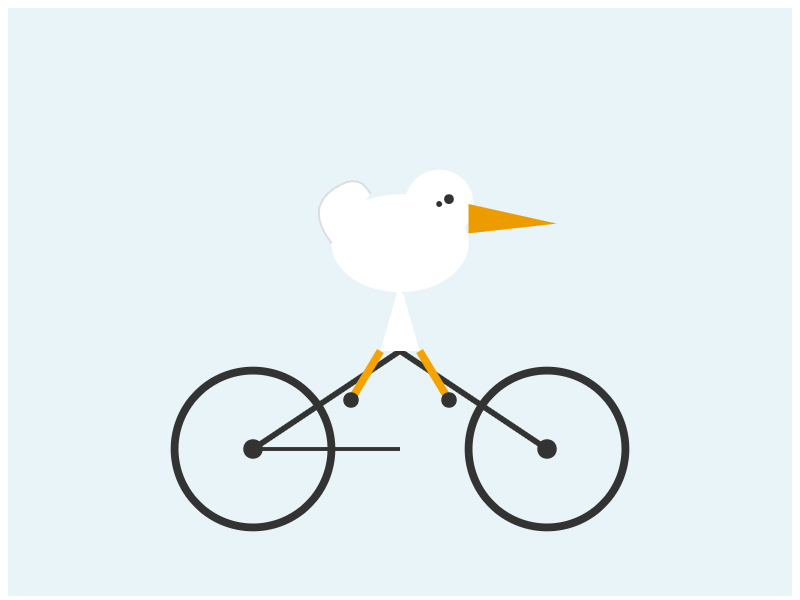
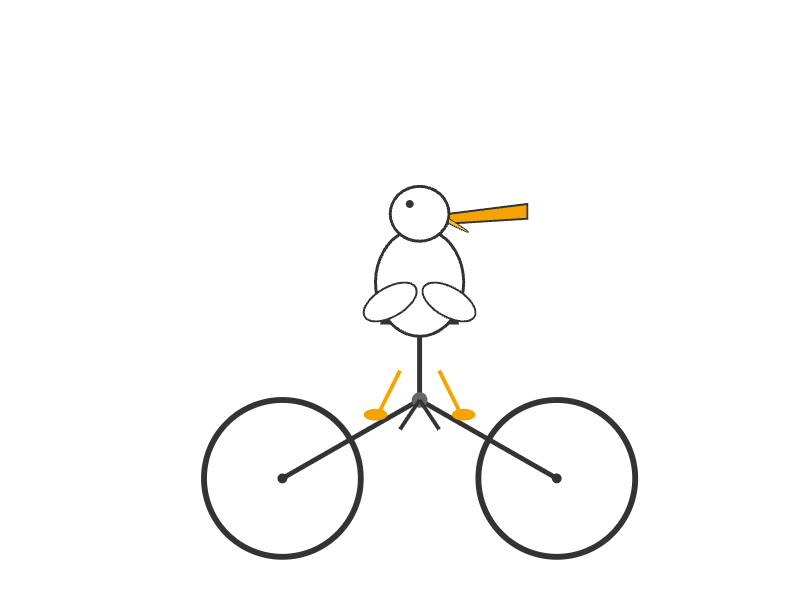
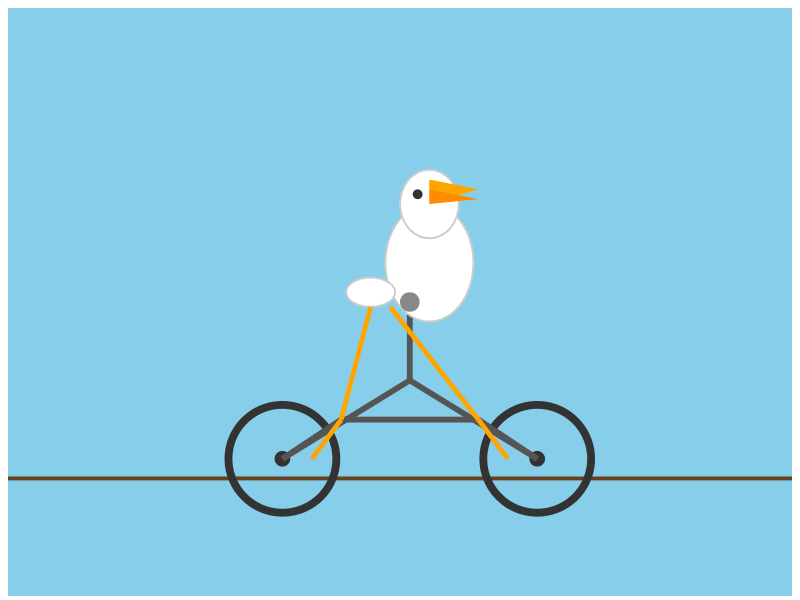
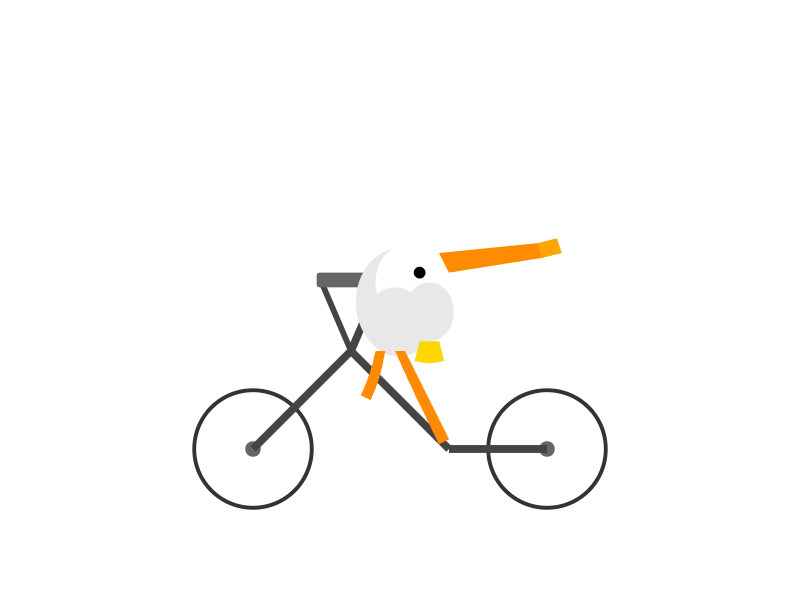
Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0001 $

Testdetails
Testlauf
14.10.2026
Anbieter
decart/fp4
API-Modell
deepseek/deepseek-v4.1-flash
Ausgabe
590 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0001 $
Testrunde
43b8c5c46830
Frühere Tests

Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

05.10.2026 · 26 s · 0,0049 $

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
05.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
deepseek/deepseek-v4.1-flash
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
8.191 Token
Kosten des Versuchs
0,0049 $
Antwortzeit
25,8 s
API-Modell laut Antwort
deepseek/deepseek-v4.1-flash
Festgelegter Endpunkt
DeepSeek | deepseek/deepseek-v4.1-flash-20260910
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden

Frühere Versuche (2)

  • 02.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Ursprung der Aufgabe: Simon Willison

Gleicher Auftrag, vier Modelle

Aus dem SVG-Kurztest: Pelikan auf einem Fahrrad, für alle Modelle mit denselben festen Einstellungen ohne Reasoning, ein Versuch je Modell. Ein Eindruck, keine Wertung.

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 6. November 2026

DeepSeek-V4.1-FlashGemini 3.5 FlashMistral Medium 3.5Claude Opus 4.8Gemini 3.6 Flash

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

DeepSeek-V4.1-Flash im Vergleich

Mit anderem Modell vergleichen

Die beliebtesten Vergleiche

  1. 1Gemini 3.8 Flash vs. DeepSeek-V4.1-Flash
  2. 2Muse Spark 1.3 vs. DeepSeek-V4.1-Flash
  3. 3Claude Sonnet 5.5 vs. DeepSeek-V4.1-Flash
  4. 4Claude Opus 5.5 vs. DeepSeek-V4.1-Flash
  5. 5GPT-6 Luna vs. DeepSeek-V4.1-Flash
  6. 6GPT-6 Sol vs. DeepSeek-V4.1-Flash
  7. 7Claude Haiku 5.5 vs. DeepSeek-V4.1-Flash
  8. 8GPT-6 Astra vs. DeepSeek-V4.1-Flash
  9. 9Grok 4.7 vs. DeepSeek-V4.1-Flash
Alle 55 Vergleiche zeigen
  1. 10Claude Sonnet 5 vs. DeepSeek-V4.1-Flash
  2. 11GPT-5.6 Terra vs. DeepSeek-V4.1-Flash
  3. 12DeepSeek-V4.1-Flash vs. Qwen 3.8 Max 0902
  4. 13Claude Opus 5 vs. DeepSeek-V4.1-Flash
  5. 14Claude Opus 4.6 vs. DeepSeek-V4.1-Flash
  6. 15DeepSeek-V4.1-Flash vs. GLM-5.3-Flash
  7. 16Claude Sonnet 4.6 vs. DeepSeek-V4.1-Flash
  8. 17DeepSeek-V4.1-Flash vs. Mistral Large 4
  9. 18DeepSeek-V4-Pro vs. DeepSeek-V4.1-Flash
  10. 19DeepSeek-V4.1-Flash vs. GLM-5.2
  11. 20GPT-6.1 Sol vs. DeepSeek-V4.1-Flash
  12. 21Gemini 3.1 Pro Preview vs. DeepSeek-V4.1-Flash
  13. 22DeepSeek-V4.1-Flash vs. MiMo-V2.5-Pro
  14. 23DeepSeek-V4.1-Flash vs. GLM-5.3
  15. 24Gemini 3.5 Flash-Lite vs. DeepSeek-V4.1-Flash
  16. 25Gemini 3.6 Flash vs. DeepSeek-V4.1-Flash
  17. 26Claude Opus 4.8 vs. DeepSeek-V4.1-Flash
  18. 27Claude Haiku 4.5 vs. DeepSeek-V4.1-Flash
  19. 28DeepSeek-V4.1-Flash vs. Kimi K3
  20. 29GPT-5.6 Sol vs. DeepSeek-V4.1-Flash
  21. 30Claude Fable 5 vs. DeepSeek-V4.1-Flash
  22. 31GPT-5.6 Luna vs. DeepSeek-V4.1-Flash
  23. 32Gemini 4 Argon vs. DeepSeek-V4.1-Flash
  24. 33DeepSeek-V4.1-Flash vs. Qwen 3.8 27B
  25. 34Grok 4.6 vs. DeepSeek-V4.1-Flash
  26. 35DeepSeek-V4.1-Flash vs. Mistral Medium 3.5
  27. 36DeepSeek-V4.1-Flash vs. MiMo-V2.5
  28. 37Claude Sonnet 4.5 vs. DeepSeek-V4.1-Flash
  29. 38Claude Fable 5.1 vs. DeepSeek-V4.1-Flash
  30. 39Claude Opus 4.5 vs. DeepSeek-V4.1-Flash
  31. 40Claude Opus 4.7 vs. DeepSeek-V4.1-Flash
  32. 41DeepSeek-V4.1-Flash vs. GLM-5.1
  33. 42DeepSeek-V4.1-Flash vs. Mistral Large 3
  34. 43Gemini 3.5 Flash vs. DeepSeek-V4.1-Flash
  35. 44GPT-6.1 Terra vs. DeepSeek-V4.1-Flash
  36. 45Muse Wonder vs. DeepSeek-V4.1-Flash
  37. 46DeepSeek-V4.1-Flash vs. Kimi K3.1 Pro
  38. 47GPT-5.5 vs. DeepSeek-V4.1-Flash
  39. 48GPT-5.4 vs. DeepSeek-V4.1-Flash
  40. 49GPT-5.4 mini vs. DeepSeek-V4.1-Flash
  41. 50Gemini 4 Carbon vs. DeepSeek-V4.1-Flash
  42. 51Gemini 3.7 Flash vs. DeepSeek-V4.1-Flash
  43. 52Muse Wonder Full vs. DeepSeek-V4.1-Flash
  44. 53Grok 4.5 vs. DeepSeek-V4.1-Flash
  45. 54Grok 4.3 vs. DeepSeek-V4.1-Flash
  46. 55DeepSeek-V4.1-Flash vs. Kimi K2.6

Alle technischen Daten

Architektur

Architektur
Causal Encoder-Decoder MoE (20-layer encoder, 20-layer decoder); 8B active parameters per token on prefill, 16B on decode
Quelle: Architektur
Trainings-Token
45T
Quelle: Trainings-Token

Ein- und Ausgabe

Kontextfenster
1.000.000 Token
Quelle: Kontextfenster
Eingabe
Text, Bild
Quelle: Eingabe
Ausgabe
Text
Quelle: Ausgabe
Reasoning-Stufe
1-100
Quelle: Reasoning-Stufe
Werkzeugaufrufe
Ja
Quelle: Werkzeugaufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Open Weights
Quelle: Gewichte
Zugang
API, Lokal
Quelle: Zugang
Veröffentlichung
10.09.2026
Quelle: Veröffentlichung

API

API-Modellkennung
deepseek-flash (legacy names deepseek-v4-flash and deepseek-v4-flash-vision-exp are routed to this model)
Quelle: API-Modellkennung

Weitere Angaben

Hinweise
552B insgesamt, 8B bei der Eingabeverarbeitung und 16B bei der Ausgabe aktiv, 1M Kontext, multimodal und MIT-lizenziert
Quelle: Hinweise
Aktive Parameter bei der Eingabe
8 Mrd.
Quelle: Aktive Parameter bei der Eingabe
Aktive Parameter bei der Ausgabe
16 Mrd.
Quelle: Aktive Parameter bei der Ausgabe

Preise

Preisansicht wählen

39 Angebote, Preise in US-Dollar je 1 Mio. Token, Mischpreis aus 3 Teilen Eingabe und 1 Teil Ausgabe.

Angebote filtern
AnbieterEingabeAusgabeCache lesenMischpreis
DeepSeekOff-Peakdirekt0,15 $0,60 $0,003 $0,26 $
OpenInferenceFP40,0175 $0,40 $k. A.0,11 $
MorphFP80,022 $0,40 $k. A.0,12 $
RelaceFP40,006 $0,50 $k. A.0,13 $
DeepInfraFP8, Flex0,112 $0,336 $k. A.0,17 $
WaferUS0,051 $0,567 $k. A.0,18 $
DeepInfraFP80,14 $0,42 $k. A.0,21 $
InferenceNetFP80,103 $0,60 $k. A.0,23 $
InferenceNetUS0,103 $0,60 $k. A.0,23 $
AtlasCloudFP80,135 $0,54 $k. A.0,24 $
StreamLakeFP80,147 $0,588 $k. A.0,26 $
CoreWeaveFP80,13 $0,65 $k. A.0,26 $
Alibaba0,15 $0,60 $k. A.0,26 $
Mancer 2FP80,15 $0,75 $k. A.0,30 $
WaferMXFP40,19 $0,65 $k. A.0,31 $
DeepInfraFP8, Priority0,21 $0,63 $k. A.0,32 $
GMICloudFP80,18 $0,72 $k. A.0,32 $
Reka0,12 $0,96 $k. A.0,33 $
NovitaFP80,195 $0,78 $k. A.0,34 $
FireworksSpot0,21 $0,84 $k. A.0,37 $
Phala0,21 $0,84 $k. A.0,37 $
DigitalOcean0,225 $0,90 $k. A.0,39 $
PrimeIntellect0,156 $1,20 $k. A.0,42 $
MakoraFP80,26 $1,17 $k. A.0,49 $
CrusoeFP80,29 $1,20 $k. A.0,52 $
BaiduFP80,30 $1,20 $k. A.0,52 $
BaseTen0,30 $1,20 $k. A.0,52 $
BaseTenUS0,30 $1,20 $k. A.0,52 $
Cohere0,30 $1,20 $k. A.0,52 $
Fireworks0,30 $1,20 $k. A.0,52 $
GoogleGlobal0,30 $1,20 $k. A.0,52 $
Modal0,30 $1,20 $k. A.0,52 $
NebiusFP80,30 $1,20 $k. A.0,52 $
ParasailFP80,30 $1,20 $k. A.0,52 $
SiliconFlowFP80,30 $1,20 $k. A.0,52 $
Together0,30 $1,20 $k. A.0,52 $
VeniceFP80,30 $1,20 $k. A.0,52 $
FireworksUS0,45 $1,80 $k. A.0,79 $
ParasailFast0,45 $1,80 $k. A.0,79 $

Cache-Preise stammen aus dem Direkttarif, OpenRouter meldet sie für die übrigen Anbieter nicht. Direktpreis laut Hersteller, geprüft am 26.10.2026. Anbieterpreise über OpenRouter, Stand 06.11.2026. Zum LLM-Preisindex

Weitere Preisstufen und Regeln
API-Eingabe (Off-Peak)
0,15 $ pro 1 Mio. TokenQuelle
API-Ausgabe (Off-Peak)
0,6 $ pro 1 Mio. TokenQuelle
Cache lesen (Off-Peak)
0,003 $ pro 1 Mio. TokenQuelle
Spitzenzeiten (UTC)
Mo, Di, Mi, Do, Fr, 01:00-04:00 UTC; Mo, Di, Mi, Do, Fr, 06:00-10:00 UTC. Zu allen anderen Zeiten gelten Off-Peak-Preise.Quelle
API-Eingabe (Peak)
0,3 $ pro 1 Mio. TokenQuelle
API-Ausgabe (Peak)
1,2 $ pro 1 Mio. TokenQuelle
Cache lesen (Peak)
0,006 $ pro 1 Mio. TokenQuelle

7 Preisänderungen seit Beginn der Messung.

EingabeAusgabe

0 $0,50 $1 $1,50 $23.09.202606.11.2026
Täglich beobachteter Preis im LLM-Preisindex in US-Dollar je 1 Mio. Token. Der Index nutzt einen Marktpreis aus mehreren Quellen, der vom Direktpreis des Herstellers abweichen kann.

Kein Abo von DeepSeek mit diesem Modell. Über andere Anbieter ab ≈ 1,07 € im Monat (Command Code Go, mit begrenztem Guthaben). 28 Tarife in Deutschland.

Tarife filtern
TarifPreis im MonatHinweis
Genspark Freekostenlosmit begrenztem Guthaben
Command Code Go≈ 1,07 €mit begrenztem Guthaben
Token Plan Individual LiteAlibaba Cloud (Qwen)≈ 6,39 €mit begrenztem Guthaben
Poe Basic6,83 €mit begrenztem Guthaben
Command Code GOAT≈ 10,66 €mit begrenztem Guthaben
Token Plan Individual EssentialAlibaba Cloud (Qwen)≈ 10,66 €mit begrenztem Guthaben
Token Plan Individual StandardAlibaba Cloud (Qwen)≈ 19,18 €mit begrenztem Guthaben
Command Code Pro≈ 21,32 €mit begrenztem Guthaben
Token Plan Team Team Standard SeatAlibaba Cloud (Qwen)≈ 21,32 €mit begrenztem Guthaben, für Teams, je Nutzer
Warp Build≈ 21,32 €mit begrenztem Guthaben
Genspark Plus≈ 26,64 €mit begrenztem Guthaben
Poe Plus27,36 €mit begrenztem Guthaben
Genspark for Business Team≈ 42,63 €mit begrenztem Guthaben, für Teams, je Nutzer
Warp Business≈ 53,29 €mit begrenztem Guthaben, für Teams, je Nutzer
Mindverse Studio Team58,31 €für Teams, je Nutzer
Poe Pro68,41 €mit begrenztem Guthaben
Mindverse Studio Pro70,21 €je Nutzer
Token Plan Individual ProAlibaba Cloud (Qwen)≈ 72,48 €mit begrenztem Guthaben
Token Plan Team Team Pro SeatAlibaba Cloud (Qwen)≈ 79,94 €mit begrenztem Guthaben, für Teams, je Nutzer
Command Code Max 10×≈ 106,58 €mit begrenztem Guthaben
Poe Advanced136,84 €mit begrenztem Guthaben
Command Code Max 20×≈ 213,17 €mit begrenztem Guthaben
Token Plan Team Team Max SeatAlibaba Cloud (Qwen)≈ 213,17 €mit begrenztem Guthaben, für Teams, je Nutzer
Warp Max≈ 213,17 €
Genspark Pro≈ 266,45 €mit begrenztem Guthaben
Poe Max342,11 €mit begrenztem Guthaben
Genspark for Business Enterprisek. A.mit begrenztem Guthaben, für Unternehmen, je Nutzer
Warp Enterprisek. A.für Unternehmen

Geschätzte Europreise zum EZB-Kurs vom 06.11.2026.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu DeepSeek-V4.1-Flash

Wie gut ist DeepSeek-V4.1-Flash in Benchmarks?

Ordentlich: Platz 29 von 91 im Gesamtindex.

Gesamtindex (Gradually Meta-Score v4) aus 35 Benchmark-Ergebnissen · Daten bis 06.11.2026

LeistungGesamtindex in Punkten, 100 = Durchschnitt der Referenzgruppe · höher ist besser
GPT-5.6 Terra100,7
GLM-5.3100,7
Qwen 3.8 Max 0902100,3
DeepSeek-V4.1-FlashPlatz 2999,7
Claude Opus 4.899,0
MiMo V2.6 Flash98,3
Step 5 Preview97,3

Was ist der Gesamtindex (Gradually Meta-Score v4)?

Ein Punktwert, der viele unabhängige Benchmarks zu einer Zahl zusammenfasst. 100 Punkte sind der Durchschnitt einer festen Referenzgruppe, höher ist besser. DeepSeek-V4.1-Flash erreicht 99,7 Punkte, das ist Platz 29 von 91.

Eigene Auswertung von gradually.ai, Methode benchmark-meta-score-v4 · für DeepSeek-V4.1-Flash aus 35 Testreihen

Welche Daten
Nur aktuelle, geprüfte Ergebnisse unabhängiger Auswerter wie Artificial Analysis, Vals AI, LMArena, LiveBench und Epoch AI. Herstellerangaben sowie historische und strittige Werte zählen nicht.
Ein Wert je Test
Je Quelle und Testreihe zählt der neueste Abruf mit einem festen Aufbau. Testet eine Quelle mehrere Reasoning-Stufen, gilt die höchste dokumentierte. Eine Testreihe braucht mindestens 5 Modelle.
Vergleichbar machen
Prozentwerte werden so umgerechnet, dass Abstände nahe 0 und nahe 100 % fair zählen, danach wird jede Testreihe auf dieselbe Skala gebracht. So wiegt ein schwerer Test nicht mehr als ein leichter.
Gemeinsame Stärke
Ein statistisches Modell schätzt aus allen Testreihen zugleich eine gemeinsame Leistungsfähigkeit je Modell und je Bereich, wie stark ein Modell davon abweicht. Fehlende Tests werden nicht als null gezählt.
Gewichtung
Kernbereiche (Programmieren, Schlussfolgern, Mathematik, Wissen, Agenten, Allgemein und Multimodal) zählen zusammen 75 %, die Fachbereiche Finanzen, Recht und Gesundheit zusammen 25 %.
Die Punkteskala
Der Wert misst sich an einer festen Referenzgruppe aus 29 Modellen, ähnlich wie ein IQ-Wert: 100 Punkte sind ihr Durchschnitt, 15 Punkte eine Standardabweichung der Gruppe. Die Skala ist nach oben und unten offen und kein Prozentwert. Liegt ein Modell 15 Punkte vorn, schneidet es in etwa drei von vier Benchmark-Vergleichen besser ab. Neue Modelle verschieben die alten Werte nicht.
Platz nach Score
Der Platz folgt der Reihenfolge der Scores unter allen Modellen mit Platz, etwa „Platz 14 von 95“. Ob ein Vorsprung belastbar ist, prüft eine zweite Rechnung, die den Score 200-mal mit zufällig neu gezogenen Testfamilien wiederholt. Liegt ein Modell dabei nicht fast immer vorn, gelten zwei Modelle als gleichauf.
Mindestanforderung
Einen Wert gibt es erst ab 8 Testreihen aus 2 Quellen und 3 Bereichen, einen Platz nur bei ausreichender Genauigkeit. Fehlen Kernbereiche, steht der Hinweis „geschätzt“ dabei.
Was er nicht ist
Kein eigener Test von gradually.ai und kein Urteil über jede einzelne Aufgabe. Für eine bestimmte Aufgabe zählen die Bereichswerte und die einzelnen Benchmarks mehr.

Was kostet DeepSeek-V4.1-Flash?

Per API 0,15 $ je 1 Mio. Token Eingabe und 0,60 $ Ausgabe. Das ist günstig.

Preise vom 06.11.2026

Preis für die Ausgabe seit Beginn der MessungDollar je 1 Mio. Token · niedriger ist besser

23.09.202606.11.2026

Erster Preis am 23.09.2026: 1 $. Seit 12.10.2026: 1 $.

Wie groß ist das Kontextfenster von DeepSeek-V4.1-Flash?

1 Mio. Token. So viel Text liest DeepSeek-V4.1-Flash auf einmal, das sind rund 1.500 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GPT-5.6 Terra1,05 Mio.
GPT-5.51,05 Mio.
Gemini 3.5 Flash1,05 Mio.
DeepSeek-V4.1-FlashPlatz 31 von 1011 Mio.
Qwen 3.8 Max 09021 Mio.
Claude Opus 4.81 Mio.
GLM-5.31 Mio.

Wie schnell ist DeepSeek-V4.1-Flash?

176 Token pro Sekunde. Das ist schneller als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
DeepSeek-V4.1-FlashPlatz 14 von 100176
Step 5 Preview132
GPT-5.6 Terra100
Claude Opus 4.882
GLM-5.363
Qwen 3.8 Max 090246
MiMo V2.6 Flash35

Kann ich DeepSeek-V4.1-Flash lokal nutzen?

Ja, die Gewichte sind offen. Mit 552 Mrd. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von DeepSeek

Offene Gewichte
ja
Lizenz
MIT
Parameter
552 Mrd.
davon aktiv je Token
k. A.

Wo kann ich DeepSeek-V4.1-Flash nutzen?

Nicht im Abo von DeepSeek. Zusammen mit anderen Anbietern sind es 28 Tarife in Deutschland, dazu kommt die API.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei DeepSeek

Kein Abo von DeepSeek mit diesem Modell.

Über andere Anbieter

28 Tarife bei 6 Anbietern, ab ≈ 1,07 € im Monat (Command Code Go), mit begrenztem Guthaben.

Per API

0,15 $ Eingabe, 0,60 $ Ausgabe je 1 Mio. Token laut Anbieter; im Preisindex steht das Modell seit 26.09.2026 mit 0,30 $ und 1 $.

Ist DeepSeek-V4.1-Flash besser als DeepSeek-V4-Flash?

Für einen Vergleich im Gesamtindex gibt es zu wenig Daten. Vorn liegt es im Bereich Agenten.

DeepSeek-V4-Flash als Vorgänger laut DeepSeek-V4.1-Flash release, geprüft am 23.09.2026

LeistungGesamtindex, 100 Punkte = Durchschnitt · höher ist besser
99,7

DeepSeek-V4.1-Flash

Platz 29

k. A.

DeepSeek-V4-Flash

noch ohne Platz

TempoToken pro Sekunde · höher ist besser
176

DeepSeek-V4.1-Flash

schnell

123

DeepSeek-V4-Flash

eher schnell

PreisDollar je 1 Mio. Token, 3 Teile Eingabe und 1 Teil Ausgabe · niedriger ist besser
0,26 $

DeepSeek-V4.1-Flash

1,4-mal so teuer

0,19 $

DeepSeek-V4-Flash

günstiger

DeepSeek-V4.1-FlashDeepSeek-V4-Flash100 Punkte = Durchschnitt, höher ist besser
Programmierennur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 98,8DeepSeek-V4-Flash: zu wenig Daten
Mathematiknur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 97,3DeepSeek-V4-Flash: zu wenig Daten
AgentenDeepSeek-V4.1-Flash vornDeepSeek-V4.1-Flash: 106,4DeepSeek-V4-Flash: 83,1
Allgemeinnur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 97,1DeepSeek-V4-Flash: zu wenig Daten
Finanzennur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 103,7DeepSeek-V4-Flash: zu wenig Daten
Rechtnur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 100,8DeepSeek-V4-Flash: zu wenig Daten
Gesundheitnur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 95,5DeepSeek-V4-Flash: zu wenig Daten
Multimodalnur DeepSeek-V4.1-Flash mit WertungDeepSeek-V4.1-Flash: 95,7DeepSeek-V4-Flash: zu wenig Daten

Quellen und Datenstand

Alle 98 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis508
Vals AI283211
LMArena3042
LiveBench0045
ARC Prize0016
Scale AI Evals001

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten. 62 Messwerte sind noch keiner Testreihe zugeordnet.

ArtNachweis und Datenstand
Geschwindigkeit

Median der bereitstellenden Anbieter, Max effort. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

Preis

API-Preise außerhalb der Spitzenzeiten (Off-Peak). Zu Spitzenzeiten gelten höhere Preise. Alle Tarife und UTC-Zeitfenster stehen unter Kosten.

Eingabe

Dokumentierte Modalitäten. Abgerufen am 23. September 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 23. September 2026.

RecherchestandRecherchestand 24. September 2026. 39 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Ungeklärt

active-parameters-billions

Originalwortlaut

The card publishes two values (8B per token on prefill, 16B on decode); no single active-parameter count applies.

Nicht veröffentlicht

knowledge-cutoff

Originalwortlaut

Neither the model card nor the release post states a knowledge cutoff.

Ungeklärt

NL2Repo-Bench score discrepancy

Hinweis

Der bestehende Eintrag der Modellkarte nennt 64,0, während eine separate offizielle Release-Notiz 65,4 berichtet. Die neue Beobachtung mit 65,4 ist als strittig markiert; Evaluierungsdatum, Score-Einheit und Konfiguration dieses Werts sind nicht offengelegt.

Nicht veröffentlicht

reasoning effort and pass@k

Hinweis

Das zitierte Ergebnis nennt weder Reasoning-Aufwand noch pass@k; das genaue Aufgabendatum sowie Angaben zu Bereitstellung und Checkpoint stehen in der Benchmark-Konfiguration.

Nicht veröffentlicht

DeepSeek V4.1 Flash vendor benchmark run metadata

Hinweis

Die Modellkarte nennt für Instruct-Ergebnisse reasoning_effort=100, temperature=1.0 und top_p=0.95, legt aber weder Aufgabendaten noch zeilenspezifische Einheiten oder alle Harness-Einstellungen offen.

Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 2. November 2026; 6. November 2026)1234
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026)12345678910
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 2. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 29. Oktober 2026; 2. November 2026; 6. November 2026)
Weitere QuelleLMArena (abgerufen 30. Oktober 2026)123
Weitere QuelleLMArena (abgerufen 28. Oktober 2026)12
Weitere QuelleLMArena (abgerufen 16. Oktober 2026)123
Weitere QuelleVals AI (abgerufen 6. November 2026)1234567891011121314151617181920212223242526
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 6. November 2026)1234
Weitere QuelleVals AI (abgerufen 16. Oktober 2026)12
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 31. Oktober 2026; 6. November 2026)
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 30. Oktober 2026; 31. Oktober 2026)
Weitere QuelleDeepSeek V4.1 Flash model card (abgerufen 24. September 2026)
Weitere QuelleDeepSeek official release notes (abgerufen 15. Oktober 2026)
Weitere QuelleLlamaIndex / Run-Llama ExtractBench (abgerufen 15. Oktober 2026)
Weitere QuelleLiveBench (abgerufen 16. Oktober 2026; 18. Oktober 2026) (am 2. November 2026 nicht abrufbar) https://livebench.ai/table_2026_09_02.csv
Weitere QuelleLiveBench (abgerufen 16. Oktober 2026) (am 2. November 2026 nicht abrufbar) https://livebench.ai/breakdown_2026_09_02.json
Weitere QuelleARC Prize Verified results (abgerufen 17. Oktober 2026)
Weitere QuelleBizBench (abgerufen 17. Oktober 2026)
Weitere QuelleAgenticBBO-Bench (abgerufen 17. Oktober 2026)
Weitere QuelleDeepSeek official API changelog, V4.1 Flash-1017 update (abgerufen 18. Oktober 2026) · DeepSeek API changelog · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 18. Oktober 2026)
Weitere QuelleLlamaIndex ParseBench, shown in the official DeepSeek Hugging Face model-page Eval Results section (abgerufen 20. Oktober 2026)
Weitere QuelleServeLearnBench paper, arXiv:2610.07792v1 (abgerufen 21. Oktober 2026)
Weitere QuelleCao et al. (Mine Odyssey) (abgerufen 22. Oktober 2026)
Weitere QuelleDeepSeek-AI, DeepSeek-V4.1-Flash model card (abgerufen 22. Oktober 2026)
Weitere QuelleMachine Spirituality (abgerufen 23. Oktober 2026)
Weitere QuelleForcebench (abgerufen 23. Oktober 2026)
Weitere QuelleForcebench (abgerufen 24. Oktober 2026)
Weitere QuelleDuelLab GameBench 2 model results (abgerufen 28. Oktober 2026; 2. November 2026; 5. November 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 28. Oktober 2026; 5. November 2026)
Weitere QuelleTowards AI ToneBench (abgerufen 28. Oktober 2026; 30. Oktober 2026)1234
Weitere QuelleGoogle DeepMind on Kaggle (abgerufen 28. Oktober 2026)
Weitere QuelleScale AI DistressBench (abgerufen 28. Oktober 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 5. November 2026)
Weitere QuelleAlman Institut (abgerufen 6. November 2026)
Weitere QuelleModellmetadaten (abgerufen 24. September 2026) · DeepSeek V4.1 lifecycle notice · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleModellmetadaten (abgerufen 24. September 2026)
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0
Weitere QuelleDeepSeek V4.1 Flash 1017 release (2026-10-24)