Claude Sonnet 5
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Sonnet 5 | DeepSeek-V4.1-Flash |
|---|---|---|
| Anbieter | Anthropic | DeepSeek |
| Erschienen | 30. Juni 2026 | 10. Sept. 2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 552 Mrd. |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1.000.000 Token | 1.000.000 Token |
| Wissensstand | Januar 2026 | Nicht veröffentlicht |
| Technische Quellen | Modell, Kontext | Modell |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Sonnet 5 | DeepSeek-V4.1-Flash |
|---|---|---|
| API-Eingabe | 2 $ | 0,15 $ (Off-Peak) |
| API-Ausgabe | 10 $ | 0,6 $ (Off-Peak) |
| Cache lesen | 0,2 $ | 0,003 $ (Off-Peak) |
| Cache schreiben (5 Min.) | 2,5 $ | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | 4 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 23.09.2026 Quelle |
| DeepSeek-V4.1-Flash: Spitzenpreise sind 0,3 $ Eingabe / 1,2 $ Ausgabe pro 1 Mio. Token während Mo, Di, Mi, Do, Fr, 01:00-04:00 UTC; Mo, Di, Mi, Do, Fr, 06:00-10:00 UTC; zu allen anderen Zeiten gelten Off-Peak-Preise. | ||
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Sonnet 5 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/eu-west-1 | 2,2 $ | 11 $ | Quelle15.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/global | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle15.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 2,2 $ | 11 $ | Quelle15.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle15.10.2026 | |
| Azure | Über OpenRouterazure/us | 2,2 $ | 11 $ | Quelle15.10.2026 | |
| Claude Platform on AWS | Über OpenRouterclaude-on-aws | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle15.10.2026 | |
| Über OpenRoutergoogle-vertex/europe | 2,2 $ | 11 $ | Quelle15.10.2026 | ||
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle15.10.2026 | ||
| Über OpenRoutergoogle-vertex/us | 2,2 $ | 11 $ | Quelle15.10.2026 | ||
| DeepSeek-V4.1-Flash | DeepSeek | Direkt beim EntwicklerStandard-API | 0,15 $ | 0,6 $ | Quelle23.09.2026 |
| Alibaba | Über OpenRouteralibaba | 0,15 $ | 0,6 $ | Quelle15.10.2026 | |
| AtlasCloud | Über OpenRouteratlas-cloud/fp8 | 0,192 $ | 0,768 $ | Quelle15.10.2026 | |
| Baidu | Über OpenRouterbaidu/fp8 | 0,1497 $ | 0,5988 $ | Quelle15.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fast | 0,6 $ | 2,4 $ | Quelle15.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp32 | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp8 | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| Cloudflare | Über OpenRoutercloudflare | 0,1 $ | 0,9 $ | Quelle15.10.2026 | |
| CoreWeave | Über OpenRoutercoreweave/fp8 | 0,15 $ | 0,65 $ | Quelle15.10.2026 | |
| Crusoe | Über OpenRoutercrusoe/fp8 | 0,29 $ | 1,2 $ | Quelle15.10.2026 | |
| Decart | Über OpenRouterdecart/fp4 | 0,09 $ | Günstigster erfasster Preis: 0,18 $ | Quelle15.10.2026 | |
| DeepInfra | Über OpenRouterdeepinfra/fp8 | 0,14 $ | 0,42 $ | Quelle15.10.2026 | |
| DeepSeek | Über OpenRouterdeepseek | 0,15 $ | 0,6 $ | Quelle15.10.2026 | |
| DigitalOcean | Über OpenRouterdigitalocean | 0,165 $ | 0,66 $ | Quelle15.10.2026 | |
| Fireworks | Über OpenRouterfireworks/us | 0,45 $ | 1,8 $ | Quelle15.10.2026 | |
| GMICloud | Über OpenRoutergmicloud/fp8 | 0,18 $ | 0,72 $ | Quelle15.10.2026 | |
| InferenceNet | Über OpenRouterinference-net/fp8 | 0,1 $ | 0,66 $ | Quelle15.10.2026 | |
| Ionstream | Über OpenRouterionstream | 0,27 $ | 1,1 $ | Quelle15.10.2026 | |
| Makora | Über OpenRoutermakora/fp8 | 0,27 $ | 1,15 $ | Quelle15.10.2026 | |
| Modal | Über OpenRoutermodal | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| Morph | Über OpenRoutermorph/fp8 | 0,022 $ | 0,6 $ | Quelle15.10.2026 | |
| Novita | Über OpenRouternovita/fp8 | 0,195 $ | 0,78 $ | Quelle15.10.2026 | |
| OpenInference | Über OpenRouteropen-inference/fp4 | Günstigster erfasster Preis: 0,0158 $ | 0,891 $ | Quelle15.10.2026 | |
| Parasail | Über OpenRouterparasail/fp8 | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| Phala | Über OpenRouterphala | 0,21 $ | 0,84 $ | Quelle15.10.2026 | |
| PrimeIntellect | Über OpenRouterprimeintellect | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| Relace | Über OpenRouterrelace | 0,0176 $ | 0,6 $ | Quelle15.10.2026 | |
| Sail Research | Über OpenRoutersail-research/fp4 | 0,09 $ | 0,3 $ | Quelle15.10.2026 | |
| SiliconFlow | Über OpenRoutersiliconflow/fp8 | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| StreamLake | Über OpenRouterstreamlake/fp8 | 0,147 $ | 0,588 $ | Quelle15.10.2026 | |
| Venice | Über OpenRoutervenice/fp8 | 0,3 $ | 1,2 $ | Quelle15.10.2026 | |
| Wafer | Über OpenRouterwafer | 0,11 $ | 0,99 $ | Quelle15.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
21 passende Messreihen aus 20 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 11 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Sonnet 5 | DeepSeek-V4.1-Flash | Quelle |
|---|---|---|---|
Code MigrationOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 44,392 % | Gewinner45,623 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
CyberBench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser | 61,905 % | Gewinner73,69 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
EMBOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner66,316 % | 57,208 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Finance Agent (v2)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser | Gewinner53,909 % | 53,481 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besser | 5 % | Gewinner6,667 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
IOIOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser | Gewinner45 % | 40,278 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Legal Research BenchOverall · All-passTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besser | Gewinner41,827 % | 41,346 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
LegalBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner83,922 % | 83,277 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
MedCodeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner47,54 % | 41,173 % | Vals AIQuellendetailsDatenstand: 26.09.2026 |
MedScribeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 76,054 % | Gewinner85,5 % | Vals AIQuellendetailsDatenstand: 26.09.2026 |
ProofBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner77 % | 54 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Public Benefits Bench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner66,035 % | 64,276 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
SAGEOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner48,925 % | 47,88 % | Vals AIQuellendetailsDatenstand: 26.09.2026 |
SkillsBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands | 46,476 % | Gewinner69,802 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Tax Agent BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 62,273 % | Gewinner62,458 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Terminal-Bench 2.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besser | Gleichstand74,532 % | Gleichstand74,532 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Terminal-Bench 4.0OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besser | 8,081 % | Gewinner11,616 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Terminal-Bench ScienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besser | 2,857 % | Gewinner4,286 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Vals IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: weighted index scoreBewertung: Mehr ist besser | Gewinner59,61 % | 57,86 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Vibe Code Bench 1-100OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands | 13,822 % | Gewinner16,378 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Vibe Code Bench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands | 81,325 % | Gewinner84,739 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
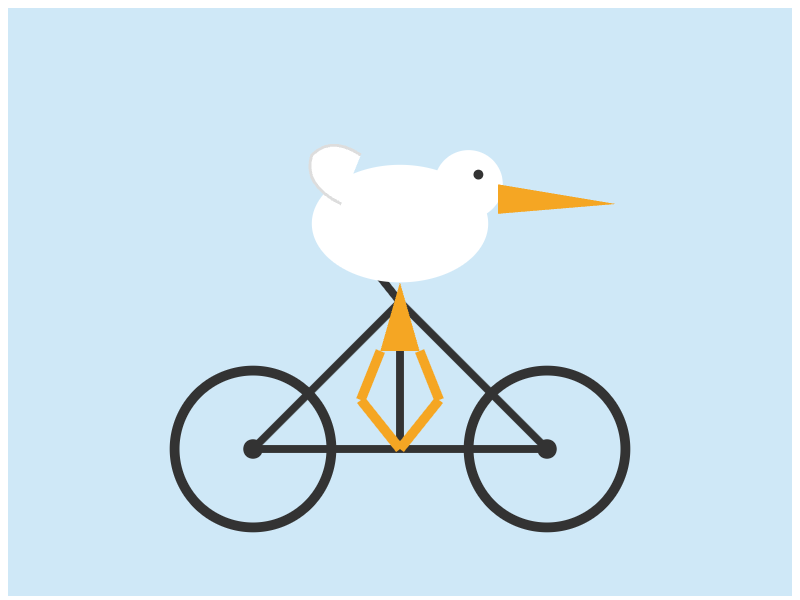
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Sonnet 5
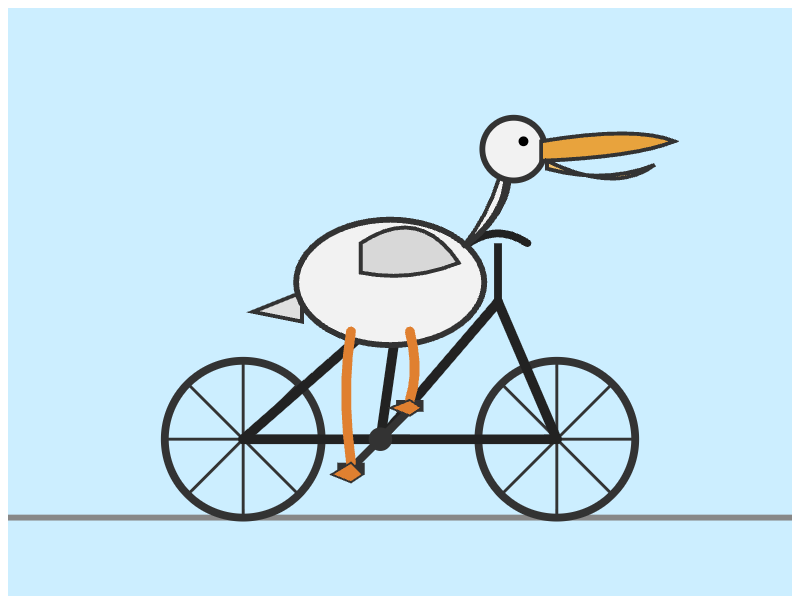
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
DeepSeek-V4.1-Flash
Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Sonnet 5 und DeepSeek-V4.1-Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.