
GPT-6 Astra
In dieser Runde nicht verfügbar
OpenAI
Mit GPT-6 Astra führte OpenAI in Codex eine experimentelle Form des Langzeitkontexts ein. Das Modell kann Notizen über mehrere Kontextfenster behalten und frühere Nachrichten oder Werkzeugergebnisse durchsuchen. Bei langen Debugging-Aufgaben müssen damit weniger Details wiederholt in eine einzige Zusammenfassung verdichtet werden.
OpenAI stuft Astra in seinem Preparedness Framework bei Cybersecurity als Critical ein. Der Hersteller verbindet die erweiterten Fähigkeiten deshalb mit zusätzlichen Schutzmaßnahmen und begrenzt bestimmte Sicherheitsaufgaben. GPT-6.1 Sol kommt Astra in mehreren Coding- und Arbeitstests nahe, während Astra laut OpenAI bei besonders schwieriger wissenschaftlicher Arbeit vorne bleibt.
Der Auswahlindex des LLM-Vergleichshubs mittelt Rangperzentile aus 10 dokumentierten Vergleichskohorten. Die Benchmark-Meta-Scores stehen im Benchmarkbereich.
Benchmark-Metaanalyse
Diese Gradually-Indizes ordnen ausgewählte veröffentlichte Messwerte auf einer Skala von 0 bis 100 ein. Sie sind keine Prozentgenauigkeit und keine Garantie für ein Ergebnis in deiner Anwendung.
Abrufstände der verwendeten Quellen 2026-10-15 - 2026-10-19
Index 71,9 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 88,6 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 91,8 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 93,2 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 97,2 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 85,6 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 64,9 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 77,0 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Methodenfassung: benchmark-meta-score-v1
Es zählen aktive Messwerte aus geprüften Primärquellen, wenn mindestens fünf Modelle im selben dokumentierten Vergleichsschnitt aus Datensatz, Harness, Agent, Werkzeugen und Versuchsanzahl verglichen werden. Pro Benchmark-Reihe und Auswerter zählt ein gemeinsamer Setup-Schnitt aus dem neuesten Abruf; bei gleichem Datum wird der breitere Schnitt verwendet. Bei mehreren ausdrücklich erfassten Reasoning-Stufen derselben Quelle und Testreihe zählt die höchste dokumentierte Stufe (none bis max), nicht der höchste Ergebniswert. Die ausdrückliche Quellenangabe „Non-reasoning“ entspricht none. Bei dieser Auswahl zwischen mehreren Ergebnissen führen unbekannte oder mehrdeutige Stufen zum Ausschluss des Modells aus der betreffenden Reihe. Eindeutige Einzelkonfigurationen benötigen keine Stufenreihenfolge. Das jeweils beste Einzelergebnis eines Modells wird nicht ausgewählt. Rangperzentile mit gleichen Rohwerten teilen sich dasselbe Perzentil. Mehrere Reihen desselben Auswerters innerhalb einer Testfamilie werden gleich gewichtet, danach werden Auswerter in der Testfamilie, Testfamilien im Bereich und Bereiche im Gesamtindex jeweils gleich gewichtet. Nicht gemessene Reihen bleiben in Abdeckung und Grenzen sichtbar. Ein Gesamtwert erfordert mindestens vier Bereiche, sechs Testfamilien und zwei Quellen. Ein Bereichswert erfordert mindestens zwei Testfamilien. Jeder Gesamt- und Bereichsscore benötigt außerdem mindestens 50 % des jeweiligen Panelgewichts.
Veröffentlichte modellabhängige Parameter können abweichen. Das ist kein kontrolliertes Experiment; solche Vergleiche werden als vorläufig gekennzeichnet.
Nicht gemessene Anteile werden nicht als Nullwert eingesetzt. Sie senken die Abdeckung und fließen nur in die ausgewiesenen Grenzen ein. Werte aus unterschiedlichen Abdeckungen sind daher nicht unmittelbar gleich vollständig.
Die Grenzen halten die vorhandenen Perzentile fest und setzen für fehlende Beiträge beliebige Werte von 0 bis 100 an. Sie sind keine Konfidenzintervalle und keine Prognose für spätere Neuberechnungen.
Die Quellenzahl ist keine Anzahl unabhängiger Experimente.
OECD-Handbuch zu zusammengesetzten IndikatorenAlle 41 Testfamilien und 12 von 45 Rohmesswerten sind hier aufgeführt. Die vollständige Rechnung für alle Modelle enthält der JSON-Export.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 7,14 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 83 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 7,14 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 3,57 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Jeder Auswerter misst andere Fähigkeiten unter eigenen Bedingungen. Testreihen, Gesamtindizes und ihre Komponenten bleiben getrennt. Die Ergebnisse darunter behalten ihre Skalen, Konfigurationen und Quelldaten.
| Auswerter | Testreihen | Gesamtindizes | Erfasste aktive Messwerte |
|---|---|---|---|
| Artificial Analysis | 13 | 1 | 64 |
| Vals AI | 25 | 1 | 189 |
| LMArena | 4 | 0 | 42 |
| Epoch AI | 6 | 0 | 11 |
Die Abdeckung ist keine Qualitätsrangliste. Überschneidende Tests und mehrere Einstellungen zählen nicht als unabhängige Versuche. Herstellerangaben, historische und strittige Ergebnisse bleiben außerhalb dieser Übersicht und sind in den Detailbelegen gekennzeichnet.
Seite 1 von 30
Overall
Langfristige Softwareaufgaben mit ausführbaren Projekttests. Modell, Reasoning-Stufe und Agent gehören gemeinsam zum Ergebnis. Die Herstellertabelle enthält abweichende Werte.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
113 Aufgaben in 91 Repositorys und fünf Sprachen. Reasoning max. Meta nennt Datacurve als Evaluator; diese Muse-Werte waren auf dessen öffentlicher Rangliste beim Abruf nicht auffindbar. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
Programme aus einer Spezifikation rekonstruieren. Einheitlicher mini-swe-agent, saubere Umgebung ohne Internet nach dem Start. Anteil der Läufe mit mindestens 95 % bestandenen Tests, Reasoning max. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
Geschäftsabläufe in einer simulierten Anwendungsumgebung. Jede Endzustandsprüfung muss bestehen, Reasoning max. Nicht mit anderen AutomationBench-AA-Metriken vermischen. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
108 Desktop-Arbeitsabläufe auf Ubuntu. Vollständige Aufgabenerfüllung ohne Teilpunkte, Reasoning max. Kein veröffentlichter binärer Opus-5.5-Wert. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
108 Desktop-Arbeitsabläufe auf Ubuntu. Teilpunkte, Reasoning max. Der Opus-5.5-Wert ist laut Meta eine Anthropic-Angabe. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
Finanzrecherche anhand von Unternehmensunterlagen und Marktdaten. Privates Testset, Reasoning max. Von Meta wiedergegebene Vals-Werte. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
Berufliche Arbeit mit bereitgestellten PDF-Unterlagen. Reasoning max. Meta nennt Surge als ursprüngliche Quelle. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 Punkte - 34,2 Punkte
Overall
65 berufliche Aufgaben aus 35 Berufen. Mittlerer aufgabenspezifischer Reward, Reasoning max. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 Punkte - 75,4 Punkte
Overall
Juristische Arbeitsergebnisse, alle Kriterien einschließlich Halluzinationsprüfung müssen erfüllt sein. Reasoning max. Meta nennt Artificial Analysis als ursprünglichen Evaluator. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Overall
525 Gesundheitsfragen ohne Werkzeuge, ärztliche Bewertungsraster mit GPT-5.4 als Bewerter. Reasoning max. Die Claude-Werte stammen laut Meta aus Anthropics Modellkarten. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 Punkte - 65,6 Punkte
Overall
Interner Meta-Test mit 64K-100K Token langen Gesprächen, Ablenkungen sowie widersprüchlichen oder aktualisierten Gesprächsteilen. Reasoning max. Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Hinweis (GPT-6 Astra): Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Hinweis: Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 Punkte - 85,6 Punkte
Seite 1 von 30
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-6 Astra
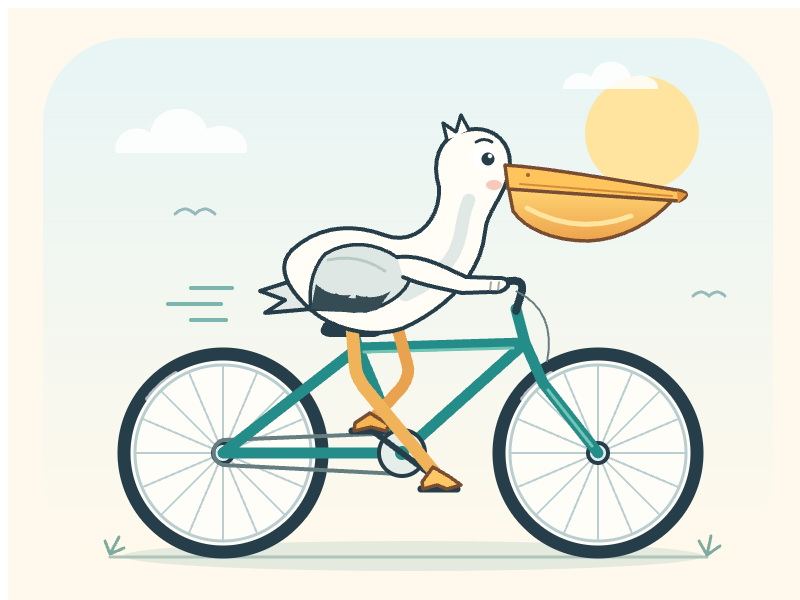
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)76,6 / 100
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Zugang | APIQuelle |
| Kontextfenster | 1.050.000 TokenQuelle |
| Knowledge Cutoff | 30. April 2026Quelle |
| Hinweise | Neues OpenAI-Spitzenmodell mit 1,05 Millionen Token Kontext, 128.000 Token maximaler Ausgabe und Knowledge Cutoff am 30. April 2026. Der Zugang wird seit dem 3. September 2026 schrittweise freigeschaltet. Seit dem 22. September 2026 ergänzen GPT-6 Sol und GPT-6 Luna die Familie als günstigere Stufen.Quelle |
| API-Modellkennung | gpt-6-astraQuelle |
| Veröffentlichung | 2026-09-03Quelle |
| Maximale Ausgabe | 128.000 TokenQuelle |
| Eingabe | Text, BildQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | low, medium, high, xhigh, maxQuelle |
| API-Schnittstellen | Responses API, Chat Completions APIQuelle |
| Werkzeugaufrufe | JaQuelle |
| Strukturierte Ausgabe | JaQuelle |