GPT-6.1 Sol
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|
| Anbieter | OpenAI | OpenAI |
| Erschienen | 29. Sept. 2026 | 3. Sept. 2026 |
| Verfügbarkeit | Aktiv | Eingeschränkter Zugang |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.050.000 Token | 1.050.000 Token |
| Wissensstand | 30. April 2026 | 30. April 2026 |
| Technische Quellen | Modell, Kontext | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|
| API-Eingabe | 2 $ ≤272K / 4 $ >272K | 10 $ ≤272K / 20 $ >272K |
| API-Ausgabe | 10 $ ≤272K / 15 $ >272K | 50 $ ≤272K / 75 $ >272K |
| Cache lesen | 0,1 $ ≤272K / 0,2 $ >272K | 1 $ ≤272K / 2 $ >272K |
| Cache schreiben (5 Min.) | 2,5 $ ≤272K / 5 $ >272K | 12,5 $ ≤272K / 25 $ >272K |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 29.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Für GPT-6.1 Sol ist im gespeicherten OpenRouter-Stand kein Anbietertarif verfügbar. Der offizielle Direktpreis wird trotzdem angezeigt.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| GPT-6.1 Sol | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | Günstigster erfasster Preis: 2 $ | Günstigster erfasster Preis: 10 $ | Quelle29.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 4 $ | 15 $ | Quelle29.09.2026 | |
| GPT-6 Astra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 10 $ | 50 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 20 $ | 75 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-west-2 | 11 $ | 55 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure | 10 $ | 50 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/us | 11 $ | 55 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai | 10 $ | 50 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 20 $ | 100 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai/ultrafast | 60 $ | 300 $ | Quelle17.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
251 passende Messreihen aus 34 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 13 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | GPT-6.1 Sol | GPT-6 Astra | Quelle |
|---|---|---|---|
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.503,6 elo | Gewinner1.546,7 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 79,7 % | Gewinner80,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 40,867 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Gewinner43,417 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 51,038 Punkte | Gewinner52,386 Punkte | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 66,6 % | Gewinner67,2 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
BioMysteryBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens | Gewinner79,63 % | 79,259 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 65,122 % | Gewinner67,74 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 39,286 % | Gewinner41,072 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 70,773 % | Gewinner71,7 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 52,033 % | Gewinner53,54 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 31,8 % | Gewinner32,2 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.538,05 elo | Gewinner1.555,91 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gleichstand5,417 % | Gleichstand5,417 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 52,6 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Gewinner54,6 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
IOIOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 96,889 % | Gewinner100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchOverall · All-passTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 38,462 % | Gewinner39,423 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevGPT-6.1 Sol: Arena-Bewertung aus 2.592 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen. | 1.760,088 95-%-Konfidenzintervall: ±13,918Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Kein klarer Vorsprung1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena SearchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: searchMessgröße: Search Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Search GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena SearchGPT-6.1 Sol: Arena-Bewertung aus 5.555 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 18.483 veröffentlichten Paarvergleichen. | 1.233,102 95-%-Konfidenzintervall: ±8,861Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Kein klarer Vorsprung1.233,616 95-%-Konfidenzintervall: ±7,842Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlGPT-6.1 Sol: Arena-Bewertung aus 5.762 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 11.674 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.483,959 95-%-Konfidenzintervall: ±8,383Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.476,716 95-%-Konfidenzintervall: ±6,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlGPT-6.1 Sol: Arena-Bewertung aus 1.813 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 3.590 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.294,052 95-%-Konfidenzintervall: ±14,414Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.285,988 95-%-Konfidenzintervall: ±10,782Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gewinner48,839 % | 48,486 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 86,453 % | Gewinner87,908 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MysteryMechanismOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 46,396 % | Gewinner53,153 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProgramBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 3 % | Gewinner5,5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProofBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gleichstand99 % | Gleichstand99 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Robo-benchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Compute: max, Harness: codex | Gewinner28,333 % | 23,333 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6.1 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert46,538 % | 46,367 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SRE BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 50,763 % | Gewinner56,87 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
SWE-bench MultimodalOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gewinner43,542 % | 43,333 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Tax Agent BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gewinner21,754 % | 20,717 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: Task successBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (Xhigh) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-xhigh, UUID 092a3b0e-c5c8-45dc-bf1b-53673c8ff352, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 54,0 % | Gewinner59,6 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Terminal-Bench 4.0OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 55,051 % | Gewinner59,596 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | 52,857 % | Gewinner62,857 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 61,154 % | Gewinner63,125 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | 88,931 % | Gewinner89,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.466,4 elo | Gewinner1.507,08 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner82,3 % | 80,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 41,45 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Gewinner43,733 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 50,238 Punkte | Gewinner50,919 Punkte | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 64,5 % | Gewinner66,6 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
BioMysteryBenchHardTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens | Gewinner39,216 % | 37,255 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 63,496 % | Gewinner67,463 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PatchTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 78,571 % | Gewinner82,143 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBCompsTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 61,788 % | Gewinner77,953 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 44,717 % | Gewinner48,318 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner32,0 % | 31,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.511,35 elo | Gewinner1.522,92 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gewinner89,493 % | 88,768 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 51,4 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Gewinner53,1 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
IOIIOI 2024TestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gleichstand100 % | Gleichstand100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | Gleichstand53,03 % | Gleichstand53,03 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevGPT-6.1 Sol: Arena-Bewertung aus 1.430 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 2.739 veröffentlichten Paarvergleichen. | 1.703,464 95-%-Konfidenzintervall: ±17,054Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Kein klarer Vorsprung1.731,395 95-%-Konfidenzintervall: ±13,296Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlGPT-6.1 Sol: Arena-Bewertung aus 911 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 2.061 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.483,743 95-%-Konfidenzintervall: ±19,566Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.472,34 95-%-Konfidenzintervall: ±13,336Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: gpt-6.1-sol-max, Reasoning: max, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlGPT-6.1 Sol: Arena-Bewertung aus 431 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 861 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.311,21 95-%-Konfidenzintervall: ±28,641Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.310,509 95-%-Konfidenzintervall: ±20,739Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
ProgramBenchAlmost ResolvedTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 46 % | Gewinner50 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Robo-benchArm (13 tasks)TestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Compute: max, Harness: codex | Gewinner50,769 % | 42,308 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6.1 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert40,476 % | 37,302 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SRE BenchCapability ScoreTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: capability scoreBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 56,298 % | Gewinner63,868 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
SWE-bench Multimodalbpmn-jsTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 60,377 % | Gewinner62,264 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 6,667 % | Gewinner13,333 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: Task successBewertung: Mehr ist besserGPT-6.1 Sol: Snapshot: GPT-6.1 Sol (High), Reasoning: High GPT-6 Astra: Snapshot: GPT-6 Astra (High), Reasoning: HighGPT-6.1 Sol: Exakte AA-Konfiguration: GPT-6.1 Sol (High) (Release gpt-6-1-sol, Zeile gpt-6-1-sol-high, UUID 3b84fee3-b70a-41bc-819e-5fbdef9a0042, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (High) (Release gpt-6-astra, Zeile gpt-6-astra-high, UUID e05a4828-0536-4876-870d-a235023f992b, reasoning=true, source reasoning-token configuration budget=0, suffix=High). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 51,5 % | Gewinner54,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Terminal-Bench 4.0HardwareTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 40 % | Gewinner60 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceEarth SciencesTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | Gleichstand62,5 % | Gleichstand62,5 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexCode MigrationTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserEinstellungen: Reasoning: max, Ausgabegrenze: 128.000 tokens | 63,309 % | Gewinner68,462 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-6.1 Sol
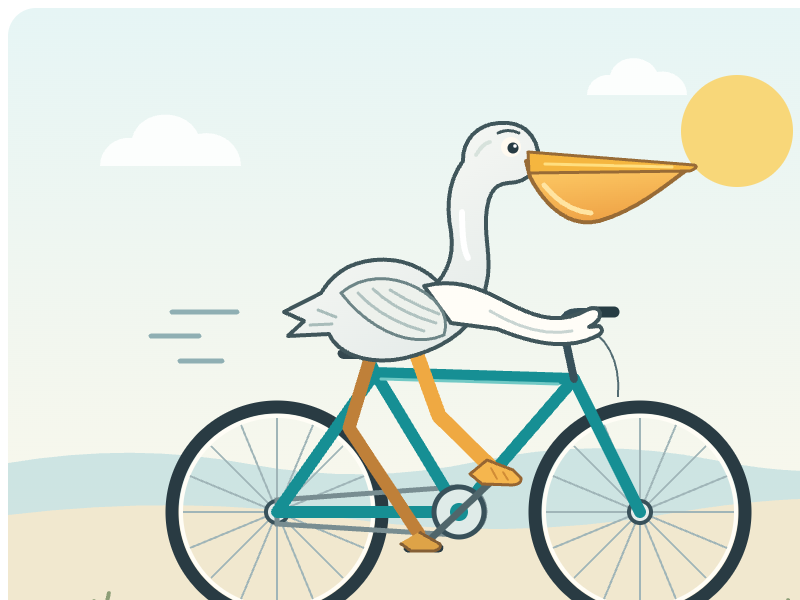
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-6 Astra
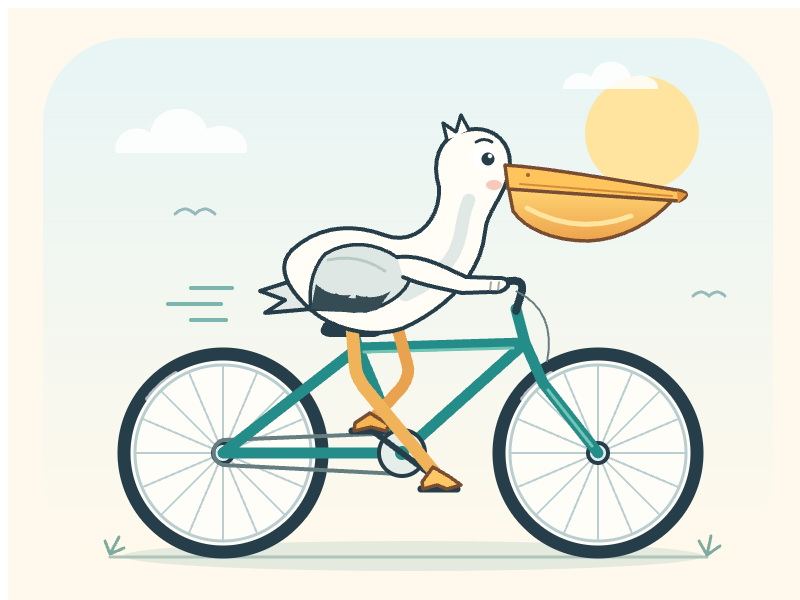
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche GPT-6.1 Sol und GPT-6 Astra mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.