Zum Hauptinhalt springen

OpenAIGoogleLLM-Duell

GPT-6.1 Solvs.Gemini 3.8 Flash

Wer ist besser?

GPT-6.1 Sol schneidet besser als Gemini 3.8 Flash ab, aber kostet 2,7-mal so viel.

GPT-6.1 Sol vorn
LeistungGesamtindex, 100 Punkte = Durchschnitt
117,5

GPT-6.1 Sol

Platz 9

106,4

Gemini 3.8 Flash

Platz 20

Gemini 3.8 Flash schneller
TempoToken pro Sekunde
54

GPT-6.1 Sol

74

Gemini 3.8 Flash

Gemini 3.8 Flash günstiger
Preis$ je 1 Mio. Token
4 $

GPT-6.1 Sol

1,50 $

Gemini 3.8 Flash

Beliebtheit0 bis 100
k. A.

GPT-6.1 Sol

88

Gemini 3.8 Flash

Platz 1 von 485

Ab 272.000 Token im Kontext kostet GPT-6.1 Sol mehr: 4 $ Eingabe und 15 $ Ausgabe je 1 Mio. Token.

Nimm GPT-6.1 Sol für

MathematikProgrammierenAllgemeinBildungWissenAgentenSchlussfolgernGesundheitMultimodaleher Recht

Nimm Gemini 3.8 Flash für

Produktivitäteher Finanzen

Wo liegt der Unterschied?

Stärken im Überblick

GPT-6.1 SolGemini 3.8 FlashMedian aller Modelle mit Platz

10011012013090ProgrammierenGPT-6.1 SolSchlussfolgernGPT-6.1 SolMathematikGPT-6.1 SolWissenGPT-6.1 SolAgentenGPT-6.1 SolAllgemeinGPT-6.1 SolMultimodalGPT-6.1 SolFinanzenleicht Gemini3.8 FlashRechtleichtGPT-6.1 SolGesundheitGPT-6.1 Sol
ProgrammierenGPT-6.1 Sol vorn
GPT-6.1 Sol120,6Platz 8
Gemini 3.8 Flash99,9Platz 32
Median aller Modelle mit Platz87,5

95-%-Bereich: GPT-6.1 Sol 113,7 bis 127,5, Gemini 3.8 Flash 97,2 bis 102,6.

BereichGPT-6.1 SolGemini 3.8 Flash

Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 90 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100.

GPT-6.1 Sol liegt in 8 von 10 Bereichen vorn, Gemini 3.8 Flash in keinem.

GPT-6.1 Sol vorn: 8GPT-6.1 Sol leicht vorn: 1Gemini 3.8 Flash leicht vorn: 1

Bereiche im Gesamtindex
MathematikGPT-6.1 Sol +24124,1 zu 99,9
ProgrammierenGPT-6.1 Sol +21120,6 zu 99,9
AllgemeinGPT-6.1 Sol +16119,0 zu 102,9
WissenGPT-6.1 Sol +11123,7 zu 113,1
AgentenGPT-6.1 Sol +9112,0 zu 103,0
SchlussfolgernGPT-6.1 Sol +9122,7 zu 114,1
MultimodalGPT-6.1 Sol +6118,0 zu 112,1
Fachgebiete
GesundheitGPT-6.1 Sol +9110,2 zu 101,6
Finanzeneher Gemini 3.8 Flashnicht sicher · 5 und 7 Tests
Rechteher GPT-6.1 Solnicht sicher · 3 und 4 Tests

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

4 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
BildungGPT-6.1 Sol +14119,9 zu 106,0
ProduktivitätGemini 3.8 Flash +3100,7 zu 103,7
Cybersicherheitzu wenig Daten93,0 zu 85,7
Suchenur GPT-6.1 Sol mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

GPT-6.1 Sol gegen Gemini 3.8 Flash auf gleicher Stufe

Beide Modelle auf denselben Stufen gemessen. So zeigt sich, ob ein Vorsprung vom Modell kommt oder nur von mehr Rechenaufwand.

lowgleichauf
1,2 Punkte Abstand über 3 gemeinsame Testreihen
mediumGPT-6.1 Sol vorn
12,5 Punkte Abstand über 12 gemeinsame Testreihen
highGPT-6.1 Sol vorn
15,0 Punkte Abstand über 12 gemeinsame Testreihen
Gesamtindex (max gegen high)GPT-6.1 Sol vorn
GPT-6.1 Sol 117,5 gegen Gemini 3.8 Flash 106,4

Der Abstand vergleicht nur die Testreihen von Artificial Analysis, in denen beide Modelle auf dieser Stufe gemessen sind. Gleichauf unter 3 Punkten, vorn erst bei einem Abstand über zwei Standardfehlern.

Welches Modell für welche Aufgabe?

Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.

Code schreiben und Fehler findenGPT-6.1 SolProgrammieren 120,6 zu 99,9
Mathe und DatenanalyseGPT-6.1 SolMathematik 124,1 zu 99,9, Schlussfolgern 122,7 zu 114,1
Fakten und RechercheGPT-6.1 SolWissen 123,7 zu 113,1, Suche ohne Wertung für Gemini 3.8 Flash
Agenten und WorkflowsGPT-6.1 SolAgenten 112,0 zu 103,0
Schnelle Antworten im ChatGemini 3.8 Flash54 zu 74 Token pro Sekunde
SicherheitsanalysenoffenCybersicherheit 93,0 zu 85,7 (zu wenig Daten)
Viele Anfragen, kleines BudgetGemini 3.8 Flash4 $ zu 1,50 $ je 1 Mio. Token
Finanz-, Rechts- und Medizintexteje nach TeilbereichFinanzen 105,8 zu 111,8, Recht 107,0 zu 101,3, Gesundheit 110,2 zu 101,6
Bilder, Screenshots und PDFsGPT-6.1 SolMultimodal 118,0 zu 112,1

GPT-6.1 Sol gegen Gemini 3.8 Flash im eigenen Test

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

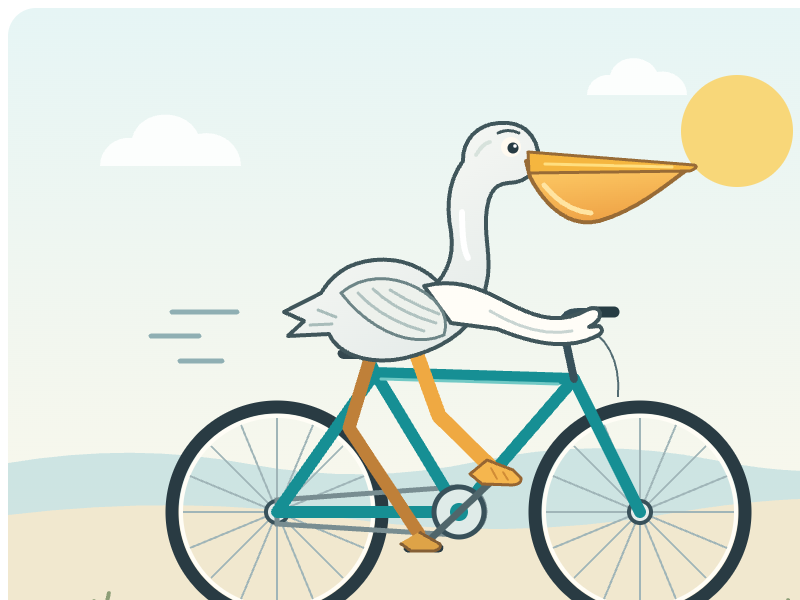
Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

Ursprung der Aufgabe: Simon Willison

GPT-6.1 Sol

GPT-6.1 Sol: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

01.10.2026 · 84 s · 0,04 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-6.1-sol
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
3.583 Token
Kosten des Versuchs
0,0359 $
Antwortzeit
83,6 s
API-Modell laut Antwort
openai/gpt-6.1-sol
Festgelegter Endpunkt
OpenAI | openai/gpt-6.1-sol-20260929
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Gemini 3.8 Flash

Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.

05.10.2026 · 40 s · 0,03 $

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
05.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
google/gemini-3.8-flash
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
8.188 Token
Kosten des Versuchs
0,0307 $
Antwortzeit
40,2 s
API-Modell laut Antwort
google/gemini-3.8-flash
Festgelegter Endpunkt
Google AI Studio | google/gemini-3.8-flash-20260902
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden

Frühere Versuche (3)

  • 02.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

GPT-6.1 Sol

In dieser Runde nicht verfügbar

Gemini 3.8 Flash

In dieser Runde nicht verfügbar

GPT-6.1 Sol und Gemini 3.8 Flash im Gesamtindex

Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.

Gesamtindex (Gradually Meta-Score v5)

20 von 95 Modellen

Claude Fable 5.2max130,9
Gemini 4 Carbonhigh127,0
Claude Opus 5.5max125,7
Claude Fable 5.1max124,1
Claude Sonnet 5.5max121,9
Gemini 4 Argonhigh121,2
GPT-6 Astramax119,6
Muse Wonder Fullmax118,4
GPT-6.1 Solmax117,5
Claude Opus 5max117,3
Muse Wondermax113,7
Claude Fable 5max112,8
Kimi K3.1 Promax112,6
Muse Ember 1.0max110,5
GPT-5.6 Solmax109,3
GPT-6 Solmax108,4
Gemini 3.7 Flashhigh107,7
DeepSeek V4.1 Flash 1017max107,1
GPT-6.1 Terramax106,5
Gemini 3.8 Flashhigh106,4

Beliebtheit im Vergleich

Wie oft die Modelle gesucht, genutzt und erwähnt werden, auf einer Skala von 0 bis 100.

Für GPT-6.1 Sol gibt es noch keinen Beliebtheitswert.

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 14. November 2026

GPT-6.1 SolGemini 3.8 Flash

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlGPT-6.1 SolGemini 3.8 Flash
Leistung
GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser117,5106,4
PlatzPlatz 9 von 95Platz 20 von 95
Preis je 1 Mio. Token
Eingabewas du schickst2 $über 272.000 Token: 4 $0,75 $
Ausgabewas das Modell schreibt10 $über 272.000 Token: 15 $3,75 $
Kosten je Aufgabe (eigene Tests)Durchschnitt aus 2 Aufgaben des ursprünglichen Testprotokolls, die beide Modelle bestanden haben (ohne SVG-Kurztest)0,047 $0,044 $
Tempo
Token pro Sekunde5474
Beliebtheit
BeliebtheitSuche, Nutzung und Erwähnungen, 0 bis 100k. A.88Platz 1 von 485
Technik
Kontextfensterwie viel Text das Modell auf einmal liest1,05 Mio. Token≈ 1.580 A4-Seiten1,05 Mio. Token≈ 1.570 A4-Seiten
Wissensstand30.04.2026März 2026
Veröffentlicht29.09.202602.09.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinnein

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gibt es eine bessere Wahl?

Günstiger als Gemini 3.8 FlashMuse Ember 1.0

Gesamtindex 110,5, Platz 140,10 $ Eingabe und 0,50 $ Ausgabe je 1 Mio. Token

Zum Profil
Bestes Modell im GesamtindexClaude Fable 5.2

Gesamtindex 130,9, Platz 18 $ Eingabe und 40 $ Ausgabe je 1 Mio. Token

GPT-6.1 Sol vs. Claude Fable 5.2

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: GPT-6.1 SolB: Gemini 3.8 Flash

AA-BriefcaseOverall · höher ist besserGPT-6.1 Sol: 1.468,5 eloGemini 3.8 Flash: 1.203,0 eloArtificial AnalysisStand 07.11.2026
AA-OmniscienceOverall · höher ist besserGPT-6.1 Sol: 41,0 PunkteGemini 3.8 Flash: 23,3 PunkteArtificial AnalysisStand 07.11.2026
AA-Omniscience AccuracyOverall · höher ist besserGPT-6.1 Sol: 60,4 %Gemini 3.8 Flash: 50,5 %Artificial AnalysisStand 07.11.2026
AA-Omniscience Hallucination RateOverall · niedriger ist besserGPT-6.1 Sol: 49,0 %Gemini 3.8 Flash: 55,1 %Artificial AnalysisStand 07.11.2026
Access to Justice BenchmarkOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 65,8 %Gemini 3.8 Flash: 67,1 %Vals AIStand 10.11.2026
AutomationBench-AAOverall · höher ist besserGPT-6.1 Sol: 64,5 %Gemini 3.8 Flash: 59,9 %Artificial AnalysisStand 07.11.2026
BioMysteryBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 79,6 %Gemini 3.8 Flash: 62,2 %Vals AIStand 05.11.2026
Code MigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 65,1 %Gemini 3.8 Flash: 36,5 %Vals AIStand 29.10.2026
Code Migration v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 77,3 %Gemini 3.8 Flash: 38,6 %Vals AIStand 30.10.2026
CritPt v2 (Hard Subset)Overall · höher ist besserGPT-6.1 Sol: 68,5 %Gemini 3.8 Flash: 46,5 %Artificial AnalysisStand 07.11.2026
54 weitere Benchmarks anzeigen
CyberBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 39,3 %Gemini 3.8 Flash: 43,8 %Vals AIStand 05.11.2026
EMBOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 70,8 %Gemini 3.8 Flash: 72,2 %Vals AIStand 20.10.2026
EMB v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 71,1 %Gemini 3.8 Flash: 72,9 %Vals AIStand 05.11.2026
Finance Agent (v2)Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 52,0 %Gemini 3.8 Flash: 61,4 %Vals AIStand 29.10.2026
Finance Agent v2.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 61,8 %Gemini 3.8 Flash: 65,8 %Vals AIStand 05.11.2026
Financial Coaching BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 68,5 %Gemini 3.8 Flash: 66,3 %Vals AIStand 13.11.2026
FrontierCodeOverall · höher ist besserGPT-6.1 Sol: 36,7 %Gemini 3.8 Flash: 18,7 %Artificial AnalysisStand 07.11.2026
FrontierCode 1.1 MainOverall · höher ist besserGPT-6.1 Sol: 46,6 %Gemini 3.8 Flash: 36,4 %Artificial AnalysisStand 07.11.2026
GDP.pdfOverall · höher ist besserGPT-6.1 Sol: 32,0 %Gemini 3.8 Flash: 21,0 %Artificial AnalysisStand 07.11.2026
GDPval-AAOverall · höher ist besserGPT-6.1 Sol: 1.520,5 eloGemini 3.8 Flash: 1.445,4 eloArtificial AnalysisStand 07.11.2026
HLAB-Vals-1.1Overall · Task fully resolved · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 6,3 %Gemini 3.8 Flash: 12,1 %Vals AIStand 05.11.2026
HLE-DiamondOverall · höher ist besserGPT-6.1 Sol: 51,9 %Gemini 3.8 Flash: 33,1 %Artificial AnalysisStand 07.11.2026
ImmigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 67,8 %Gemini 3.8 Flash: 63,4 %Vals AIStand 28.10.2026
IOIOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 96,9 %Gemini 3.8 Flash: 56,9 %Vals AIStand 29.10.2026
Legal Research BenchOverall · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 38,5 %Gemini 3.8 Flash: 38,9 %Vals AIStand 05.11.2026
LMArena Code Arena WebDevOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 1.743Gemini 3.8 Flash: 1.583LMArenaStand 11.11.2026
LMArena Text, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 1.481Gemini 3.8 Flash: 1.497LMArenaStand 11.11.2026
LMArena Vision, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 1.293Gemini 3.8 Flash: 1.293LMArenaStand 09.11.2026
MedCodeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 48,8 %Gemini 3.8 Flash: 48,1 %Vals AIStand 29.10.2026
MedScribeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 86,5 %Gemini 3.8 Flash: 84,5 %Vals AIStand 29.10.2026
MMMU-ProOverall · höher ist besserGPT-6.1 Sol: 84,9 %Gemini 3.8 Flash: 85,6 %Artificial AnalysisStand 07.11.2026
MysteryMechanismOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 46,4 %Gemini 3.8 Flash: 36,5 %Vals AIStand 29.10.2026
ProgramBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 3 %Gemini 3.8 Flash: 1 %Vals AIStand 05.11.2026
ProofBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 99 %Gemini 3.8 Flash: 48 %Vals AIStand 29.10.2026
Public Benefits Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 59,3 %Gemini 3.8 Flash: 65,3 %Vals AIStand 12.10.2026
SAGEOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 90,5 %Gemini 3.8 Flash: 88,2 %Vals AIStand 05.11.2026
SRE BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 50,8 %Gemini 3.8 Flash: 11,1 %Vals AIStand 05.11.2026
SWE-bench MultimodalOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 43,5 %Gemini 3.8 Flash: 40,8 %Vals AIStand 05.11.2026
Tax Agent BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 21,8 %Gemini 3.8 Flash: 32,1 %Vals AIStand 05.11.2026
Terminal-BenchOverall · höher ist besserGPT-6.1 Sol: 51,5 %Gemini 3.8 Flash: 19,7 %Artificial AnalysisStand 07.11.2026
Terminal-Bench 4.0Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 55,1 %Gemini 3.8 Flash: 19,7 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 52,9 %Gemini 3.8 Flash: 8,6 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceOverall · höher ist besserGPT-6.1 Sol: 46,2 %Gemini 3.8 Flash: 10,0 %Artificial AnalysisStand 07.11.2026
Vals Finance IndexOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 55,8 %Gemini 3.8 Flash: 60,5 %Vals AIStand 05.11.2026
Vals IndexOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 63,9 %Gemini 3.8 Flash: 56,0 %Vals AIStand 05.11.2026
Vals Legal IndexOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 68,7 %Gemini 3.8 Flash: 69,8 %Vals AIStand 05.11.2026
Vals Router IndexFull Index · höher ist besserGPT-6.1 Sol: 63,9 %Gemini 3.8 Flash: 56,0 %Vals AIStand 03.11.2026
Vals Science IndexOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 59,6 %Gemini 3.8 Flash: 35,8 %Vals AIStand 25.10.2026
Vibe Code Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 88,9 %Gemini 3.8 Flash: 78,7 %Vals AIStand 05.11.2026
BioMysteryBenchHard · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 39,2 %Gemini 3.8 Flash: 21,6 %Vals AIStand 05.11.2026
Code MigrationCLI · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 63,5 %Gemini 3.8 Flash: 25,9 %Vals AIStand 29.10.2026
Code Migration v1.1CLI · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 74,8 %Gemini 3.8 Flash: 27,6 %Vals AIStand 30.10.2026
CyberBench v1.1Patch · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 78,6 %Gemini 3.8 Flash: 87,5 %Vals AIStand 05.11.2026
EMBComps · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 61,8 %Gemini 3.8 Flash: 76,4 %Vals AIStand 20.10.2026
EMB v1.1Comps · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 61,2 %Gemini 3.8 Flash: 76,0 %Vals AIStand 05.11.2026
Finance Agent (v2)Adjustments · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 44,7 %Gemini 3.8 Flash: 54,8 %Vals AIStand 29.10.2026
Finance Agent v2.1Adjustments · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 54,7 %Gemini 3.8 Flash: 61,9 %Vals AIStand 05.11.2026
Financial Coaching BenchElicitation · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 59,5 %Gemini 3.8 Flash: 54,0 %Vals AIStand 13.11.2026
HLAB-Vals-1.1Antitrust Competition · Criteria passed · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 90,8 %Gemini 3.8 Flash: 92,9 %Vals AIStand 05.11.2026
ImmigrationAll-Pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 22,5 %Gemini 3.8 Flash: 16,4 %Vals AIStand 28.10.2026
IOIIOI 2024 · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 100,0 %Gemini 3.8 Flash: 55,7 %Vals AIStand 29.10.2026
Legal Research BenchAdministrative / Regulatory · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 53 %Gemini 3.8 Flash: 47 %Vals AIStand 05.11.2026
LMArena Code Arena WebDevHTML development · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 1.794Gemini 3.8 Flash: 1.608LMArenaStand 11.11.2026
LMArena Text, Style ControlBusiness, management and finance · höher ist besserTestaufbau nicht identisch dokumentiertGPT-6.1 Sol: 1.480Gemini 3.8 Flash: 1.485LMArenaStand 11.11.2026

Weitere Vergleiche

Vergleiche GPT-6.1 Sol und Gemini 3.8 Flash mit den Modellen, die am häufigsten mit ihnen verglichen werden.

Anderes Duell vergleichen

Die beliebtesten Vergleiche

  1. 1Claude Sonnet 5.5 vs. Gemini 3.8 Flash
  2. 2Claude Opus 5.5 vs. Gemini 3.8 Flash
  3. 3Gemini 3.8 Flash vs. DeepSeek-V4.1-Flash
  4. 4Claude Opus 4.6 vs. Gemini 3.8 Flash
  5. 5GPT-6 Luna vs. Gemini 3.8 Flash
  6. 6Claude Sonnet 4.6 vs. Gemini 3.8 Flash
  7. 7Gemini 3.8 Flash vs. Gemini 3.5 Flash-Lite
  8. 8Gemini 3.8 Flash vs. Gemini 3.1 Pro Preview
  9. 9GPT-6 Sol vs. Gemini 3.8 Flash
Alle 80 Vergleiche zeigen
  1. 10Gemini 3.8 Flash vs. GLM-5.3-Flash
  2. 11Claude Haiku 5.5 vs. Gemini 3.8 Flash
  3. 12GPT-5.6 Sol vs. Gemini 3.8 Flash
  4. 13Gemini 3.8 Flash vs. Grok 4.7
  5. 14GPT-6.1 Sol vs. GPT-5.6 Sol
  6. 15GPT-6.1 Terra vs. Gemini 3.8 Flash
  7. 16Claude Opus 5 vs. Gemini 3.8 Flash
  8. 17GPT-5.6 Luna vs. Gemini 3.8 Flash
  9. 18Gemini 3.8 Flash vs. DeepSeek-V4-Flash
  10. 19Gemini 3.8 Flash vs. DeepSeek V4.1 Flash 1017
  11. 20Gemini 3.8 Flash vs. DeepSeek-V4-Pro
  12. 21Gemini 3.8 Flash vs. Qwen 3.8 27B
  13. 22GPT-6.1 Sol vs. GPT-6.1 Terra
  14. 23Gemini 4 Carbon vs. Gemini 3.8 Flash
  15. 24Claude Sonnet 4.5 vs. Gemini 3.8 Flash
  16. 25Gemini 3.8 Flash vs. Gemini 3.6 Flash
  17. 26GPT-6 Astra vs. Gemini 3.8 Flash
  18. 27Gemini 3.8 Flash vs. Grok 4.6
  19. 28Gemini 3.8 Flash vs. GLM-5.3
  20. 29GPT-6.1 Sol vs. GPT-6 Astra
  21. 30Gemini 3.8 Flash vs. GLM-5.2
  22. 31Gemini 3.8 Flash vs. Muse Spark 1.3
  23. 32Claude Sonnet 5 vs. Gemini 3.8 Flash
  24. 33GPT-5.4 mini vs. Gemini 3.8 Flash
  25. 34GPT-6.1 Sol vs. GPT-5.6 Terra
  26. 35Gemini 3.8 Flash vs. Mistral Large 4
  27. 36Gemini 3.8 Flash vs. Kimi K3.1 Pro
  28. 37Claude Fable 5 vs. Gemini 3.8 Flash
  29. 38Gemini 3.8 Flash vs. MiMo-V2.5-Pro
  30. 39GPT-5.5 vs. Gemini 3.8 Flash
  31. 40Claude Opus 5.5 vs. GPT-6.1 Sol
  32. 41Claude Sonnet 5.5 vs. GPT-6.1 Sol
  33. 42Claude Opus 4.8 vs. Gemini 3.8 Flash
  34. 43Claude Haiku 4.5 vs. Gemini 3.8 Flash
  35. 44GPT-6.1 Sol vs. GLM-5.3-Flash
  36. 45GPT-6.1 Sol vs. GPT-6 Luna
  37. 46GPT-6.1 Sol vs. Gemini 4 Carbon
  38. 47GPT-6.1 Sol vs. DeepSeek-V4.1-Flash
  39. 48Claude Opus 4.8 vs. GPT-6.1 Sol
  40. 49GPT-6.1 Sol vs. Gemini 4 Argon
  41. 50GPT-6.1 Sol vs. Kimi K3.1 Pro
  42. 51GPT-6.1 Sol vs. DeepSeek-V4-Flash
  43. 52GPT-6.1 Sol vs. GPT-5.4 mini
  44. 53GPT-6.1 Sol vs. GPT-5.4
  45. 54GPT-6.1 Sol vs. DeepSeek V4.1 Flash 1017
  46. 55GPT-6.1 Sol vs. Qwen 3.8 Max 0902
  47. 56Claude Sonnet 4.6 vs. GPT-6.1 Sol
  48. 57Claude Opus 4.6 vs. GPT-6.1 Sol
  49. 58GPT-6.1 Sol vs. GPT-5.6 Luna
  50. 59Gemini 4 Argon vs. Gemini 3.8 Flash
  51. 60Claude Sonnet 5 vs. GPT-6.1 Sol
  52. 61Claude Opus 5 vs. GPT-6.1 Sol
  53. 62GPT-6.1 Sol vs. GPT-5.5
  54. 63Claude Haiku 5.5 vs. GPT-6.1 Sol
  55. 64GPT-6.1 Sol vs. Grok 4.7
  56. 65Claude Sonnet 4.5 vs. GPT-6.1 Sol
  57. 66GPT-6.1 Sol vs. Gemini 3.5 Flash
  58. 67Claude Opus 4.7 vs. GPT-6.1 Sol
  59. 68GPT-6.1 Sol vs. GLM-5.3
  60. 69Claude Fable 5.2 vs. GPT-6.1 Sol
  61. 70GPT-6.1 Sol vs. Gemini 3.7 Flash
  62. 71GPT-6.1 Sol vs. Qwen 3.8 27B
  63. 72Claude Fable 5.1 vs. GPT-6.1 Sol
  64. 73GPT-6.1 Sol vs. Gemini 3.1 Pro Preview
  65. 74GPT-6.1 Sol vs. Gemini 3.6 Flash
  66. 75GPT-6.1 Sol vs. Kimi K3
  67. 76Claude Fable 5 vs. GPT-6.1 Sol
  68. 77GPT-6.1 Sol vs. DeepSeek-V4-Pro
  69. 78GPT-6.1 Sol vs. Muse Wonder
  70. 79Claude Haiku 4.5 vs. GPT-6.1 Sol
  71. 80Claude Opus 4.5 vs. GPT-6.1 Sol