GPT-6.1 Solvs.Kimi K3.1 Pro
Wer ist besser?
GPT-6.1 Sol liegt im Gesamtindex klar vorn, bei gleichem Preis.
GPT-6.1 Sol
Platz 6 bis 9
Kimi K3.1 Pro
Platz 10 bis 13
GPT-6.1 Sol
eher langsam
Kimi K3.1 Pro
langsam
GPT-6.1 Sol
eher teuer
Kimi K3.1 Pro
eher teuer
GPT-6.1 Sol
- Im Abo
Bei OpenAI ab 23 € im Monat (ChatGPT Plus). Über andere Anbieter ab ≈ 6,36 € im Monat (ElevenLabs Starter, mit begrenztem Guthaben). 58 Tarife in Deutschland.
- Per API
2 $ Eingabe, 10 $ Ausgabe je 1 Mio. Token.
Kimi K3.1 Pro
- Im Abo
Bei Moonshot AI ab ≈ 20,14 € im Monat (Kimi Plus, mit begrenztem Guthaben). 4 Tarife in Deutschland.
- Per API
2 $ Eingabe, 10 $ Ausgabe je 1 Mio. Token.
Gesamtindex mit Daten bis 29.10.2026 · Preise vom 29.10.2026 · Tempo: Messung von Artificial Analysis · Abos vom 24.10.2026 · Abo-Preise inkl. USt
Wo liegt der Unterschied?
Werte von 0 bis 100 je Aufgabenbereich. Einen Sieger nennen wir nur, wenn der Abstand groß genug ist und es genug Tests gibt.
GPT-6.1 Sol vorn: 5Kimi K3.1 Pro vorn: 0gleichauf: 4zu wenig Daten: 1von 10 Bereichen
4 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Selbst ansehen: gleicher Auftrag, ein Versuch
Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-6.1 Sol
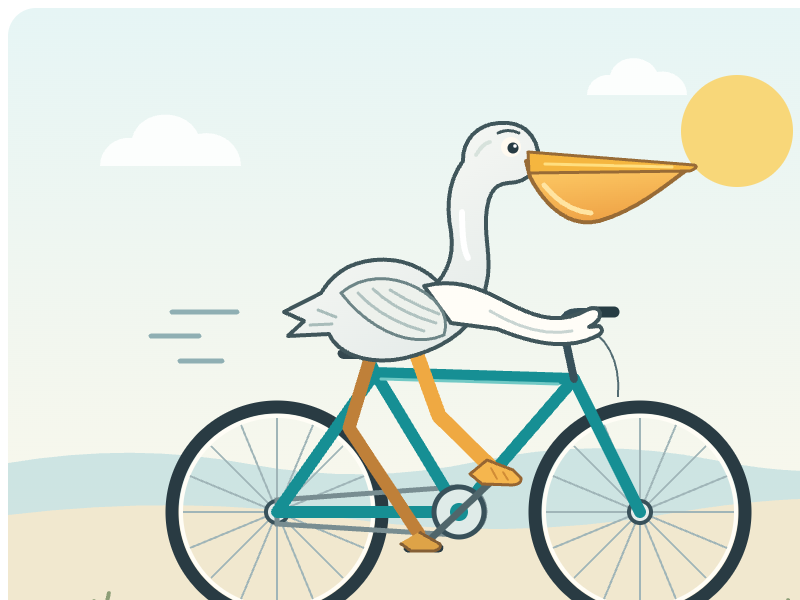
Reasoning (angefragt): high
Aktueller Versuch
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- openai/gpt-6.1-sol
- API-Modell laut Antwort
- openai/gpt-6.1-sol
- Reasoning-Einstellung
- high
- Festgelegter Endpunkt
- OpenAI | openai/gpt-6.1-sol-20260929
- Temperatur
- Anbieterstandard
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
- Antwortzeit
- 83,6 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Kimi K3.1 Pro
Noch nicht getestet
Prompt und Testbedingungen
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)SVG-Kurztest
Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.
Alle Daten im Vergleich
Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.
| Kennzahl | GPT-6.1 Sol | Kimi K3.1 Pro |
|---|---|---|
| Leistung | ||
| Gesamtindex0 bis 100, höher ist besser | 90 | 80 |
| Platz | Platz 6 bis 9 von 95 | Platz 10 bis 13 von 95 |
| Preis je 1 Mio. Token | ||
| Eingabewas du schickst | 2 $über 272.000 Token: 4 $ | 2 $ |
| Ausgabewas das Modell schreibt | 10 $über 272.000 Token: 15 $ | 10 $ |
| Tempo | ||
| Token pro Sekunde | 79 | 36 |
| Technik | ||
| Kontextfensterwie viel Text das Modell auf einmal liest | 1,05 Mio. Token≈ 1.580 A4-Seiten | 1,05 Mio. Token≈ 1.570 A4-Seiten |
| Wissensstand | 30.04.2026 | k. A. |
| Veröffentlicht | 29.09.2026 | 23.10.2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Offene Gewichte | nein | k. A. |
- Kimi K3.1 Pro, API-Preis laut Artificial Analysis: 2 US-Dollar Eingabe, 10 US-Dollar Ausgabe und 0,20 US-Dollar Cachetreffer je 1 Million Token. Die offizielle Kimi-API veröffentlicht parallel Preise in CNY. Quelle
- Kimi K3.1 Pro, Offizieller API-Preis: K3.1 Pro: 13 CNY Eingabe, 68 CNY Ausgabe, 13 CNY Cache-Schreiben und 1,30 CNY Cachetreffer je Million Token. Quelle
- Kimi K3.1 Pro, Highspeed-API-Preis: 26 CNY Eingabe, 136 CNY Ausgabe, 26 CNY Cache-Schreiben und 1,30 CNY Cachetreffer je Million Token. Quelle
- Kimi K3.1 Pro, Internationale API-Preise in USD: Die internationale Kimi-Plattform nennt je 1 Million Token 2 US-Dollar für Eingabe, 10 US-Dollar für Ausgabe, 2 US-Dollar für Cache-Schreiben und 0,20 US-Dollar für Cachetreffer. Highspeed kostet 4/20/4/0,20 US-Dollar. Geprüft am 29. Oktober 2026. Die separat dokumentierten CNY-Tarife bleiben eigene Angaben. Quelle
Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis
Gemeinsame Benchmarks
Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.
A: GPT-6.1 SolB: Kimi K3.1 Pro
54 weitere Benchmarks anzeigen
Anderes Duell vergleichen
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche GPT-6.1 Sol und Kimi K3.1 Pro mit weiteren wichtigen Modellen.