AnthropicOpenAILLM-Duell
Claude Fable 5.2vs.GPT-6.1 Sol
Wer ist besser?
Claude Fable 5.2 schneidet besser als GPT-6.1 Sol ab, aber kostet 4-mal so viel.
Claude Fable 5.2
Platz 1
GPT-6.1 Sol
Platz 9
Claude Fable 5.2
GPT-6.1 Sol
Claude Fable 5.2
GPT-6.1 Sol
Ab 272.000 Token im Kontext kostet GPT-6.1 Sol mehr: 4 $ Eingabe und 15 $ Ausgabe je 1 Mio. Token.
Nimm Claude Fable 5.2 für
Nimm GPT-6.1 Sol für
Kein klarer Vorteil
Wo liegt der Unterschied?
Stärken im Überblick
Fable 5.2GPT-6.1 Sol
Der Median aller Modelle mit Platz liegt in jedem Bereich unter 100, also in der Mitte des Netzes.
95-%-Bereich: Fable 5.2 122,0 bis 141,1, GPT-6.1 Sol 113,2 bis 127,9.
Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 100 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100. Nicht im Netz, weil ein Modell dort keinen eigenen Wert hat oder die Daten zu dünn sind: Multimodal, Gesundheit.
Fable 5.2 liegt in 6 von 10 Bereichen vorn, GPT-6.1 Sol in keinem.
Fable 5.2 vorn: 6Fable 5.2 leicht vorn: 1gleichauf: 1zu wenig Daten: 2
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
4 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
Claude Fable 5.2 gegen GPT-6.1 Sol auf gleicher Stufe
Beide Modelle auf denselben Stufen gemessen. So zeigt sich, ob ein Vorsprung vom Modell kommt oder nur von mehr Rechenaufwand.
Der Abstand vergleicht nur die Testreihen von Artificial Analysis, in denen beide Modelle auf dieser Stufe gemessen sind. Gleichauf unter 3 Punkten, vorn erst bei einem Abstand über zwei Standardfehlern.
Welches Modell für welche Aufgabe?
Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.
Claude Fable 5.2 gegen GPT-6.1 Sol im eigenen Test
Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.
Pelikan auf dem Fahrrad
Auftrag (englisches Original)
Generate an SVG of a pelican riding a bicycle
Claude Fable 5.2
Noch nicht getestet
GPT-6.1 Sol
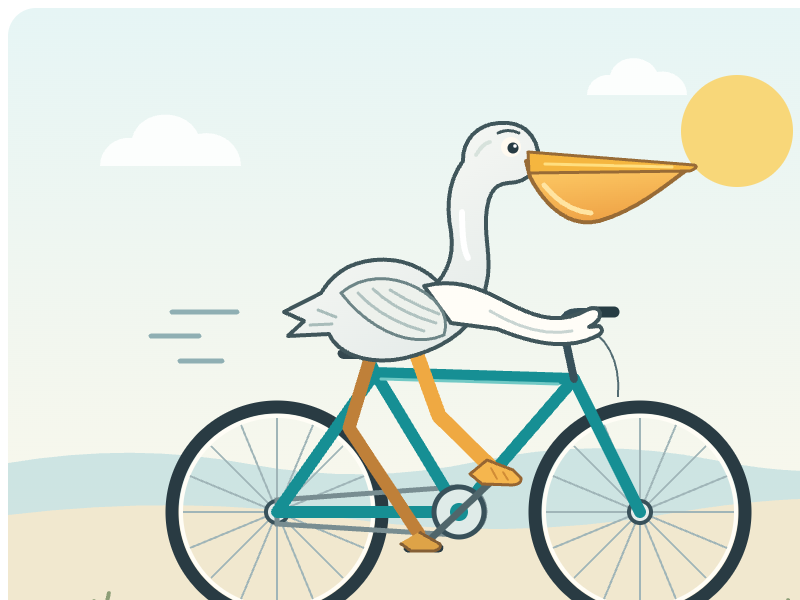
01.10.2026 · 84 s · 0,04 $
Testdetails
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- openai/gpt-6.1-sol
- Reasoning-Einstellung
- high
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Ausgabe-Token
- 3.583 Token
- Kosten des Versuchs
- 0,0359 $
- Antwortzeit
- 83,6 s
- API-Modell laut Antwort
- openai/gpt-6.1-sol
- Festgelegter Endpunkt
- OpenAI | openai/gpt-6.1-sol-20260929
- Temperatur
- Anbieterstandard
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
SVG-Kurztest
Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.
Claude Fable 5.2 und GPT-6.1 Sol im Gesamtindex
Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.
Gesamtindex (Gradually Meta-Score v5)
20 von 94 Modellen
4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.
Alle Daten im Vergleich
Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.
| Kennzahl | Claude Fable 5.2 | GPT-6.1 Sol |
|---|---|---|
| Leistung | ||
| GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser | 130,9 | 118,0 |
| Platz | Platz 1 von 94 | Platz 9 von 94 |
| Preis je 1 Mio. Token | ||
| Eingabewas du schickst | 8 $ | 2 $über 272.000 Token: 4 $ |
| Ausgabewas das Modell schreibt | 40 $ | 10 $über 272.000 Token: 15 $ |
| Tempo | ||
| Token pro Sekunde | k. A. | 44 |
| Technik | ||
| Kontextfensterwie viel Text das Modell auf einmal liest | 1 Mio. Token≈ 1.500 A4-Seiten | 1,05 Mio. Token≈ 1.580 A4-Seiten |
| Wissensstand | Juni 2026 | 30.04.2026 |
| Veröffentlicht | 09.11.2026 | 29.09.2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Offene Gewichte | nein | nein |
- Claude Fable 5.2, Batch-Preise: 4 US-Dollar für Eingabe und 20 US-Dollar für Ausgabe je 1 Mio. Token, getrennt vom regulären API-Tarif. Quelle
- Claude Fable 5.2, Fast-Preise: 16 US-Dollar für Eingabe und 80 US-Dollar für Ausgabe je 1 Mio. Token. Fast ist ein gesonderter Betriebsmodus. Quelle
Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis
Gibt es eine bessere Wahl?
Gesamtindex 121,8, Platz 52 $ Eingabe und 10 $ Ausgabe je 1 Mio. Token
Fable 5.2 vs. Claude Sonnet 5.5Gemeinsame Benchmarks
Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.
Noch kein direkt vergleichbares Ergebnis
Für Claude Fable 5.2 und GPT-6.1 Sol gibt es derzeit keinen veröffentlichten Benchmark, der in Version, Aufgabe und Messgröße übereinstimmt. Wir zeigen deshalb keine geschätzten oder vermischten Werte.
Weitere Vergleiche
Vergleiche Claude Fable 5.2 und GPT-6.1 Sol mit den Modellen, die am häufigsten mit ihnen verglichen werden.
Anderes Duell vergleichen
Vorgänger und Nachfolger
Die beliebtesten Vergleiche
- 1GPT-6.1 Sol vs. GPT-5.6 Sol
- 2GPT-6.1 Sol vs. GPT-6.1 Terra
- 3Claude Fable 5.2 vs. Kimi K3
- 4GPT-6.1 Sol vs. GPT-6 Astra
- 5GPT-6.1 Sol vs. GPT-5.6 Terra
- 6Claude Opus 5.5 vs. GPT-6.1 Sol
- 7GPT-6.1 Sol vs. Gemini 3.8 Flash
- 8Claude Sonnet 5.5 vs. GPT-6.1 Sol
- 9GPT-6.1 Sol vs. GLM-5.3-Flash
Alle 46 Vergleiche zeigen
- 10GPT-6.1 Sol vs. Gemini 4 Argon
- 11GPT-6.1 Sol vs. GPT-6 Luna
- 12GPT-6.1 Sol vs. DeepSeek-V4.1-Flash
- 13Claude Opus 4.8 vs. GPT-6.1 Sol
- 14GPT-6.1 Sol vs. DeepSeek-V4-Flash
- 15GPT-6.1 Sol vs. Qwen 3.8 Max 0902
- 16GPT-6.1 Sol vs. Kimi K3.1 Pro
- 17GPT-6.1 Sol vs. GPT-5.4 mini
- 18GPT-6.1 Sol vs. DeepSeek V4.1 Flash 1017
- 19GPT-6.1 Sol vs. GPT-5.6 Luna
- 20GPT-6.1 Sol vs. GPT-5.4
- 21Claude Opus 4.6 vs. GPT-6.1 Sol
- 22Claude Sonnet 4.6 vs. GPT-6.1 Sol
- 23Claude Opus 5 vs. GPT-6.1 Sol
- 24Claude Haiku 5.5 vs. GPT-6.1 Sol
- 25GPT-6.1 Sol vs. Gemini 4 Carbon
- 26Claude Sonnet 5 vs. GPT-6.1 Sol
- 27GPT-6.1 Sol vs. GPT-5.5
- 28Claude Opus 4.7 vs. GPT-6.1 Sol
- 29Claude Fable 5.2 vs. Claude Opus 5.5
- 30GPT-6.1 Sol vs. GLM-5.3
- 31GPT-6.1 Sol vs. Kimi K3
- 32Claude Sonnet 4.5 vs. GPT-6.1 Sol
- 33GPT-6.1 Sol vs. DeepSeek-V4-Pro
- 34GPT-6.1 Sol vs. Gemini 3.5 Flash
- 35GPT-6.1 Sol vs. Grok 4.7
- 36GPT-6.1 Sol vs. Muse Wonder
- 37GPT-6.1 Sol vs. Gemini 3.1 Pro Preview
- 38GPT-6.1 Sol vs. Muse Wonder Full
- 39GPT-6.1 Sol vs. Gemini 3.6 Flash
- 40Claude Fable 5.2 vs. Claude Haiku 5.5
- 41GPT-6.1 Sol vs. Qwen 3.8 27B
- 42Claude Fable 5.1 vs. GPT-6.1 Sol
- 43GPT-6.1 Sol vs. Gemini 3.7 Flash
- 44Claude Haiku 4.5 vs. GPT-6.1 Sol
- 45GPT-6.1 Sol vs. Kimi K2.6
- 46Claude Fable 5 vs. GPT-6.1 Sol