Zum Hauptinhalt springen

AnthropicLLM-Duell

Claude Fable 5.2vs.Claude Fable 5.1

Was hat sich verbessert?

Claude Fable 5.2 schneidet besser als Claude Fable 5.1 ab und ist günstiger: Claude Fable 5.1 kostet 1,3-mal so viel.

Fable 5.2 vorn
LeistungGesamtindex, 100 Punkte = Durchschnitt
130,9

Claude Fable 5.2

Platz 1

124,1

Claude Fable 5.1

Platz 4

TempoToken pro Sekunde
k. A.

Claude Fable 5.2

59

Claude Fable 5.1

Fable 5.2 günstiger
Preis$ je 1 Mio. Token
16 $

Claude Fable 5.2

20 $

Claude Fable 5.1

Nimm Claude Fable 5.2 für

WissenAgentenAllgemeinSchlussfolgernProgrammierenMathematik

Nimm Claude Fable 5.1 für

Recht

Wo liegt der Unterschied?

Stärken im Überblick

Fable 5.2Fable 5.1

Der Median aller Modelle mit Platz liegt in jedem Bereich unter 105, also in der Mitte des Netzes.

125145165105ProgrammierenFable 5.2SchlussfolgernFable 5.2MathematikFable 5.2WissenFable 5.2AgentenFable 5.2AllgemeinFable 5.2FinanzengleichaufRechtFable 5.1
ProgrammierenFable 5.2 vorn
Fable 5.2131,6Platz 1
Fable 5.1122,8Platz 6
Median aller Modelle mit Platz87,4

95-%-Bereich: Fable 5.2 122,0 bis 141,1, Fable 5.1 117,5 bis 128,1.

BereichFable 5.2Fable 5.1

Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 105 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100. Nicht im Netz, weil ein Modell dort keinen eigenen Wert hat oder die Daten zu dünn sind: Multimodal, Gesundheit.

Fable 5.2 liegt in 6 von 10 Bereichen vorn, Fable 5.1 in 1.

Fable 5.2 vorn: 6gleichauf: 1zu wenig Daten: 2Fable 5.1 vorn: 1

Bereiche im Gesamtindex
WissenFable 5.2 +15145,5 zu 130,1
AgentenFable 5.2 +10124,2 zu 114,0
AllgemeinFable 5.2 +10132,8 zu 122,8
SchlussfolgernFable 5.2 +9124,9 zu 116,1
ProgrammierenFable 5.2 +9131,6 zu 122,8
MathematikFable 5.2 +3135,2 zu 132,5
Multimodalnur Fable 5.1 mit Wertung
Fachgebiete
RechtFable 5.1 +10120,9 zu 130,6
Finanzengleichauf123,5 zu 121,8
Gesundheitnur Fable 5.1 mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

2 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Cybersicherheitnur Fable 5.1 mit Wertung
Produktivitätnur Fable 5.1 mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

Claude Fable 5.2 gegen Claude Fable 5.1 auf gleicher Stufe

Beide Modelle auf denselben Stufen gemessen. So zeigt sich, ob ein Vorsprung vom Modell kommt oder nur von mehr Rechenaufwand.

lowFable 5.2 vorn
13,9 Punkte Abstand über 10 gemeinsame Testreihen
mediumFable 5.2 vorn
11,6 Punkte Abstand über 10 gemeinsame Testreihen
highFable 5.2 vorn
12,5 Punkte Abstand über 10 gemeinsame Testreihen
xhighFable 5.2 vorn
10,3 Punkte Abstand über 10 gemeinsame Testreihen
maxFable 5.2 vorn
12,8 Punkte Abstand über 11 gemeinsame Testreihen
Gesamtindex (max gegen max)Fable 5.2 vorn
Fable 5.2 130,9 gegen Fable 5.1 124,1

Der Abstand vergleicht nur die Testreihen von Artificial Analysis, in denen beide Modelle auf dieser Stufe gemessen sind. Gleichauf unter 3 Punkten, vorn erst bei einem Abstand über zwei Standardfehlern.

Welches Modell für welche Aufgabe?

Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.

Code schreiben und Fehler findenFable 5.2Programmieren 131,6 zu 122,8
Mathe und DatenanalyseFable 5.2Mathematik 135,2 zu 132,5, Schlussfolgern 124,9 zu 116,1
Fakten und RechercheFable 5.2Wissen 145,5 zu 130,1
Agenten und WorkflowsFable 5.2Agenten 124,2 zu 114,0
SicherheitsanalysenoffenCybersicherheit ohne Wertung für Fable 5.2
Viele Anfragen, kleines BudgetFable 5.216 $ zu 20 $ je 1 Mio. Token
Finanz-, Rechts- und MedizintexteFable 5.1Finanzen 123,5 zu 121,8, Recht 120,9 zu 130,6, Gesundheit ohne Wertung für Fable 5.2
Bilder, Screenshots und PDFsoffenMultimodal ohne Wertung für Fable 5.2

Claude Fable 5.2 gegen Claude Fable 5.1 im eigenen Test

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

Ursprung der Aufgabe: Simon Willison

Claude Fable 5.2

Noch nicht getestet

Claude Fable 5.1
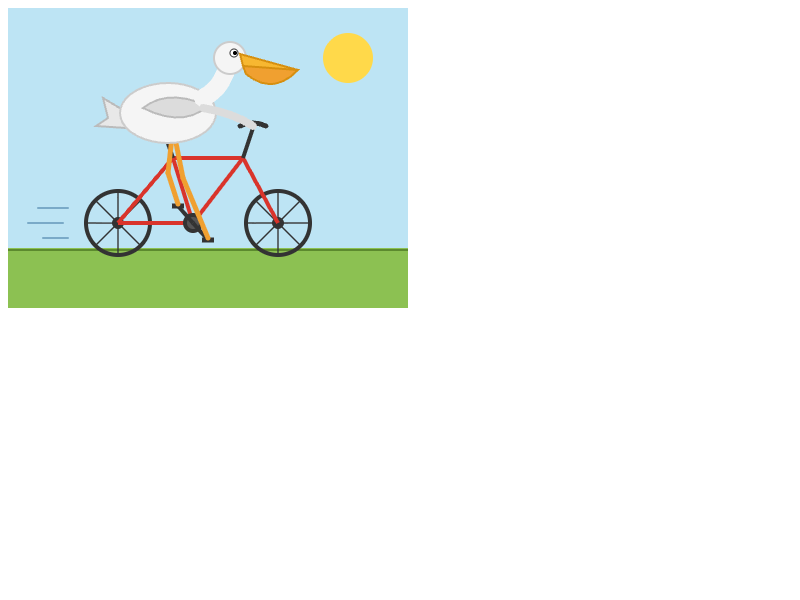
Claude Fable 5.1: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

07.09.2026 · 27 s · 0,11 $

Testdetails
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-fable-5.1
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
2.198 Token
Kosten des Versuchs
0,1102 $
Antwortzeit
27 s
API-Modell laut Antwort
anthropic/claude-fable-5.1
Festgelegter Endpunkt
Anthropic | anthropic/claude-fable-5.1-20260831
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

SVG-Kurztest

Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.

Claude Fable 5.2 und Claude Fable 5.1 im Gesamtindex

Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.

Gesamtindex (Gradually Meta-Score v5)

20 von 94 Modellen

4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

Claude Fable 5.2max130,9
Gemini 4 Carbonhigh127,0
Claude Opus 5.5max125,6
Claude Fable 5.1max124,1
Claude Sonnet 5.5max121,8
Gemini 4 Argonhigh121,4
GPT-6 Astramax120,2
Muse Wonder Fullmax118,1
GPT-6.1 Solmax118,0
Claude Opus 5max117,4
Muse Wondermax113,3
Claude Fable 5max112,8
Kimi K3.1 Promax112,6
Muse Ember 1.0max110,4
GPT-6 Solmax109,1
GPT-5.6 Solmax109,1
Gemini 3.7 Flashhigh107,9
Muse Spark 1.3max107,3
Gemini 3.8 Flashhigh106,8
DeepSeek V4.1 Flash 1017max106,7

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlClaude Fable 5.2Claude Fable 5.1
Leistung
GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser130,9124,1
PlatzPlatz 1 von 94Platz 4 von 94
Preis je 1 Mio. Token
Eingabewas du schickst8 $10 $
Ausgabewas das Modell schreibt40 $50 $
Tempo
Token pro Sekundek. A.59
Technik
Kontextfensterwie viel Text das Modell auf einmal liest1 Mio. Token≈ 1.500 A4-Seiten1 Mio. Token≈ 1.500 A4-Seiten
WissensstandJuni 2026Juni 2026
Veröffentlicht09.11.202601.09.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinnein
  • Claude Fable 5.2, Batch-Preise: 4 US-Dollar für Eingabe und 20 US-Dollar für Ausgabe je 1 Mio. Token, getrennt vom regulären API-Tarif. Quelle
  • Claude Fable 5.2, Fast-Preise: 16 US-Dollar für Eingabe und 80 US-Dollar für Ausgabe je 1 Mio. Token. Fast ist ein gesonderter Betriebsmodus. Quelle

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gibt es eine bessere Wahl?

Günstiger als Fable 5.2Claude Opus 5.5

Gesamtindex 125,6, Platz 34 $ Eingabe und 20 $ Ausgabe je 1 Mio. Token

Fable 5.2 vs. Claude Opus 5.5

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: Claude Fable 5.2B: Claude Fable 5.1

AA-BriefcaseOverall · höher ist besserClaude Fable 5.2: 1.785,3 eloClaude Fable 5.1: 1.669,5 eloArtificial AnalysisStand 10.11.2026
AA-OmniscienceOverall · höher ist besserClaude Fable 5.2: 66,8 PunkteClaude Fable 5.1: 46,3 PunkteArtificial AnalysisStand 09.11.2026
AA-Omniscience AccuracyOverall · höher ist besserClaude Fable 5.2: 79,1 %Claude Fable 5.1: 68,4 %Artificial AnalysisStand 09.11.2026
AA-Omniscience Hallucination RateOverall · niedriger ist besserClaude Fable 5.2: 59,3 %Claude Fable 5.1: 70,0 %Artificial AnalysisStand 09.11.2026
AutomationBench-AAOverall · höher ist besserClaude Fable 5.2: 76,4 %Claude Fable 5.1: 59,4 %Artificial AnalysisStand 09.11.2026
CritPt v2 (Hard Subset)Overall · höher ist besserClaude Fable 5.2: 76,5 %Claude Fable 5.1: 52,5 %Artificial AnalysisStand 09.11.2026
FrontierCodeOverall · höher ist besserClaude Fable 5.2: 48,8 %Claude Fable 5.1: 31,6 %Artificial AnalysisStand 09.11.2026
FrontierCode 1.1 MainOverall · höher ist besserClaude Fable 5.2: 56,2 %Claude Fable 5.1: 49,0 %Artificial AnalysisStand 09.11.2026
GDP.pdfOverall · höher ist besserClaude Fable 5.2: 24,2 %Claude Fable 5.1: 26,2 %Artificial AnalysisStand 09.11.2026
GDPval-AAOverall · höher ist besserClaude Fable 5.2: 1.831,3 eloClaude Fable 5.1: 1.763,3 eloArtificial AnalysisStand 10.11.2026
15 weitere Benchmarks anzeigen
HLE-DiamondOverall · höher ist besserClaude Fable 5.2: 80,2 %Claude Fable 5.1: 60,1 %Artificial AnalysisStand 09.11.2026
Tax Agent BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 32,1 %Claude Fable 5.1: 50,7 %Vals AIStand 09.11.2026
Terminal-BenchOverall · höher ist besserClaude Fable 5.2: 59,6 %Claude Fable 5.1: 52,0 %Artificial AnalysisStand 09.11.2026
Terminal-Bench-ScienceOverall · höher ist besserClaude Fable 5.2: 73,3 %Claude Fable 5.1: 43,3 %Artificial AnalysisStand 09.11.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 13,3 %Claude Fable 5.1: 33,3 %Vals AIStand 09.11.2026
Tax Agent BenchControversy & Precedence Analysis (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 58,2 %Claude Fable 5.1: 77,5 %Vals AIStand 09.11.2026
Tax Agent BenchCurrent & Temporal Analysis (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 66,0 %Claude Fable 5.1: 77,9 %Vals AIStand 09.11.2026
Tax Agent BenchFact-Pattern Analysis (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 64,5 %Claude Fable 5.1: 79,6 %Vals AIStand 09.11.2026
Tax Agent BenchForms & Filings · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 20,0 %Claude Fable 5.1: 26,7 %Vals AIStand 09.11.2026
Tax Agent BenchForms & Filings (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 60,1 %Claude Fable 5.1: 67,3 %Vals AIStand 09.11.2026
Tax Agent BenchNumbers & Calculations · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 50,0 %Claude Fable 5.1: 63,3 %Vals AIStand 09.11.2026
Tax Agent BenchNumbers & Calculations (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 86,4 %Claude Fable 5.1: 88,1 %Vals AIStand 09.11.2026
Tax Agent BenchRule & Source Lookup · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 46,7 %Claude Fable 5.1: 70,0 %Vals AIStand 09.11.2026
Tax Agent BenchRule & Source Lookup (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 68,0 %Claude Fable 5.1: 76,1 %Vals AIStand 09.11.2026
Tax Agent BenchWeighted Pass · höher ist besserTestaufbau nicht identisch dokumentiertClaude Fable 5.2: 67,0 %Claude Fable 5.1: 77,9 %Vals AIStand 09.11.2026

Weitere Vergleiche

Vergleiche Claude Fable 5.2 und Claude Fable 5.1 mit den Modellen, die am häufigsten mit ihnen verglichen werden.

Anderes Duell vergleichen

Die beliebtesten Vergleiche

  1. 1Claude Opus 5.5 vs. Claude Fable 5.1
  2. 2Claude Sonnet 5.5 vs. Claude Fable 5.1
  3. 3Claude Fable 5.2 vs. Kimi K3
  4. 4Claude Fable 5.1 vs. GPT-6 Astra
  5. 5Claude Fable 5.1 vs. GPT-5.6 Sol
  6. 6Claude Fable 5.1 vs. Grok 4.7
  7. 7Claude Fable 5.1 vs. GLM-5.3-Flash
  8. 8Claude Fable 5.1 vs. GPT-6 Luna
  9. 9Claude Fable 5.1 vs. GPT-6 Sol
Alle 22 Vergleiche zeigen
  1. 10Claude Fable 5.1 vs. Qwen 3.8 27B
  2. 11Claude Haiku 5.5 vs. Claude Fable 5.1
  3. 12Claude Fable 5.1 vs. DeepSeek V4.1 Flash 1017
  4. 13Claude Fable 5.1 vs. Claude Sonnet 4.6
  5. 14Claude Fable 5.1 vs. Claude Opus 4.6
  6. 15Claude Fable 5.1 vs. Claude Opus 4.8
  7. 16Claude Fable 5.1 vs. Mistral Large 4
  8. 17Claude Fable 5.1 vs. Gemini 4 Argon
  9. 18Claude Fable 5.1 vs. Gemini 4 Carbon
  10. 19Claude Fable 5.2 vs. Claude Opus 5.5
  11. 20Claude Fable 5.1 vs. Kimi K3.1 Pro
  12. 21Claude Fable 5.2 vs. Claude Haiku 5.5
  13. 22Claude Fable 5.1 vs. GPT-6.1 Sol