Claude Fable 5.1
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Erschienen | 1. Sept. 2026 | 3. Sept. 2026 |
| Verfügbarkeit | Aktiv | Eingeschränkter Zugang |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 1.050.000 Token |
| Wissensstand | Juni 2026 | 30. April 2026 |
| Technische Quellen | Modell | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| API-Eingabe | 10 $ | 10 $ ≤272K / 20 $ >272K |
| API-Ausgabe | 50 $ | 50 $ ≤272K / 75 $ >272K |
| Cache lesen | 0,25 $ | 1 $ ≤272K / 2 $ >272K |
| Cache schreiben (5 Min.) | 12,5 $ | 12,5 $ ≤272K / 25 $ >272K |
| Cache schreiben (1 Std.) | 20 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle19.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle19.10.2026 | |
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle19.10.2026 | ||
| GPT-6 Astra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 10 $ | 50 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 20 $ | 75 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-west-2 | 11 $ | 55 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure | 10 $ | 50 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure/us | 11 $ | 55 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai | 10 $ | 50 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 20 $ | 100 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/ultrafast | 60 $ | 300 $ | Quelle19.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
55 passende Messreihen aus 17 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 12 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Fable 5.1 | GPT-6 Astra | Quelle |
|---|---|---|---|
AutomationBench-AA (strict pass@1)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: strict pass@1; every end-state assertion passedBewertung: Mehr ist besserEinstellungen: Reasoning: maxGeschäftsabläufe in einer simulierten Anwendungsumgebung. Jede Endzustandsprüfung muss bestehen, Reasoning max. Nicht mit anderen AutomationBench-AA-Metriken vermischen. | 32,1 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | Gewinner41,6 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 54,607 % | Höherer Messwert67,74 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert70,416 % | 41,072 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
DeepSWEOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: pass@1Bewertung: Mehr ist besserEinstellungen: Reasoning: max113 Aufgaben in 91 Repositorys und fünf Sprachen. Reasoning max. Meta nennt Datacurve als Evaluator; diese Muse-Werte waren auf dessen öffentlicher Rangliste beim Abruf nicht auffindbar. | 67,4 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | Gewinner74,1 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
EMBOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert76,67 % | 71,7 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert58,877 % | 53,54 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: published GDP.pdf scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxBerufliche Arbeit mit bereitgestellten PDF-Unterlagen. Reasoning max. Meta nennt Surge als ursprüngliche Quelle. | 27,6 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | Gewinner34,2 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Harvey LAB-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: all criteria passed with hallucination checksBewertung: Mehr ist besserEinstellungen: Reasoning: maxJuristische Arbeitsergebnisse, alle Kriterien einschließlich Halluzinationsprüfung müssen erfüllt sein. Reasoning max. Meta nennt Artificial Analysis als ursprünglichen Evaluator. | 6,4 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | Gewinner8,6 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert6,667 % | 5,417 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
HealthBench ProOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: length-normalized weighted rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: max525 Gesundheitsfragen ohne Werkzeuge, ärztliche Bewertungsraster mit GPT-5.4 als Bewerter. Reasoning max. Die Claude-Werte stammen laut Meta aus Anthropics Modellkarten. | 62,1 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | Gewinner65,3 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | MetaQuellendetailsDatenstand: 15.10.2026 |
IOIOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 90,778 % | Höherer Messwert100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
JobBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: mean task rewardBewertung: Mehr ist besserEinstellungen: Reasoning: max65 berufliche Aufgaben aus 35 Berufen. Mittlerer aufgabenspezifischer Reward, Reasoning max. | Gewinner73,1 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | 66,1 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert55,288 % | 39,423 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 7.230 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen. | 1.742,652 95-%-Konfidenzintervall: ±9,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Gewinner1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 14.121 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 11.674 veröffentlichten Paarvergleichen. | Gewinner1.500,568 95-%-Konfidenzintervall: ±6,106Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.476,716 95-%-Konfidenzintervall: ±6,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 4.648 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 3.590 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.286,407 95-%-Konfidenzintervall: ±9,66Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.285,988 95-%-Konfidenzintervall: ±10,782Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert53,509 % | 48,486 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert91,294 % | 87,908 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MemoryBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta internal Wonder evaluationMessgröße: LLM-judge weighted rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxInterner Meta-Test mit 64K-100K Token langen Gesprächen, Ablenkungen sowie widersprüchlichen oder aktualisierten Gesprächsteilen. Reasoning max. | 79 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | Gewinner81,4 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | MetaQuellendetailsDatenstand: 15.10.2026 |
MysteryMechanismOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 47,748 % | Höherer Messwert53,153 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
OSWorld V2.1 (binary completion)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: V2.1Messgröße: strict binary task completionBewertung: Mehr ist besserEinstellungen: Reasoning: max108 Desktop-Arbeitsabläufe auf Ubuntu. Vollständige Aufgabenerfüllung ohne Teilpunkte, Reasoning max. Kein veröffentlichter binärer Opus-5.5-Wert. | Gewinner43,1 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | 34,3 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
OSWorld V2.1 (partial reward)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: V2.1Messgröße: mean per-task partial rewardBewertung: Mehr ist besserEinstellungen: Reasoning: max108 Desktop-Arbeitsabläufe auf Ubuntu. Teilpunkte, Reasoning max. Der Opus-5.5-Wert ist laut Meta eine Anthropic-Angabe. | Gewinner80,7 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | 75,8 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Personal Superintelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder launch scorecardMessgröße: Meta internal composite scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxMetas internes Aggregat aus sieben Tests für persönliche und berufliche Aufgaben. Reasoning max. | 49,9 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | Gewinner54,5 Punkte Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe. | MetaQuellendetailsDatenstand: 15.10.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert7 % | 5,5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProgramBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: rollouts passing at least 95% of testsBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: mini-swe-agentProgramme aus einer Spezifikation rekonstruieren. Einheitlicher mini-swe-agent, saubere Umgebung ohne Internet nach dem Start. Anteil der Läufe mit mindestens 95 % bestandenen Tests, Reasoning max. | Gewinner55,5 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | 52,5 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
ProofBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert100 % | 99 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert48,526 % | 46,367 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SRE BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 22,901 % | Höherer Messwert56,87 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
SWE-bench MultimodalOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert61,25 % | 43,333 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
SWE-Marathon v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: pass@1Bewertung: Mehr ist besserEinstellungen: Reasoning: maxVergleichswert aus Metas veröffentlichter Tabelle, Reasoning max. Der jeweilige Agent ist in der Tabellenzelle nicht dokumentiert. | Gewinner45,6 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | 42,5 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Tax Agent BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert49,194 % | 20,717 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 85,019 % | Höherer Messwert87,266 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench 4.0OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 58,081 % | Höherer Messwert59,596 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench 4.0-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0-AAMessgröße: task accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: maxTerminal-Aufgaben in isolierten Umgebungen mit ausführbaren Prüfern. Reasoning max. Meta nennt Artificial Analysis als Ergebnisquelle; die jeweiligen Agenten bleiben Teil des Ergebnisses. | 52 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | Gewinner59,1 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Terminal-Bench ScienceOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | 40 % | Höherer Messwert62,857 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Time Horizon Index: KSPOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: progressBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 63,333 % | Höherer Messwert90,5 % | Vals AIQuellendetailsDatenstand: 07.10.2026 |
Vals Finance Agent V2OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: V2Messgröße: private test accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: maxFinanzrecherche anhand von Unternehmensunterlagen und Marktdaten. Privates Testset, Reasoning max. Von Meta wiedergegebene Vals-Werte. | Gewinner58,9 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | 53,5 % Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. | MetaQuellendetailsDatenstand: 15.10.2026 |
Vals IndexOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert65,827 % | 63,125 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vibe Code Bench 1-100OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert28 % | 27,644 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert90,263 % | 89,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 52,809 % | Höherer Messwert67,463 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PatchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert87,5 % | 82,143 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBCompsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert82,233 % | 77,953 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert54,393 % | 48,318 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert89,855 % | 88,768 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2024TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger100 % | Kein direkter Sieger100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert68,182 % | 53,03 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 2.470 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 2.739 veröffentlichten Paarvergleichen. | 1.719,751 95-%-Konfidenzintervall: ±13,642Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Kein klarer Vorsprung1.731,395 95-%-Konfidenzintervall: ±13,296Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 2.589 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 2.061 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.485,231 95-%-Konfidenzintervall: ±11,847Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.472,34 95-%-Konfidenzintervall: ±13,336Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 260 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 230 veröffentlichten Paarvergleichen. | 1.340,8 95-%-Konfidenzintervall: ±36,169Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Kein klarer Vorsprung1.357,126 95-%-Konfidenzintervall: ±39,572Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert53,5 % | 50 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens | 34,524 % | Höherer Messwert37,302 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SRE BenchCapability ScoreTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: capability scoreBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 36,641 % | Höherer Messwert63,868 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
SWE-bench Multimodalbpmn-jsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert79,245 % | 62,264 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert26,667 % | 13,333 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger100 % | Kein direkter Sieger100 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench 4.0HardwareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger60 % | Kein direkter Sieger60 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceEarth SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | 25 % | Höherer Messwert62,5 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Time Horizon Index: KSPProgress efficiencyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: progressBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 33,384 % | Höherer Messwert70,112 % | Vals AIQuellendetailsDatenstand: 07.10.2026 |
Vals IndexCode MigrationTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 60,033 % | Höherer Messwert68,462 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Code MigrationCOBOLTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 60 % | Höherer Messwert68,571 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PoCTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert53,333 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBDataroomTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert86,736 % | 79,319 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)All-PassTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert47,773 % | 40,252 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Fable 5.1
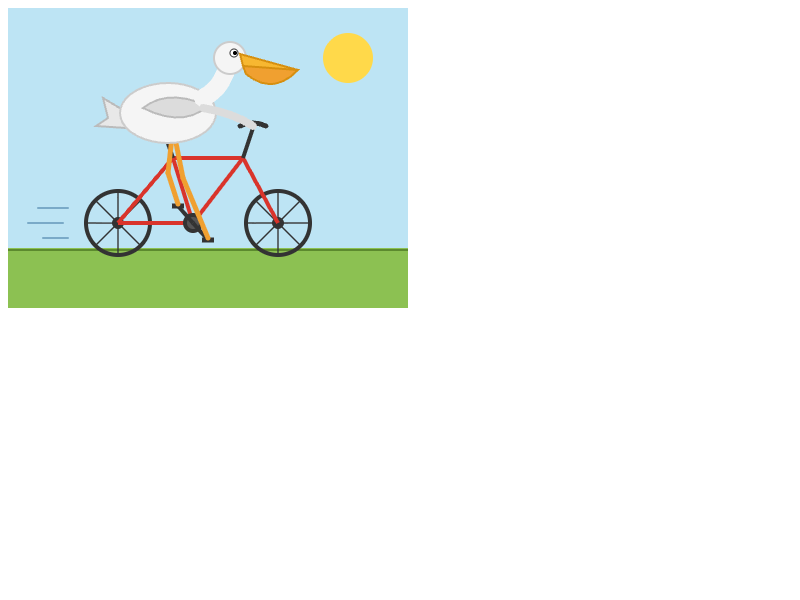
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-6 Astra
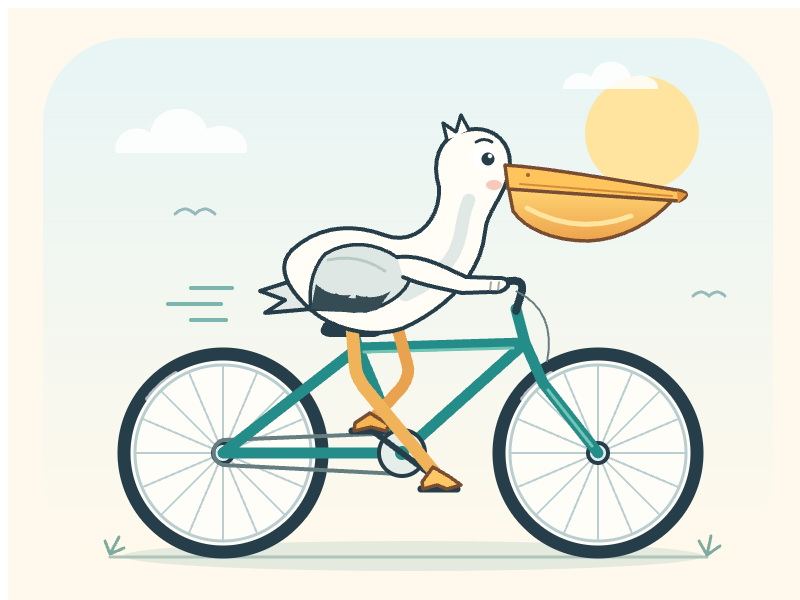
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Fable 5.1 und GPT-6 Astra mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.