Claude Opus 5
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Opus 5 | GPT-6 Astra |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Erschienen | 24. Juli 2026 | 3. Sept. 2026 |
| Verfügbarkeit | Aktiv | Eingeschränkter Zugang |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 1.050.000 Token |
| Wissensstand | Mai 2026 | 30. April 2026 |
| Technische Quellen | Modell, Wissensstand | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Opus 5 | GPT-6 Astra |
|---|---|---|
| API-Eingabe | 5 $ | 10 $ ≤272K / 20 $ >272K |
| API-Ausgabe | 25 $ | 50 $ ≤272K / 75 $ >272K |
| Cache lesen | 0,5 $ | 1 $ ≤272K / 2 $ >272K |
| Cache schreiben (5 Min.) | 6,25 $ | 12,5 $ ≤272K / 25 $ >272K |
| Cache schreiben (1 Std.) | 10 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Opus 5 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/eu-west-1 | 5,5 $ | 27,5 $ | Quelle19.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 5,5 $ | 27,5 $ | Quelle19.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| Anthropic | Über OpenRouteranthropic/fast | 10 $ | 50 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure/us | 5,5 $ | 27,5 $ | Quelle19.10.2026 | |
| Claude Platform on AWS | Über OpenRouterclaude-on-aws | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| Über OpenRoutergoogle-vertex/europe | 5,5 $ | 27,5 $ | Quelle19.10.2026 | ||
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | ||
| Über OpenRoutergoogle-vertex/us | 5,5 $ | 27,5 $ | Quelle19.10.2026 | ||
| GPT-6 Astra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 10 $ | 50 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 20 $ | 75 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-west-2 | 11 $ | 55 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure | 10 $ | 50 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure/us | 11 $ | 55 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai | 10 $ | 50 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 20 $ | 100 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/ultrafast | 60 $ | 300 $ | Quelle19.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
96 passende Messreihen aus 14 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 11 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Opus 5 | GPT-6 Astra | Quelle |
|---|---|---|---|
AA-AnalystAgentOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA cohort: 80 questionsMessgröße: pass^5 reliabilityBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Max), Reasoning: Max, Agent: Stirrup analyst agent, Harness: Artificial Analysis Stirrup, Versuche: pass^5, 5 independent attempts per question GPT-6 Astra: Snapshot: GPT-6 Astra (Max), Reasoning: Max, Agent: Stirrup analyst agent, Harness: Artificial Analysis Stirrup, Versuche: pass^5, 5 independent attempts per questionClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Max) (Release claude-opus-5, Zeile claude-opus-5, UUID b8fc61f7-5e9a-49e6-8547-6ac56db24627, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. 80 quantitative Fragen aus 14 Domänen werden je fünfmal unabhängig ausgeführt. pass^5 zählt nur Fragen als gelöst, die in allen fünf Versuchen richtig beantwortet werden.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Max) (Release gpt-6-astra, Zeile gpt-6-astra, UUID 2f339a97-9a0d-499a-9cb5-e0db665bfa25, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. 80 quantitative Fragen aus 14 Domänen werden je fünfmal unabhängig ausgeführt. pass^5 zählt nur Fragen als gelöst, die in allen fünf Versuchen richtig beantwortet werden. | Gewinner53,8 % Fragen, Quelldateien und Referenzantworten sind privat. pass^5 misst Zuverlässigkeit über alle fünf Wiederholungen, nicht pass@1. | 51,2 % Fragen, Quelldateien und Referenzantworten sind privat. pass^5 misst Zuverlässigkeit über alle fünf Wiederholungen, nicht pass@1. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner1.633,85 elo | 1.546,7 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner80,3 % | 80,0 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 35,383 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Gewinner43,417 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience AccuracyOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience AccuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: Xhigh, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält. | 59,5 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | Gewinner61,9 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience Hallucination RateOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience Hallucination RateBewertung: Weniger ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: Xhigh, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet).GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet). | 59,5 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | Gewinner48,3 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 49,677 Punkte | Gewinner52,386 Punkte | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 53,2 % | Gewinner67,2 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
BioMysteryBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger79,259 % | Kein direkter Sieger79,259 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 57,473 % | Höherer Messwert67,74 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert65,357 % | 41,072 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert73,556 % | 71,7 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert58,633 % | 53,54 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 21,0 % | Gewinner32,2 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner1.690,67 elo | 1.555,91 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert6,667 % | 5,417 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 54,4 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Gewinner54,6 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
IOIOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 84,333 % | Höherer Messwert100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert55,288 % | 39,423 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-high, Reasoning: high, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevClaude Opus 5: Arena-Bewertung aus 23.519 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen. | 1.657,837 95-%-Konfidenzintervall: ±5,533Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Höherer Messwert1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena SearchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: searchMessgröße: Search Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-high, Reasoning: high, Harness: Arena Search GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena SearchClaude Opus 5: Arena-Bewertung aus 13.285 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 18.483 veröffentlichten Paarvergleichen. | Höherer Messwert1.241,568 95-%-Konfidenzintervall: ±6,871Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.233,616 95-%-Konfidenzintervall: ±7,842Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-high, Reasoning: high, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlClaude Opus 5: Arena-Bewertung aus 65.663 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 11.674 veröffentlichten Paarvergleichen. | Höherer Messwert1.489,847 95-%-Konfidenzintervall: ±3,689Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.476,716 95-%-Konfidenzintervall: ±6,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-high, Reasoning: high, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlClaude Opus 5: Arena-Bewertung aus 16.665 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 3.590 veröffentlichten Paarvergleichen. | Höherer Messwert1.287,417 95-%-Konfidenzintervall: ±6,783Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.285,988 95-%-Konfidenzintervall: ±10,782Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert63,57 % | 48,486 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert90,985 % | 87,908 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MMMU-ProOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA cohort: 1,730 questionsMessgröße: pass@1 accuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh, Versuche: pass@1, one run per question GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: Xhigh, Versuche: pass@1, one run per questionClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Der AA-Lauf umfasst 1.730 Fragen mit zehn Antwortoptionen. Die Antwort wird per regulärem Ausdruck extrahiert und als pass@1 bewertet.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Der AA-Lauf umfasst 1.730 Fragen mit zehn Antwortoptionen. Die Antwort wird per regulärem Ausdruck extrahiert und als pass@1 bewertet. | 84,0 % Die Benchmarkseite nennt 3.460 Fragen für den vollständigen MMMU-Pro-Datensatz; die AA-Methodik beschreibt einen 1.730-Fragen-Lauf. | Gewinner86,2 % Die Benchmarkseite nennt 3.460 Fragen für den vollständigen MMMU-Pro-Datensatz; die AA-Methodik beschreibt einen 1.730-Fragen-Lauf. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
MysteryMechanismOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 37,387 % | Höherer Messwert53,153 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 3 % | Höherer Messwert5,5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProofBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger99 % | Kein direkter Sieger99 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert49,426 % | 46,367 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SRE BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 12,214 % | Höherer Messwert56,87 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Tax Agent BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert45,548 % | 20,717 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: Task successBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Xhigh), Reasoning: Xhigh GPT-6 Astra: Snapshot: GPT-6 Astra (Xhigh), Reasoning: XhighClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Xhigh) (Release claude-opus-5, Zeile claude-opus-5-xhigh, UUID 1305c921-7aaa-4d6d-99b5-99b3acf15e19, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Xhigh) (Release gpt-6-astra, Zeile gpt-6-astra-xhigh, UUID 1f541ef3-913f-4eb2-9d07-0e93c7a9a5e3, reasoning=true, source reasoning-token configuration budget=0, suffix=Xhigh). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 46,5 % | Gewinner59,6 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Terminal-Bench 2.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 84,644 % | Höherer Messwert87,266 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench 4.0OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 53,535 % | Höherer Messwert59,596 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | 27,143 % | Höherer Messwert62,857 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Terminal-Bench-ScienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 0.1.0Messgröße: pass@1 task success rateBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Max), Reasoning: Max, Agent: mini-swe-agent, Harness: mini-swe-agent, Versuche: pass@1, averaged over 3 repeats per task GPT-6 Astra: Snapshot: GPT-6 Astra (Max), Reasoning: Max, Agent: mini-swe-agent, Harness: mini-swe-agent, Versuche: pass@1, averaged over 3 repeats per taskClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Max) (Release claude-opus-5, Zeile claude-opus-5, UUID b8fc61f7-5e9a-49e6-8547-6ac56db24627, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Die vollständige Version 0.1.0 umfasst 70 Aufgaben aus fünf Wissenschaftsbereichen. Jede Aufgabe besteht nur, wenn ihre gesamte Testsuite besteht. AA mittelt pass@1 über drei Wiederholungen.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Max) (Release gpt-6-astra, Zeile gpt-6-astra, UUID 2f339a97-9a0d-499a-9cb5-e0db665bfa25, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Die vollständige Version 0.1.0 umfasst 70 Aufgaben aus fünf Wissenschaftsbereichen. Jede Aufgabe besteht nur, wenn ihre gesamte Testsuite besteht. AA mittelt pass@1 über drei Wiederholungen. | 28,6 % | Gewinner63,3 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Time Horizon Index: KSPOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: progressBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 18,833 % | Höherer Messwert90,5 % | Vals AIQuellendetailsDatenstand: 07.10.2026 |
Vals IndexOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert63,674 % | 63,125 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vibe Code Bench 1-100OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert28,533 % | 27,644 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Harness: OpenHands GPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | 88,404 % | Höherer Messwert89,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.209,28 elo | Gewinner1.257,01 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner81,3 % | 80,0 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 28,55 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Gewinner40,55 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience AccuracyOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience AccuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: Low, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält. | 56,0 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | Gewinner59,5 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience Hallucination RateOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience Hallucination RateBewertung: Weniger ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: Low, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet).GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet). | 62,2 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | Gewinner46,9 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 39,354 Punkte | Gewinner45,782 Punkte | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 51,8 % | Gewinner59,1 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
BioMysteryBenchHardTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens | Höherer Messwert43,137 % | 37,255 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 53,297 % | Höherer Messwert67,463 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PatchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert85,714 % | 82,143 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBCompsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 75,171 % | Höherer Messwert77,953 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert54,617 % | 48,318 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 17,2 % | Gewinner30,4 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.302,46 elo | Gewinner1.389,25 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 87,319 % | Höherer Messwert88,768 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: LowClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 43,4 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Gewinner49,2 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
IOIIOI 2024TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger100 % | Kein direkter Sieger100 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert65,152 % | 53,03 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-max, Reasoning: max, Harness: Arena Code Arena WebDev GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDevClaude Opus 5: Arena-Bewertung aus 17.934 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen. | 1.689,967 95-%-Konfidenzintervall: ±6,28Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Gewinner1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-max, Reasoning: max, Harness: Arena Text, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style controlClaude Opus 5: Arena-Bewertung aus 31.907 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 11.674 veröffentlichten Paarvergleichen. | Gewinner1.489,524 95-%-Konfidenzintervall: ±4,846Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.476,716 95-%-Konfidenzintervall: ±6,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5: Snapshot: claude-opus-5-high, Reasoning: high, Harness: Arena Vision, style control GPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style controlClaude Opus 5: Arena-Bewertung aus 985 veröffentlichten Paarvergleichen.GPT-6 Astra: Arena-Bewertung aus 230 veröffentlichten Paarvergleichen. | Höherer Messwert1.366,609 95-%-Konfidenzintervall: ±20,761Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.357,126 95-%-Konfidenzintervall: ±39,572Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMMU-ProOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA cohort: 1,730 questionsMessgröße: pass@1 accuracyBewertung: Mehr ist besserClaude Opus 5: Snapshot: Claude Opus 5 (Low), Reasoning: Low, Versuche: pass@1, one run per question GPT-6 Astra: Snapshot: GPT-6 Astra (Low), Reasoning: Low, Versuche: pass@1, one run per questionClaude Opus 5: Exakte AA-Konfiguration: Claude Opus 5 (Low) (Release claude-opus-5, Zeile claude-opus-5-low, UUID 20928ba9-3a3f-415f-9519-b84ff64ecf34, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Der AA-Lauf umfasst 1.730 Fragen mit zehn Antwortoptionen. Die Antwort wird per regulärem Ausdruck extrahiert und als pass@1 bewertet.GPT-6 Astra: Exakte AA-Konfiguration: GPT-6 Astra (Low) (Release gpt-6-astra, Zeile gpt-6-astra-low, UUID a3f8100d-e38f-408b-b0fa-0085dae18dc1, reasoning=true, source reasoning-token configuration budget=0, suffix=Low). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Der AA-Lauf umfasst 1.730 Fragen mit zehn Antwortoptionen. Die Antwort wird per regulärem Ausdruck extrahiert und als pass@1 bewertet. | 79,8 % Die Benchmarkseite nennt 3.460 Fragen für den vollständigen MMMU-Pro-Datensatz; die AA-Methodik beschreibt einen 1.730-Fragen-Lauf. | Gewinner84,6 % Die Benchmarkseite nennt 3.460 Fragen für den vollständigen MMMU-Pro-Datensatz; die AA-Methodik beschreibt einen 1.730-Fragen-Lauf. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserClaude Opus 5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 41,5 % | Höherer Messwert50 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 5
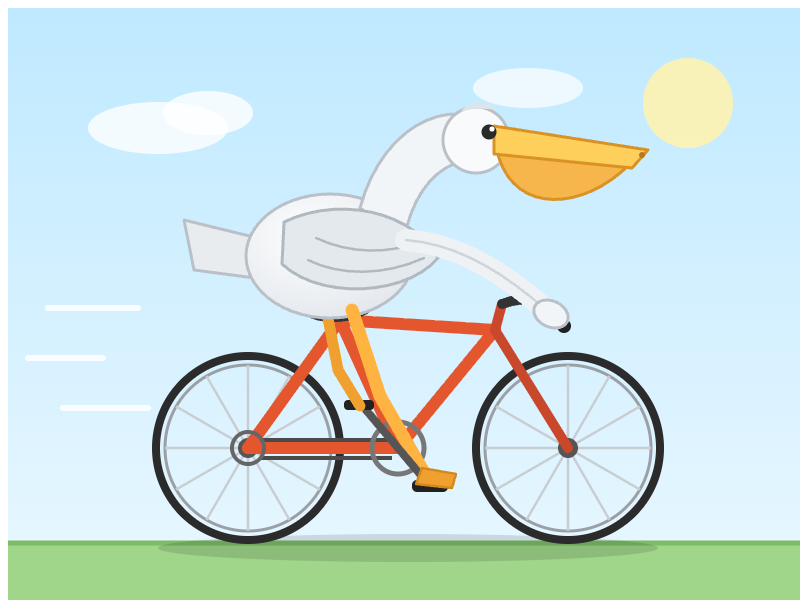
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-6 Astra
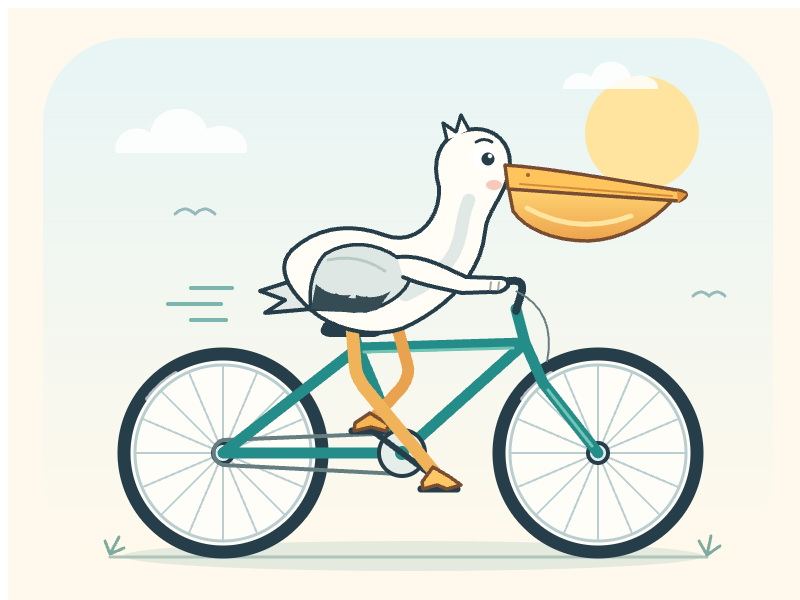
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Opus 5 und GPT-6 Astra mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.