Zum Hauptinhalt springen

Direktvergleich

GPT-6 Astra vs. Muse Wonder Full

Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.

gemeinsame Messreihen
178
verschiedene Benchmarks
34
jüngster Abruf
15.10.2026

Modellauswahl ändern

Steckbrief

Allgemeine Daten

Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.

Allgemeine Daten von GPT-6 Astra und Muse Wonder Full
MerkmalGPT-6 AstraMuse Wonder Full
AnbieterOpenAIMeta
Erschienen3. Sept. 202612. Okt. 2026
VerfügbarkeitEingeschränkter ZugangNur im Abo
ModelltypProprietärProprietär
ParameterNicht veröffentlichtNicht veröffentlicht
ArchitekturNicht veröffentlichtNicht veröffentlicht
Kontextfenster1.050.000 Token1 Mio. Token
Wissensstand30. April 2026Nicht veröffentlicht
Technische QuellenModell, KontextModell, Kontext

Kosten

API-Preise im Vergleich

Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.

API-Preise von GPT-6 Astra und Muse Wonder Full
PreisartGPT-6 AstraMuse Wonder Full
API-Eingabe10 $ ≤272K / 20 $ >272K—
API-Ausgabe50 $ ≤272K / 75 $ >272K—
Cache lesen1 $ ≤272K / 2 $ >272KNicht ausgewiesen
Cache schreiben (5 Min.)12,5 $ ≤272K / 25 $ >272KNicht ausgewiesen
Cache schreiben (1 Std.)Nicht ausgewiesenNicht ausgewiesen
Preis geprüft22.09.2026 Quelle15.10.2026
Preise nach Anbieter

Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.

Für Muse Wonder Full ist im gespeicherten OpenRouter-Stand kein Anbietertarif verfügbar. Der offizielle Direktpreis wird trotzdem angezeigt.

Anbieterpreise von GPT-6 Astra und Muse Wonder Full
ModellAnbieterBezugsweg und TarifEingabe pro 1 Mio. TokenAusgabe pro 1 Mio. TokenQuelle
GPT-6 AstraOpenAIDirekt beim EntwicklerBis 272.000 Kontext-Token10 $50 $Quelle22.09.2026
OpenAIDirekt beim EntwicklerÜber 272.000 Kontext-Token20 $75 $Quelle22.09.2026
Amazon BedrockÜber OpenRouteramazon-bedrock/us-west-211 $55 $Quelle16.10.2026
AzureÜber OpenRouterazure10 $50 $Quelle16.10.2026
AzureÜber OpenRouterazure/us11 $55 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai10 $50 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai/fast20 $100 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai/flexGünstigster erfasster Preis: 5 $Günstigster erfasster Preis: 25 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai/ultrafast60 $300 $Quelle16.10.2026

Leistung

Gemeinsame Benchmarks

Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.

Fähigkeitsprofil aus vergleichbaren Benchmarks

Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.

255075100CodingWissenFinanzenRechtAgenten-AufgabenProduktivitätGesundheitGesamt
GPT-6 Astra
Muse Wonder Full
Coding: 94,3 / 98,9 (3 Benchmarkfamilien)
Wissen: 95,2 / 100 (1 Benchmarkfamilie)
Finanzen: 90,5 / 100 (1 Benchmarkfamilie)
Recht: 65,6 / 100 (1 Benchmarkfamilie)
Agenten-Aufgaben: 91,8 / 100 (3 Benchmarkfamilien)
Produktivität: 93,9 / 98,5 (2 Benchmarkfamilien)
Gesundheit: 100 / 95,4 (1 Benchmarkfamilie)
Gesamt: 92,2 / 100 (1 Benchmarkfamilie)

13 passende Messreihen aus 13 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 8 vergleichbaren Kategorien.

GPT-6 AstraMuse Wonder Full
AutomationBench-AA (strict pass@1)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 Astra41,6 %
Muse Wonder FullGewinner45,4 %
BioMysteryBenchOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 AstraHöherer Messwert79,259 %
Muse Wonder Full73,333 %
Code MigrationOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 AstraHöherer Messwert67,74 %
Muse Wonder Full61,033 %
CyberBench v1.1Overall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Astra41,072 %
Muse Wonder FullHöherer Messwert73,631 %
DeepSWEOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 Astra74,1 %
Muse Wonder FullGewinner79 %
EMBOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Astra71,7 %
Muse Wonder FullHöherer Messwert71,917 %
Finance Agent (v2)Overall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Astra53,54 %
Muse Wonder FullHöherer Messwert59,061 %
GDP.pdfOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 AstraGewinner34,2 Punkte
Muse Wonder Full33,2 Punkte
Harvey LAB-AAOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 Astra8,6 %
Muse Wonder FullGewinner13,1 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Astra5,417 %
Muse Wonder FullHöherer Messwert21,667 %
HealthBench ProOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 AstraGewinner65,3 Punkte
Muse Wonder Full62,3 Punkte
IOIOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 AstraHöherer Messwert100 %
Muse Wonder Full79,833 %

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Benchmarkwerte von GPT-6 Astra und Muse Wonder Full
Benchmark und AufgabeGPT-6 AstraMuse Wonder FullQuelle
AutomationBench-AA (strict pass@1)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: strict pass@1; every end-state assertion passedBewertung: Mehr ist besserEinstellungen: Reasoning: maxGeschäftsabläufe in einer simulierten Anwendungsumgebung. Jede Endzustandsprüfung muss bestehen, Reasoning max. Nicht mit anderen AutomationBench-AA-Metriken vermischen.
41,6 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner45,4 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
BioMysteryBenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert79,259 %
73,333 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert67,74 %
61,033 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
41,072 %
Höherer Messwert73,631 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
DeepSWEOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: pass@1Bewertung: Mehr ist besserEinstellungen: Reasoning: max113 Aufgaben in 91 Repositorys und fünf Sprachen. Reasoning max. Meta nennt Datacurve als Evaluator; diese Muse-Werte waren auf dessen öffentlicher Rangliste beim Abruf nicht auffindbar.
74,1 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner79 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
EMBOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
71,7 %
Höherer Messwert71,917 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
53,54 %
Höherer Messwert59,061 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
GDP.pdfOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: published GDP.pdf scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxBerufliche Arbeit mit bereitgestellten PDF-Unterlagen. Reasoning max. Meta nennt Surge als ursprüngliche Quelle.
Gewinner34,2 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
33,2 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Meta
Quellendetails
Datenstand: 15.10.2026
Harvey LAB-AAOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: all criteria passed with hallucination checksBewertung: Mehr ist besserEinstellungen: Reasoning: maxJuristische Arbeitsergebnisse, alle Kriterien einschließlich Halluzinationsprüfung müssen erfüllt sein. Reasoning max. Meta nennt Artificial Analysis als ursprünglichen Evaluator.
8,6 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner13,1 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
Harvey's Legal Agent BenchmarkOverall · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
5,417 %
Höherer Messwert21,667 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
HealthBench ProOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: length-normalized weighted rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: max525 Gesundheitsfragen ohne Werkzeuge, ärztliche Bewertungsraster mit GPT-5.4 als Bewerter. Reasoning max. Die Claude-Werte stammen laut Meta aus Anthropics Modellkarten.
Gewinner65,3 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
62,3 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Meta
Quellendetails
Datenstand: 15.10.2026
IOIOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert100 %
79,833 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
JobBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: mean task rewardBewertung: Mehr ist besserEinstellungen: Reasoning: max65 berufliche Aufgaben aus 35 Berufen. Mittlerer aufgabenspezifischer Reward, Reasoning max.
66,1 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Gewinner75,3 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Meta
Quellendetails
Datenstand: 15.10.2026
Legal Research BenchOverall · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
39,423 %
Höherer Messwert53,365 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
MedCodeOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
48,486 %
Höherer Messwert49,932 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
MedScribeOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
87,908 %
Höherer Messwert89,335 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
MemoryBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta internal Wonder evaluationMessgröße: LLM-judge weighted rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxInterner Meta-Test mit 64K-100K Token langen Gesprächen, Ablenkungen sowie widersprüchlichen oder aktualisierten Gesprächsteilen. Reasoning max.
81,4 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Gewinner85,5 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Meta
Quellendetails
Datenstand: 15.10.2026
MysteryMechanismOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert53,153 %
35,135 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
OSWorld V2.1 (binary completion)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: V2.1Messgröße: strict binary task completionBewertung: Mehr ist besserEinstellungen: Reasoning: max108 Desktop-Arbeitsabläufe auf Ubuntu. Vollständige Aufgabenerfüllung ohne Teilpunkte, Reasoning max. Kein veröffentlichter binärer Opus-5.5-Wert.
34,3 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner39,4 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
OSWorld V2.1 (partial reward)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: V2.1Messgröße: mean per-task partial rewardBewertung: Mehr ist besserEinstellungen: Reasoning: max108 Desktop-Arbeitsabläufe auf Ubuntu. Teilpunkte, Reasoning max. Der Opus-5.5-Wert ist laut Meta eine Anthropic-Angabe.
75,8 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner78,4 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
Personal Superintelligence IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder launch scorecardMessgröße: Meta internal composite scoreBewertung: Mehr ist besserEinstellungen: Reasoning: maxMetas internes Aggregat aus sieben Tests für persönliche und berufliche Aufgaben. Reasoning max.
54,5 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Gewinner59,1 Punkte
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe. Die Quelle nennt keinen Nenner und keine normierte Skala. Angezeigt wird der veröffentlichte Rohwert, keine Prozentangabe.
Meta
Quellendetails
Datenstand: 15.10.2026
ProgramBenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert5,5 %
0,5 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
ProgramBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: Meta Wonder scorecard; version unspecifiedMessgröße: rollouts passing at least 95% of testsBewertung: Mehr ist besserEinstellungen: Reasoning: max, Harness: mini-swe-agentProgramme aus einer Spezifikation rekonstruieren. Einheitlicher mini-swe-agent, saubere Umgebung ohne Internet nach dem Start. Anteil der Läufe mit mindestens 95 % bestandenen Tests, Reasoning max.
52,5 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner59 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
ProofBenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert99 %
94 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
SRE BenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert56,87 %
11,832 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
SWE-bench MultimodalOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
43,333 %
Höherer Messwert47,292 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
20,717 %
Höherer Messwert42,997 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert59,596 %
58,081 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench 4.0-AAOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 4.0-AAMessgröße: task accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: maxTerminal-Aufgaben in isolierten Umgebungen mit ausführbaren Prüfern. Reasoning max. Meta nennt Artificial Analysis als Ergebnisquelle; die jeweiligen Agenten bleiben Teil des Ergebnisses.
Gewinner59,1 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
57,1 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
Terminal-Bench ScienceOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert62,857 %
37,143 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals Finance Agent V2Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: V2Messgröße: private test accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: maxFinanzrecherche anhand von Unternehmensunterlagen und Marktdaten. Privates Testset, Reasoning max. Von Meta wiedergegebene Vals-Werte.
53,5 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Gewinner59,1 %
Von Meta veröffentlichte Vergleichstabelle. Meta verwendet je nach Benchmark eigene Läufe, Herstellerangaben oder Drittanbieter-Ergebnisse und wählt den höchsten verfügbaren validierten Wert. Das ist keine durchgehend unabhängig erhobene Vergleichsgruppe.
Meta
Quellendetails
Datenstand: 15.10.2026
Vals IndexOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
63,125 %
Höherer Messwert64,566 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Vibe Code Bench 1-100Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 131.072 tokens
27,644 %
Höherer Messwert33,978 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vibe Code Bench v1.1Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert89,594 %
85,996 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
BioMysteryBenchHard
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert37,255 %
33,333 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationCLI
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert67,463 %
58,044 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1Patch
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
82,143 %
Höherer Messwert83,929 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBComps
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
77,953 %
Höherer Messwert80,89 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Adjustments
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
48,318 %
Höherer Messwert56,668 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passed
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
88,768 %
Höherer Messwert94,928 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIIOI 2024
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert100 %
75,333 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchAdministrative / Regulatory · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
53,03 %
Höherer Messwert63,636 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
ProgramBenchAlmost Resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert50 %
8 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
SRE BenchCapability Score
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: capability scoreBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert63,868 %
17,748 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
SWE-bench Multimodalbpmn-js
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
62,264 %
Höherer Messwert69,811 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchControversy & Precedence Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
13,333 %
Höherer Messwert26,667 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Hardware
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert60 %
46,667 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceEarth Sciences
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Kein direkter Sieger62,5 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexCode Migration
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert68,462 %
60,256 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
BioMysteryBenchHuman-solvable
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert89,041 %
82,648 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationCOBOL
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
68,571 %
Höherer Messwert70 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1PoC
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
0 %
Höherer Messwert63,333 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBDataroom
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
79,319 %
Höherer Messwert85,257 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)All-Pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
40,252 %
Höherer Messwert49,037 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
0 %
Höherer Messwert20 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIIOI 2025
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert100 %
85,5 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
87,482 %
Höherer Messwert92,809 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
ProgramBenchFully Resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert5,5 %
0,5 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
SRE BenchFully Solved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert56,87 %
11,832 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
SWE-bench MultimodalCarbon
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
24,06 %
Höherer Messwert29,323 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchControversy & Precedence Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
58,616 %
Höherer Messwert76,097 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Media
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert66,667 %
58,333 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceEngineering Sciences
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert33,333 %
11,111 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexEMB
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
71,7 %
Höherer Messwert71,917 %
Vals AI
Quellendetails
Datenstand: 13.10.2026

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Eigene Modelltests

Unsere Tests

Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.

Frühere Tests

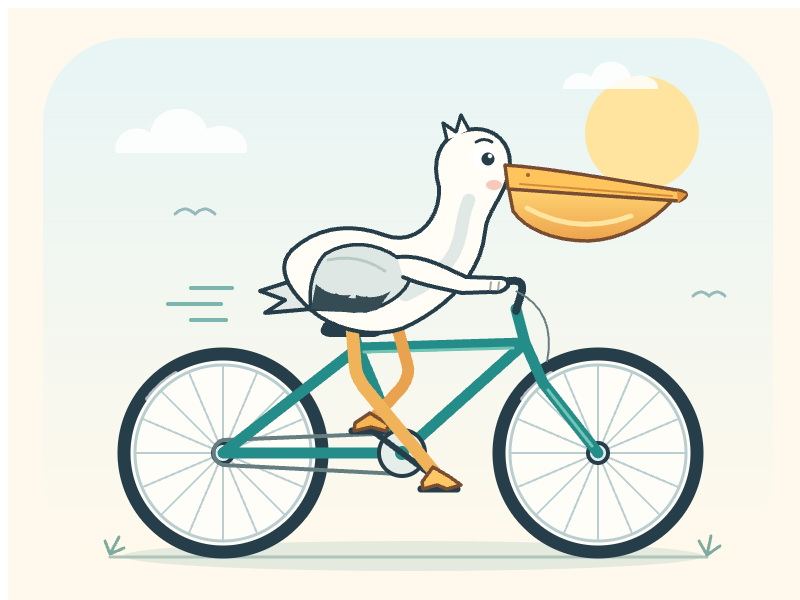
Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

GPT-6 Astra

GPT-6 Astra: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-6-astra
API-Modell laut Antwort
openai/gpt-6-astra
Reasoning-Einstellung
high
Festgelegter Endpunkt
OpenAI | openai/gpt-6-astra-20260903
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
141,7 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Muse Wonder Full

Noch nicht getestet

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)

So liest du den Vergleich

Ein Benchmark-Sieg ist kein Gesamturteil

Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.

Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.

Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.

Weitere Duelle

Vergleiche GPT-6 Astra und Muse Wonder Full mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.
Zum vollständigen LLM-Vergleich