
Kimi K3
Moonshot AI
Das Besondere an Kimi K3 ist die native visuelle Architektur mit KDA und AttnRes. Moonshot nennt 2,8 Billionen Gesamtparameter, 104 Milliarden aktive Parameter, 896 Experten mit 16 ausgewählten Experten pro Schritt und 1.048.576 Token Kontext. Text, Bilder und Videos gehören zum selben Modell.
Reasoning ist immer aktiv und lässt sich über Low, High und Max steuern. Moonshot stellt K3 der Kimi K2.6-Linie gegenüber. Für lokale Nutzung und Weitergabe gelten die Kimi-K3-Lizenz und die Bedingungen der veröffentlichten Gewichte.
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | Open WeightsQuelle |
| Zugang | API, LokalQuelle |
| Parameter | 2,8 BillionenQuelle |
| Aktive Parameter | 104 Mrd.Quelle |
| Kontextfenster | 1.048.576 TokenQuelle |
| Hinweise | 2,8 Bio. insgesamt, 104B aktiv, 896 Experten mit 16 aktiven Experten pro Token, hybride lineare KDA-Attention, native visuelle Fähigkeiten und 1.048.576 Token Kontext. Die Gewichte sind veröffentlicht.Quelle |
| Lizenz | Kimi K3 LicenseQuelle |
| Parameter | 2.800 Mrd.Quelle |
| Aktive Parameter | 104 Mrd.Quelle |
| Architektur | MoE with KDA, gated MLA, 896 experts/16 selected, MoonViT V2Quelle |
| Ausgabe | TextQuelle |
| Werkzeugaufrufe | JaQuelle |
| Quantisierung | MXFP4 weights / MXFP8 activationsQuelle |
| Eingabe | Text, Bild, VideoQuelle |
| Reasoning-Modus | Always enabled; reasoning effort: low, high, max (default max).Quelle |
Benchmark-Metaanalyse
Diese Gradually-Indizes ordnen ausgewählte veröffentlichte Messwerte auf einer Skala von 0 bis 100 ein. Sie sind keine Prozentgenauigkeit und keine Garantie für ein Ergebnis in deiner Anwendung.
Abrufstände der verwendeten Quellen 2026-10-15 - 2026-10-19
Index 75,2 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 57,5 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 71,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 58,7 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 66,4 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 77,2 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 75,9 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 85,2 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 80,0 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Methodenfassung: benchmark-meta-score-v1
Es zählen aktive Messwerte aus geprüften Primärquellen, wenn mindestens fünf Modelle im selben dokumentierten Vergleichsschnitt aus Datensatz, Harness, Agent, Werkzeugen und Versuchsanzahl verglichen werden. Pro Benchmark-Reihe und Auswerter zählt ein gemeinsamer Setup-Schnitt aus dem neuesten Abruf; bei gleichem Datum wird der breitere Schnitt verwendet. Bei mehreren ausdrücklich erfassten Reasoning-Stufen derselben Quelle und Testreihe zählt die höchste dokumentierte Stufe (none bis max), nicht der höchste Ergebniswert. Die ausdrückliche Quellenangabe „Non-reasoning“ entspricht none. Bei dieser Auswahl zwischen mehreren Ergebnissen führen unbekannte oder mehrdeutige Stufen zum Ausschluss des Modells aus der betreffenden Reihe. Eindeutige Einzelkonfigurationen benötigen keine Stufenreihenfolge. Das jeweils beste Einzelergebnis eines Modells wird nicht ausgewählt. Rangperzentile mit gleichen Rohwerten teilen sich dasselbe Perzentil. Mehrere Reihen desselben Auswerters innerhalb einer Testfamilie werden gleich gewichtet, danach werden Auswerter in der Testfamilie, Testfamilien im Bereich und Bereiche im Gesamtindex jeweils gleich gewichtet. Nicht gemessene Reihen bleiben in Abdeckung und Grenzen sichtbar. Ein Gesamtwert erfordert mindestens vier Bereiche, sechs Testfamilien und zwei Quellen. Ein Bereichswert erfordert mindestens zwei Testfamilien. Jeder Gesamt- und Bereichsscore benötigt außerdem mindestens 50 % des jeweiligen Panelgewichts.
Veröffentlichte modellabhängige Parameter können abweichen. Das ist kein kontrolliertes Experiment; solche Vergleiche werden als vorläufig gekennzeichnet.
Nicht gemessene Anteile werden nicht als Nullwert eingesetzt. Sie senken die Abdeckung und fließen nur in die ausgewiesenen Grenzen ein. Werte aus unterschiedlichen Abdeckungen sind daher nicht unmittelbar gleich vollständig.
Die Grenzen halten die vorhandenen Perzentile fest und setzen für fehlende Beiträge beliebige Werte von 0 bis 100 an. Sie sind keine Konfidenzintervalle und keine Prognose für spätere Neuberechnungen.
Die Quellenzahl ist keine Anzahl unabhängiger Experimente.
OECD-Handbuch zu zusammengesetzten IndikatorenAlle 46 Testfamilien und 12 von 51 Rohmesswerten sind hier aufgeführt. Die vollständige Rechnung für alle Modelle enthält der JSON-Export.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 83 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 7,14 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 3,57 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 3,57 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Jeder Auswerter misst andere Fähigkeiten unter eigenen Bedingungen. Testreihen, Gesamtindizes und ihre Komponenten bleiben getrennt. Die Ergebnisse darunter behalten ihre Skalen, Konfigurationen und Quelldaten.
| Auswerter | Testreihen | Gesamtindizes | Erfasste aktive Messwerte |
|---|---|---|---|
| Artificial Analysis | 13 | 1 | 28 |
| Vals AI | 31 | 2 | 228 |
| LMArena | 2 | 0 | 34 |
| Epoch AI | 6 | 0 | 12 |
Die Abdeckung ist keine Qualitätsrangliste. Überschneidende Tests und mehrere Einstellungen zählen nicht als unabhängige Versuche. Herstellerangaben, historische und strittige Ergebnisse bleiben außerhalb dieser Übersicht und sind in den Detailbelegen gekennzeichnet.
Seite 1 von 31
Accepted cases
1.029 deutsche Aufgaben prüfen die Übersetzung von Standarddeutsch in eine festgelegte einfache Sprachspezifikation. Der Test misst die Alman-Spezifikation, nicht allgemeine deutsche Textqualität.
höhere Werte sind besserStand 9. August 2026Skala: 0 % - 100 %
Overall
Langfristige Softwareaufgaben mit ausführbaren Projekttests. Modell, Reasoning-Stufe und Agent gehören gemeinsam zum Ergebnis. Die Herstellertabelle enthält abweichende Werte.
Hinweis (Kimi K3): Der Wert bewertet die genannte Kombination aus Modell, Reasoning-Stufe und Agent, nicht einen isolierten Modelllauf.
Hinweis: Der Wert bewertet die genannte Kombination aus Modell, Reasoning-Stufe und Agent, nicht einen isolierten Modelllauf.
Hinweis: Der Wert bewertet die genannte Kombination aus Modell, Reasoning-Stufe und Agent, nicht einen isolierten Modelllauf.
Hinweis: Der Wert bewertet die genannte Kombination aus Modell, Reasoning-Stufe und Agent, nicht einen isolierten Modelllauf.
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
SWE-bench
höhere Werte sind besserStand 11. August 2026Skala: 0 % - 100 %
SWE-bench
höhere Werte sind besserStand 15. Oktober 2026Skala: 0 % - 100 %
Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.
Seite 1 von 31
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
Kimi K3
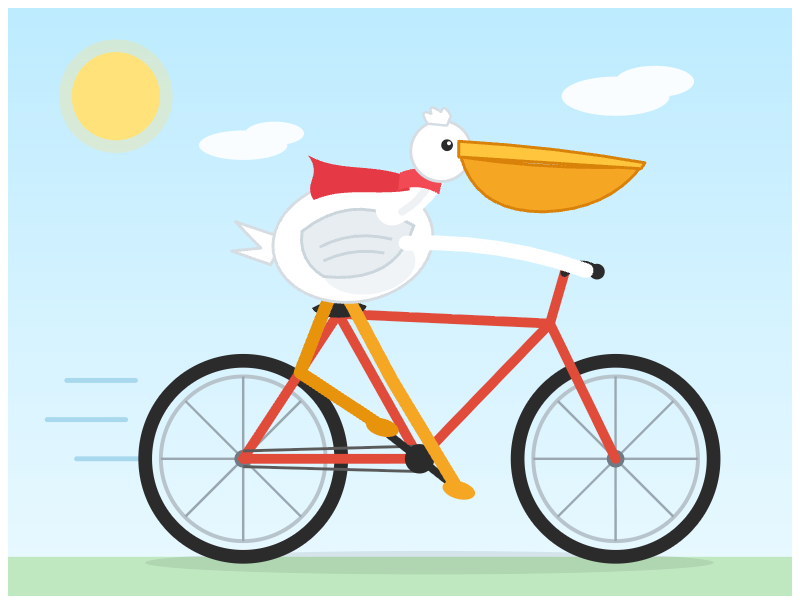
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)68,5 / 100