Zum Hauptinhalt springen

XiaomiSprachmodellAktiv

MiMo V2.6 Flash

MiMo V2.6 Flash liegt im oberen Mittelfeld: Platz 31 von 91 im Gesamtindex. Per API ist es günstig.

LeistungPlatz 31 von 91

98,3Gesamtindexhöher ist besser

TempoPlatz 94 von 100

35Token pro Sekundehöher ist besser

PreisPlatz 6 von 94

Eingabe 0,14 $ · Ausgabe 0,28 $

0,18 $je 1 Mio. Tokenniedriger ist besser

Kontextk. A.

k. A.Token auf einmal

BeliebtheitPlatz 391 von 875

34von 100wie im Vormonat

Zusammenfassung

Es ist günstig: 0,18 $ je 1 Mio. Token (Eingabe und Ausgabe gemischt), ein typisches Modell kostet 1,56 $. Mit 35 Token pro Sekunde schreibt es langsamer als ein typisches Modell (87).

MiMo V2.6 Flash ist Xiaomis kleinere V2.6-Klasse für häufige, kostensensible Agentenaufrufe. Die offene Flash-RL-Version nutzt eine Sparse-MoE-Basis mit rund 309 Milliarden Parametern und 15 Milliarden aktiven Parametern. Die Reihe bleibt multimodal und auf lange Kontexte sowie Reasoning ausgerichtet.

Wie bei MiMo V2.6 Pro führt Xiaomi die API als mimo-v2.6-flash und den lokalen Checkpoint als MiMo-V2.6-Flash-RL. Flash ist die kleinere Produkt- und Checkpoint-Klasse für häufige Aufrufe innerhalb der V2.6-Reihe.

Benchmarks von MiMo V2.6 Flash

Gesamtindex (Gradually Meta-Score v4)

20 von 91 Modellen

4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

Tempo

20 von 100 Modellen

Mercury 2.5576Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.1 Flash-Lite336Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash-Lite299Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Nemotron 3.5 Lightning245Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Haiku 5.5236Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
o3-mini230Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Ling 3.0 Flash199Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V3 0324195Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 mini191Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3 Flash Preview191Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash184Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.6 Flash182Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Command A Plus177Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V4.1-Flash176Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek V4.1 Flash 1017172Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Qwen 3.7 Max165Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 nano153Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 20B152Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 120B151Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
MiMo V2.6 Flash35Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06

Ausgabe-Token pro Sekunde, gemessen von Artificial Analysis

Leistung gegen Preis

lohnendster Bereich: stärker und günstiger als die Hälfte der gezeigten Modellebeste Leistung für den Preis

801001200,10 $0,50 $2 $10 $20 $Gemini 3.6 Flash: 96,7, 1,50 $Step 5 Preview: 97,3, 1,43 $Claude Opus 4.8: 99,0, 10 $DeepSeek-V4.1-Flash: 99,7, 0,26 $Qwen 3.8 Max 0902: 100,3, 2,48 $GLM-5.3: 100,7, 2,15 $GPT-5.6 Terra: 100,7, 4,50 $MiMo V2.6 Pro: 100,9, 0,54 $GPT-5.5: 100,9, 11,25 $Kimi K3: 101,2, 6 $Grok 4.6: 102,4, 3 $Grok 4.7: 103,3, 3 $Claude Haiku 5.5: 103,4, 0,20 $GPT-6.1 Terra: 105,2, 2 $Gemini 3.8 Flash: 106,5, 1,50 $DeepSeek V4.1 Flash 1017: 106,6, 0,26 $Muse Spark 1.3: 107,4, 2 $GPT-5.6 Sol: 108,7, 8 $GPT-6 Sol: 110,6, 4 $Claude Fable 5: 112,5, 20 $Kimi K3.1 Pro: 112,9, 4 $Muse Wonder: 113,4, 8 $Claude Opus 5: 117,2, 10 $GPT-6.1 Sol: 119,2, 4 $GPT-6 Astra: 121,3, 20 $Gemini 4 Argon: 122,3, 4 $Claude Sonnet 5.5: 122,8, 4 $Claude Fable 5.1: 123,8, 20 $Claude Opus 5.5: 126,1, 8 $MiMo V2.6 Flash: 98,3, 0,18 $MiMo V2.6 FlashClaude Opus 5.5Claude Fable 5.1Claude Sonnet 5.5Gemini 4 ArgonGPT-6 AstraGPT-6.1 SolClaude Opus 5Muse WonderKimi K3.1 ProClaude Fable 5GPT-6 SolGPT-5.6 SolMuse Spark 1.3DeepSeek V4.1 Flash 1017Gemini 3.8 FlashGPT-6.1 TerraClaude Haiku 5.5Grok 4.7Grok 4.6Kimi K3GPT-5.5MiMo V2.6 ProGPT-5.6 TerraGLM-5.3Qwen 3.8 Max 0902DeepSeek-V4.1-FlashClaude Opus 4.8Step 5 PreviewGemini 3.6 FlashPreis je 1 Mio. Token (Mischpreis)Gesamtindex

MiMo V2.6 Flash nach Aufgabenbereich

Punkte, 100 = Durchschnitt der Referenzgruppe · höher ist besser

FinanzenPlatz 21 von 96104,8
RechtPlatz 23 von 66103,7
AgentenPlatz 21 von 83103,6
AllgemeinPlatz 26 von 6099,9
Mathematikzu wenig Daten98,6
ProgrammierenPlatz 32 von 9098,0
GesundheitPlatz 29 von 6895,2
SchlussfolgernPlatz 40 von 5894,5
Multimodalzu wenig Daten93,4
Wissenzu wenig Daten91,3

Heller Balken: noch zu wenig Ergebnisse für einen Platz.

Alle 580 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 49

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

AutomationBench-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
64.05168250285656
Bewertung
64.05168250285656
Messgröße
Objectives completed without guardrail violations
Einheit
%
Benchmark-Version
AA private 657-task split of AutomationBench v1.0.6
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 64,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-automationbench-aa:AA private 657-task split of AutomationBench v1.0.6:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
AutomationBench-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
64.05168250285656
Bewertung
64.05168250285656
Messgröße
Objectives completed without guardrail violations
Einheit
%
Benchmark-Version
AA private 657-task split of AutomationBench v1.0.6
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 64,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-automationbench-aa:AA private 657-task split of AutomationBench v1.0.6:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
CritPt v2 (Hard Subset): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
29.5
Bewertung
29.5
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2 hard subset
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 29,5 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2-hard-subset:v2 hard subset:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dies sind 40 schwierige Fragen aus CritPt v2, nicht der vollständige 70-Fragen-Lauf von CritPt v2.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
CritPt v2 (Hard Subset): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
29.5
Bewertung
29.5
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2 hard subset, November 2026 grading
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 29,5 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-critpt-v2-hard-subset:v2 hard subset, November 2026 grading:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Einordnung
Dies sind 40 schwierige Fragen aus CritPt v2, nicht der vollständige 70-Fragen-Lauf von CritPt v2.
Quelle Artificial Analysis
CritPt v2: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
12
Bewertung
12
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
disputed
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled. Angezeigter Wert: 12,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2:v2:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled
Einordnung
Die AA-Quelle enthält hier den ursprünglichen CritPt-Wert. Die frühere Zuordnung zu CritPt v2 ist falsch; Wert und frühere Beschriftung bleiben als strittiger Altbeleg erhalten.. Der Quelldatensatz markiert diesen Wert als umstritten. Er bleibt als dokumentierte Evidenz sichtbar, ist aber kein belastbarer Vergleichsnachweis.
Quelle Artificial Analysis
FrontierCode: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
21.6152272727273
Bewertung
21.6152272727273
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
2.0
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 21,6 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-frontiercode-2-0:2.0:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
FrontierCode: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
21.6152272727273
Bewertung
21.6152272727273
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
2.0
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 21,6 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-frontiercode-2-0:2.0:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
FrontierCode 1.1 Main: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
42.0675333333333
Bewertung
42.0675333333333
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
1.1 Main
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled. Angezeigter Wert: 42,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-frontiercode:1.1 Main:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled
Einordnung
FrontierCode 1.1 Main ist eine private 100-Aufgaben-Auswahl aus 150 Aufgaben. Die Werte sind AA-Mittelwerte der Rubrikpunkte, keine reine Erfolgsquote.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
FrontierCode 1.1 Main: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
42.0675333333333
Bewertung
42.0675333333333
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
1.1 Main
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled. Angezeigter Wert: 42,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-frontiercode:1.1 Main:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled
Einordnung
FrontierCode 1.1 Main ist eine private 100-Aufgaben-Auswahl aus 150 Aufgaben. Die Werte sind AA-Mittelwerte der Rubrikpunkte, keine reine Erfolgsquote.
Quelle Artificial Analysis
GDP.pdf: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
9
Bewertung
9
Messgröße
All-pass rate
Einheit
%
Benchmark-Version
unspecified
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 9,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-gdp-pdf:unspecified:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
GDP.pdf: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
9
Bewertung
9
Messgröße
All-pass rate
Einheit
%
Benchmark-Version
unspecified
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 9,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-gdp-pdf:unspecified:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
HLE-Diamond: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
13.700000000000001
Bewertung
13.700000000000001
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
Diamond
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/127de816-57d3-4037-8484-480a613cd413/mimo-v2-6-flash/mimo-v2-6-flash. Name des Quellmodells: MiMo V2.6 Flash. Anbieter laut Quelle: Xiaomi. Modellstand: MiMo-V2.6-Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 13,7 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-hle-diamond:Diamond:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: MiMo-V2.6-Flash (Release mimo-v2-6-flash, Zeile mimo-v2-6-flash, UUID 127de816-57d3-4037-8484-480a613cd413, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis

Seite 1 von 49

Selbst ansehen: ein Auftrag, ein Versuch

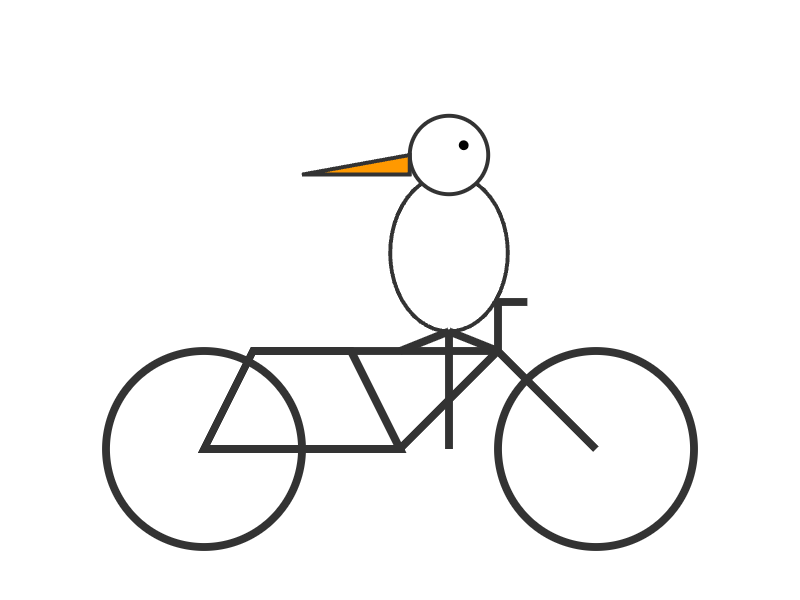
SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

MiMo V2.6 Flash

MiMo V2.6 Flash: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0002 $

Testdetails
Testlauf
14.10.2026
Anbieter
xiaomi/fp8
API-Modell
xiaomi/mimo-v2.6-flash
Ausgabe
529 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0002 $
Testrunde
43b8c5c46830
Frühere Tests
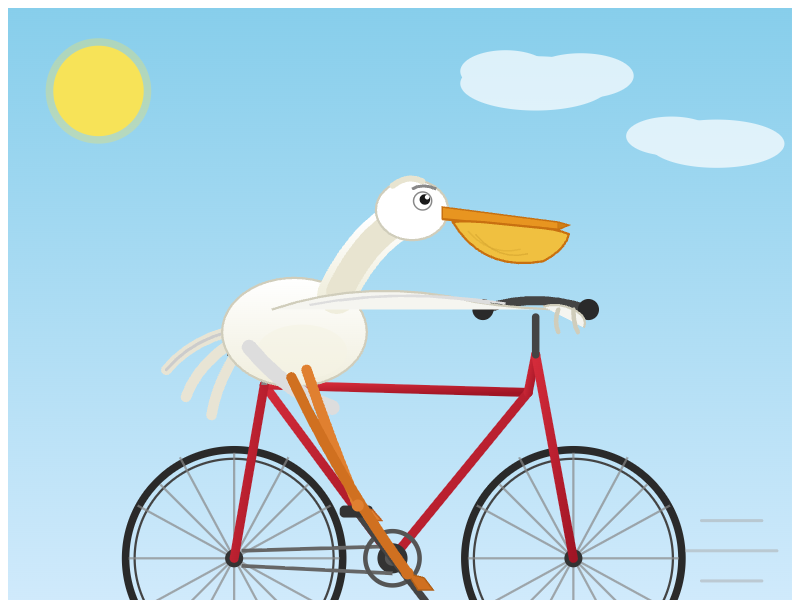
MiMo V2.6 Flash: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

02.10.2026 · 76 s · 0,0021 $

Testdetails
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
xiaomi/mimo-v2.6-flash
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
7.377 Token
Kosten des Versuchs
0,0021 $
Antwortzeit
76,4 s
API-Modell laut Antwort
xiaomi/mimo-v2.6-flash
Festgelegter Endpunkt
Xiaomi | xiaomi/mimo-v2.6-flash-20260921
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)

  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Ursprung der Aufgabe: Simon Willison

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 5. November 2026

MiMo V2.6 FlashQwen 3 Next 80B A3B InstructMixtral 8x22BReka Flash 3Amazon Nova Pro

Alle technischen Daten

Architektur

Modellklasse
Omnimodales Reasoning-Modell
Quelle: Modellklasse
Offener Checkpoint
MiMo-V2.6-Flash-RL, MIT-Lizenz
Quelle: Offener Checkpoint

Ein- und Ausgabe

Modalitäten
Text, Bild, Video und Audio
Quelle: Modalitäten

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Zugang
API und lokale Ausführung
Quelle: Zugang

API

API-Modellkennung
mimo-v2.6-flash
Quelle: API-Modellkennung

Weitere Angaben

API und Checkpoint
API-Kennung und offener RL-Checkpoint haben unterschiedliche Namen. Der Anbieter dokumentiert keine Gleichsetzung ihrer Auslieferungskonfigurationen.
Quelle: API und Checkpoint
Checkpoint-Architektur
Sparse MoE, 309 Mrd. Parameter, 15 Mrd. aktiv
Quelle: Checkpoint-Architektur
Checkpoint-Kontext
1 Mio. Token
Quelle: Checkpoint-Kontext

Preise

Preisansicht wählen

1 Angebot, Preise in US-Dollar je 1 Mio. Token, Mischpreis aus 3 Teilen Eingabe und 1 Teil Ausgabe.

AnbieterEingabeAusgabeCache lesenMischpreis
Xiaomidirekt0,14 $0,28 $0,0028 $0,18 $

Direktpreis laut Hersteller, geprüft am 25.10.2026. Zum LLM-Preisindex

Weitere Preisstufen und Regeln
Cache-Preis
0,0028 US$ / 1 Mio. Token, Overseas-Echtzeit-API, CachetrefferQuelle
Eingabe-Preis
0,14 US$ / 1 Mio. Token, Overseas-Echtzeit-API, Cache MissQuelle
Ausgabe-Preis
0,28 US$ / 1 Mio. Token, Overseas-Echtzeit-APIQuelle
Batch-Eingabe-Preis
0,07 US$ / 1 Mio. Token, Overseas-Batch-APIQuelle
Batch-Ausgabe-Preis
0,14 US$ / 1 Mio. Token, Overseas-Batch-APIQuelle

Kein Abo von Xiaomi mit diesem Modell. Über andere Anbieter ab ≈ 1,06 € im Monat (Command Code Go, mit begrenztem Guthaben). 10 Tarife in Deutschland.

TarifPreis im MonatHinweis
Command Code Go≈ 1,06 €mit begrenztem Guthaben
Poe Basic6,83 €mit begrenztem Guthaben
Command Code GOAT≈ 10,60 €mit begrenztem Guthaben
Command Code Pro≈ 21,20 €mit begrenztem Guthaben
Poe Plus27,36 €mit begrenztem Guthaben
Poe Pro68,41 €mit begrenztem Guthaben
Command Code Max 10×≈ 106,02 €mit begrenztem Guthaben
Poe Advanced136,84 €mit begrenztem Guthaben
Command Code Max 20×≈ 212,05 €mit begrenztem Guthaben
Poe Max342,11 €mit begrenztem Guthaben

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu MiMo V2.6 Flash

Wie gut ist MiMo V2.6 Flash in Benchmarks?

Ordentlich: Platz 31 von 91 im Gesamtindex.

Gesamtindex (Gradually Meta-Score v4) aus 35 Benchmark-Ergebnissen · Daten bis 06.11.2026

LeistungGesamtindex in Punkten, 100 = Durchschnitt der Referenzgruppe · höher ist besser
Qwen 3.8 Max 0902100,3
DeepSeek-V4.1-Flash99,7
Claude Opus 4.899,0
MiMo V2.6 FlashPlatz 3198,3
Step 5 Preview97,3
Gemini 3.5 Flash96,9
Gemini 3.6 Flash96,7

Was ist der Gesamtindex (Gradually Meta-Score v4)?

Ein Punktwert, der viele unabhängige Benchmarks zu einer Zahl zusammenfasst. 100 Punkte sind der Durchschnitt einer festen Referenzgruppe, höher ist besser. MiMo V2.6 Flash erreicht 98,3 Punkte, das ist Platz 31 von 91.

Eigene Auswertung von gradually.ai, Methode benchmark-meta-score-v4 · für MiMo V2.6 Flash aus 35 Testreihen

Welche Daten
Nur aktuelle, geprüfte Ergebnisse unabhängiger Auswerter wie Artificial Analysis, Vals AI, LMArena, LiveBench und Epoch AI. Herstellerangaben sowie historische und strittige Werte zählen nicht.
Ein Wert je Test
Je Quelle und Testreihe zählt der neueste Abruf mit einem festen Aufbau. Testet eine Quelle mehrere Reasoning-Stufen, gilt die höchste dokumentierte. Eine Testreihe braucht mindestens 5 Modelle.
Vergleichbar machen
Prozentwerte werden so umgerechnet, dass Abstände nahe 0 und nahe 100 % fair zählen, danach wird jede Testreihe auf dieselbe Skala gebracht. So wiegt ein schwerer Test nicht mehr als ein leichter.
Gemeinsame Stärke
Ein statistisches Modell schätzt aus allen Testreihen zugleich eine gemeinsame Leistungsfähigkeit je Modell und je Bereich, wie stark ein Modell davon abweicht. Fehlende Tests werden nicht als null gezählt.
Gewichtung
Kernbereiche (Programmieren, Schlussfolgern, Mathematik, Wissen, Agenten, Allgemein und Multimodal) zählen zusammen 75 %, die Fachbereiche Finanzen, Recht und Gesundheit zusammen 25 %.
Die Punkteskala
Der Wert misst sich an einer festen Referenzgruppe aus 29 Modellen, ähnlich wie ein IQ-Wert: 100 Punkte sind ihr Durchschnitt, 15 Punkte eine Standardabweichung der Gruppe. Die Skala ist nach oben und unten offen und kein Prozentwert. Liegt ein Modell 15 Punkte vorn, schneidet es in etwa drei von vier Benchmark-Vergleichen besser ab. Neue Modelle verschieben die alten Werte nicht.
Platz nach Score
Der Platz folgt der Reihenfolge der Scores unter allen Modellen mit Platz, etwa „Platz 14 von 95“. Ob ein Vorsprung belastbar ist, prüft eine zweite Rechnung, die den Score 200-mal mit zufällig neu gezogenen Testfamilien wiederholt. Liegt ein Modell dabei nicht fast immer vorn, gelten zwei Modelle als gleichauf.
Mindestanforderung
Einen Wert gibt es erst ab 8 Testreihen aus 2 Quellen und 3 Bereichen, einen Platz nur bei ausreichender Genauigkeit. Fehlen Kernbereiche, steht der Hinweis „geschätzt“ dabei.
Was er nicht ist
Kein eigener Test von gradually.ai und kein Urteil über jede einzelne Aufgabe. Für eine bestimmte Aufgabe zählen die Bereichswerte und die einzelnen Benchmarks mehr.

Was kostet MiMo V2.6 Flash?

Per API 0,14 $ je 1 Mio. Token Eingabe und 0,28 $ Ausgabe. Das ist günstig.

PreisDollar je 1 Mio. Token, Eingabe und Ausgabe gemischt · niedriger ist besser
MiMo V2.6 FlashPlatz 6 von 940,18 $
DeepSeek-V4.1-Flash0,26 $
Step 5 Preview1,43 $
Gemini 3.6 Flash1,50 $
GLM-5.32,15 $
Qwen 3.8 Max 09022,48 $
Claude Opus 4.810 $

Wie schnell ist MiMo V2.6 Flash?

35 Token pro Sekunde. Das ist langsamer als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
Gemini 3.5 Flash184
Gemini 3.6 Flash182
DeepSeek-V4.1-Flash176
Step 5 Preview132
Claude Opus 4.882
Qwen 3.8 Max 090246
MiMo V2.6 FlashPlatz 94 von 10035

Kann ich MiMo V2.6 Flash lokal nutzen?

Ja, die Gewichte sind offen.

Angaben von Xiaomi

Offene Gewichte
ja
Lizenz
k. A.
Parameter
k. A.
davon aktiv je Token
k. A.

Wo kann ich MiMo V2.6 Flash nutzen?

Nicht im Abo von Xiaomi. Zusammen mit anderen Anbietern sind es 10 Tarife in Deutschland, dazu kommt die API.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei Xiaomi

Kein Abo von Xiaomi mit diesem Modell.

Über andere Anbieter

10 Tarife bei 2 Anbietern, ab ≈ 1,06 € im Monat (Command Code Go), mit begrenztem Guthaben.

Per API

0,14 $ Eingabe, 0,28 $ Ausgabe je 1 Mio. Token.

Quellen und Datenstand

Alle 74 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis12014
Vals AI245262
LMArena0075
Scale AI Evals001
Roboflow Vision Evals0011

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten. 87 Messwerte sind noch keiner Testreihe zugeordnet.

ArtNachweis und Datenstand
Geschwindigkeit

Xiaomi, Reasoning enabled; effort unspecified. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

Preis

API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten.

RecherchestandRecherchestand 15. Oktober 2026. 19 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

evaluation-units-and-run-settings

Hinweis

Die Spalte für das exakte Flash-RL-Modell ist veröffentlicht. Einheiten, Aufgabendaten, Prompt-/Agenten-Harnesses, Inferenz-Aufwand und Quantisierung sind in der Benchmarktabelle nicht angegeben.

Nicht veröffentlicht

serving-checkpoint-and-generation-settings

Hinweis

Die Snapshots identifizieren model_name der Rangliste, veröffentlichen aber weder einen unveränderlichen Serving-Checkpoint noch Reasoning- oder Effort-Einstellung, Prompts oder Decoding-Parameter.

Nicht veröffentlicht

unique-prompt-count

Hinweis

vote_count ist ausdrücklich die Zahl der Modellkämpfe. Die Zahl eindeutiger Prompts wird nicht genannt und nicht aus vote_count abgeleitet.

Ungeklärt

factuality-toggle-state

Hinweis

Die erfasste Text-Teilmenge weist weder Status noch Gewicht des Faktizitäts-Schalters aus. Es wird kein Faktizitätsmodus abgeleitet; die Quellteilmenge bleibt der genaue Geltungsbereich.

Nicht veröffentlicht

served-checkpoint-and-generation-settings

Hinweis

Die erfassten Arena-Zeilen benennen außer ihrem exakten Quellmodell und der Kohorte weder einen unveränderlichen Serving-Checkpoint noch Promptset, Temperatur oder Decoding-Konfiguration.

Ungeklärt

rating-bound-coverage

Hinweis

Die Quelle veröffentlicht rating_lower und rating_upper, hier unverändert übernommen. Die erfasste README nennt weder Konfidenzabdeckung noch Berechnung. Konfidenzprozentsatz und Halbbreite werden nicht abgeleitet.

Ungeklärt

vision-evals-denominator-and-uncertainty

Hinweis

Die Seite zum exakten Modell nennt keine Auswertungszahl und definiert den ±-Wert bei Aufgabenmitteln aus mehreren Läufen nicht.

Ungeklärt

Abweichende DeepSWE-v1.1-Ergebnisse

Hinweis

Der Veröffentlichungsbeitrag nennt 65.7 nach 30 RL-Schritten, die aktuelle offizielle Modellkarte dagegen 67.9. Keine der Quellen enthält genügend Lauf- oder Checkpoint-Metadaten zur Klärung.

Nicht veröffentlicht

GameBench 2 Gruppe Intensive

Hinweis

Diese Gruppe wird laut Quelle vom Modell nicht unterstützt.

Weitere QuelleXiaomi MiMo model release (abgerufen 22. September 2026) · Xiaomi MiMo V2.6 model release · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleXiaomi MiMo V2.6 announcement (abgerufen 22. September 2026; 15. Oktober 2026; 17. Oktober 2026; 28. Oktober 2026) · Xiaomi MiMo V2.6 announcement · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleMiMo V2.6 Flash RL model card (abgerufen 22. September 2026; 15. Oktober 2026; 28. Oktober 2026) · MiMo V2.6 Flash RL model card · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleArtificial Analysis (abgerufen 29. Oktober 2026; 2. November 2026; 6. November 2026)12
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026; 6. November 2026)12345678
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026)12
Weitere QuelleArtificial Analysis (abgerufen 6. November 2026)123
Weitere QuelleVals AI (abgerufen 6. November 2026)1234567891011121314151617181920212223
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 6. November 2026)1234
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 31. Oktober 2026; 6. November 2026)
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 30. Oktober 2026; 31. Oktober 2026)
Weitere QuelleVals AI (abgerufen 28. Oktober 2026; 6. November 2026)
Weitere QuelleTowards AI ToneBench (abgerufen 17. Oktober 2026; 28. Oktober 2026; 30. Oktober 2026)
Weitere QuelleArena leaderboard dataset, raw Text subset (abgerufen 17. Oktober 2026)
Weitere QuelleArena leaderboard dataset, raw Vision subset (abgerufen 17. Oktober 2026)
Weitere QuelleLMArena leaderboard dataset, Text Style Control (abgerufen 17. Oktober 2026)
Weitere QuelleLMArena leaderboard dataset, Vision Style Control (abgerufen 17. Oktober 2026)
Weitere QuelleLMArena leaderboard dataset, Code Arena WebDev (abgerufen 17. Oktober 2026)
Weitere QuelleDataLLM Lab (abgerufen 17. Oktober 2026; 23. Oktober 2026)
Weitere QuelleWhile AI (abgerufen 17. Oktober 2026)
Weitere QuelleXiaomi MiMo-V2.6 technical report (abgerufen 17. Oktober 2026)
Weitere QuelleRoboflow Vision Evals (abgerufen 19. Oktober 2026)
Weitere QuelleDuelLab GameBench 2 model results (abgerufen 28. Oktober 2026; 2. November 2026; 5. November 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 28. Oktober 2026; 5. November 2026)
Weitere QuelleRoboflow Vision Evals (abgerufen 28. Oktober 2026)
Weitere QuelleMathBench.ai (abgerufen 28. Oktober 2026)
Weitere QuelleScale AI HSS (abgerufen 28. Oktober 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 5. November 2026)
Weitere QuelleModellmetadaten (abgerufen 28. Oktober 2026)
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0