Zum Hauptinhalt springen

CohereSprachmodell

Command A Plus

Command A Plus hat einen vorläufigen Gesamtindex von 32,9, aber noch keinen Platz, weil noch zu wenige Ergebnisse für einen festen Platz vorliegen.

Leistungnoch ohne Platz

32,9Gesamtindexhöher ist besser

TempoPlatz 13 von 100

177Token pro Sekundehöher ist besser

Preiskein API-Preis

k. A.je 1 Mio. Tokenniedriger ist besser

KontextPlatz 98 von 102

128 Tsd.Token auf einmal≈ 190 A4-Seiten

BeliebtheitPlatz 463 von 785

33von 100wie im Vormonat

beruht auf Suche, Nutzung und Aufmerksamkeit

Zusammenfassung

Mit 177 Token pro Sekunde schreibt es schneller als ein typisches Modell (87). Geschätzt, ohne eigene Werte in: Mathematik.

Command A Plus erweitert die Command A-Familie zu einem sparsamen Mixture-of-Experts-Modell mit Bildeingaben. Cohere beschreibt es als sein erstes MoE-Modell und nennt agentische Aufgaben, Reasoning, Übersetzung und 48 Sprachen. Das Modell umfasst 218 Milliarden Gesamtparameter und 25 Milliarden aktive Parameter.

Die aktuelle Cohere-Dokumentation nennt 128.000 Token Kontext und bis zu 64.000 Token Ausgabe. Für die Open-Source-Bereitstellung nennt sie Apache 2.0 und als Zielkonfiguration W4A4 auf einer B200 oder zwei H100. Diese Hardwareangabe bezieht sich auf die dokumentierte W4A4-Konfiguration.

Benchmarks von Command A Plus

Tempo

20 von 100 Modellen

Mercury 2.5576Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.1 Flash-Lite336Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash-Lite299Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Nemotron 3.5 Lightning245Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Haiku 5.5236Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
o3-mini230Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Ling 3.0 Flash199Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V3 0324195Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 mini191Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3 Flash Preview191Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash184Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.6 Flash182Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Command A Plus177Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V4.1-Flash176Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek V4.1 Flash 1017172Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Qwen 3.7 Max165Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 nano153Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 20B152Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 120B151Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Sonnet 5.5151Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06

Ausgabe-Token pro Sekunde, gemessen von Artificial Analysis

Command A Plus nach Aufgabenbereich

Punkte, 100 = Durchschnitt der Referenzgruppe · höher ist besser

AllgemeinPlatz 59 von 6549,6
Wissenzu wenig Daten43,9
Multimodalzu wenig Daten38,9
AgentenPlatz 92 von 9838,1
ProgrammierenPlatz 106 von 10935,7
SchlussfolgernPlatz 68 von 7235,0
GesundheitPlatz 71 von 7225,6
Rechtzu wenig Daten25,6
Finanzenzu wenig Daten17,2

Heller Balken: noch zu wenig Ergebnisse für einen Platz. Noch keine Tests: Mathematik.

Alle 132 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 11

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

AutomationBench-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1.8104537047977383
Bewertung
1.8104537047977383
Messgröße
Objectives completed without guardrail violations
Einheit
%
Benchmark-Version
AA private 657-task split of AutomationBench v1.0.6
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 1,8 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-automationbench-aa:AA private 657-task split of AutomationBench v1.0.6:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
AutomationBench-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1.8104537047977383
Bewertung
1.8104537047977383
Messgröße
Objectives completed without guardrail violations
Einheit
%
Benchmark-Version
AA private 657-task split of AutomationBench v1.0.6
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 1,8 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-automationbench-aa:AA private 657-task split of AutomationBench v1.0.6:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
CritPt v2 (Hard Subset): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
2.5
Bewertung
2.5
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2 hard subset
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 2,5 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2-hard-subset:v2 hard subset:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dies sind 40 schwierige Fragen aus CritPt v2, nicht der vollständige 70-Fragen-Lauf von CritPt v2.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
CritPt v2 (Hard Subset): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
2.5
Bewertung
2.5
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2 hard subset, November 2026 grading
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 2,5 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-critpt-v2-hard-subset:v2 hard subset, November 2026 grading:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Einordnung
Dies sind 40 schwierige Fragen aus CritPt v2, nicht der vollständige 70-Fragen-Lauf von CritPt v2.
Quelle Artificial Analysis
CritPt v2: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.28571428571428603
Bewertung
0.28571428571428603
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
disputed
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled. Angezeigter Wert: 0,3 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2:v2:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled
Einordnung
Die AA-Quelle enthält hier den ursprünglichen CritPt-Wert. Die frühere Zuordnung zu CritPt v2 ist falsch; Wert und frühere Beschriftung bleiben als strittiger Altbeleg erhalten.. Der Quelldatensatz markiert diesen Wert als umstritten. Er bleibt als dokumentierte Evidenz sichtbar, ist aber kein belastbarer Vergleichsnachweis.
Quelle Artificial Analysis
FrontierCode: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0
Bewertung
0
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
2.0
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 0,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-frontiercode-2-0:2.0:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
FrontierCode: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0
Bewertung
0
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
2.0
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 0,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-frontiercode-2-0:2.0:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
FrontierCode 1.1 Main: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1.21166666666667
Bewertung
1.21166666666667
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
1.1 Main
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled. Angezeigter Wert: 1,2 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-frontiercode:1.1 Main:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled
Einordnung
FrontierCode 1.1 Main ist eine private 100-Aufgaben-Auswahl aus 150 Aufgaben. Die Werte sind AA-Mittelwerte der Rubrikpunkte, keine reine Erfolgsquote.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
FrontierCode 1.1 Main: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1.21166666666667
Bewertung
1.21166666666667
Messgröße
Mean score over three attempts per task
Einheit
%
Benchmark-Version
1.1 Main
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled. Angezeigter Wert: 1,2 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-frontiercode:1.1 Main:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Die primären 100 Aufgaben aus FrontierCode 1.1 werden je dreimal ausgeführt. Alle Aufgaben zählen gleich. Das Verfehlen einer blockierenden Prüfung oder ein Treffer des Trajectory-Scanners ergibt null; Läufe, die alle blockierenden Prüfungen bestehen, erhalten 70 bis 100 Prozent.. Harness: Artificial Analysis Stirrup. Agent: Stirrup coding agent. Werkzeugrichtlinie: 250-turn cap; repository worktree graded as left by the agent. Versuche: Mean score, 3 attempts per task. Reasoning: reasoning enabled
Einordnung
FrontierCode 1.1 Main ist eine private 100-Aufgaben-Auswahl aus 150 Aufgaben. Die Werte sind AA-Mittelwerte der Rubrikpunkte, keine reine Erfolgsquote.
Quelle Artificial Analysis
GDP.pdf: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1
Bewertung
1
Messgröße
All-pass rate
Einheit
%
Benchmark-Version
unspecified
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 1,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-gdp-pdf:unspecified:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
GDP.pdf: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1
Bewertung
1
Messgröße
All-pass rate
Einheit
%
Benchmark-Version
unspecified
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 1,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-gdp-pdf:unspecified:v5.0.1:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl.. Reasoning: reasoning enabled
Quelle Artificial Analysis
HLE-Diamond: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
5.1
Bewertung
5.1
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
Diamond
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Kennung des Quellmodells: artificial-analysis/2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e/command-a-plus/command-a-plus. Name des Quellmodells: Command A Plus. Anbieter laut Quelle: Cohere. Modellstand: Command A+. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Reasoning: reasoning enabled. Angezeigter Wert: 5,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-hle-diamond:Diamond:v5.0:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Command A+ (Release command-a-plus, Zeile command-a-plus, UUID 2e9ff877-fd2c-4ce7-b631-7ca1bdb6d13e, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit.. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis

Seite 1 von 11

Selbst ansehen: ein Auftrag, ein Versuch

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Command A Plus

Command A Plus: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0015 $

Testdetails
Testlauf
14.10.2026
Anbieter
cohere
API-Modell
cohere/command-a-plus
Ausgabe
999 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0015 $
Testrunde
43b8c5c46830
Frühere Tests
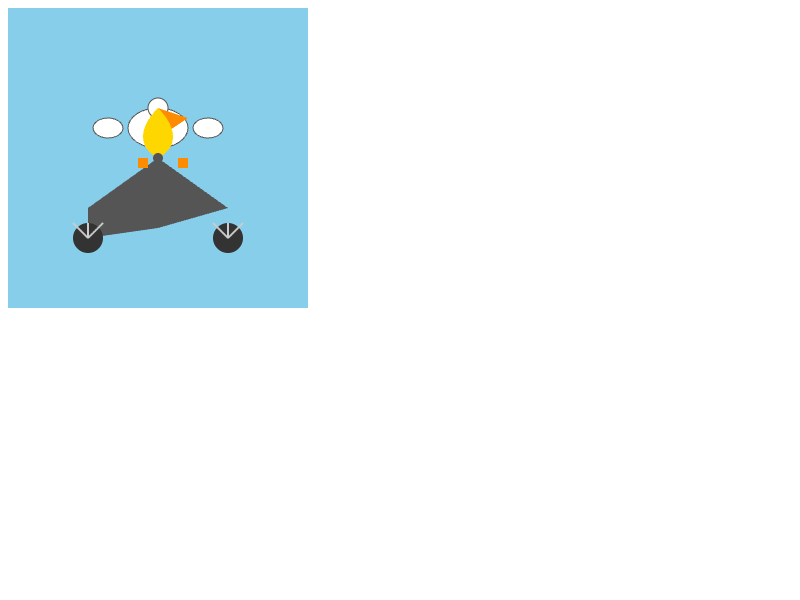
Command A Plus: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

01.10.2026 · 21 s · 0,0072 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
cohere/command-a-plus
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
4.817 Token
Kosten des Versuchs
0,0072 $
Antwortzeit
21 s
API-Modell laut Antwort
cohere/command-a-plus
Festgelegter Endpunkt
Cohere | cohere/command-a-plus-05-2026
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Ursprung der Aufgabe: Simon Willison

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

Command A PlusAmazon Nova Pro 33Aya Expanse 32B 33AREX-2 33Nex-N2-mini 33

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Parameter
218 Mrd.
Quelle: Parameter
Aktive Parameter
25 Mrd.
Quelle: Aktive Parameter
Wissensstand
April 2025
Quelle: Wissensstand

Ein- und Ausgabe

Kontextfenster
128.000 Token
Quelle: Kontextfenster
Maximale Ausgabe
64.000 Token
Quelle: Maximale Ausgabe
Eingaben
Text, Bild
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben
Tool-Aufrufe
Ja
Quelle: Tool-Aufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Offene Gewichte
Quelle: Gewichte
Lizenz
CC BY-NC-4.0
Quelle: Lizenz

Preise

In keinem Abo in Deutschland enthalten.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Command A Plus

Wie gut ist Command A Plus in Benchmarks?

Noch ohne Platz im Gesamtindex, der vorläufige Wert liegt bei 32,9 Punkten. Der Wert ist vorläufig, weil noch zu wenige Ergebnisse für einen festen Platz vorliegen.

Gesamtindex (Gradually Meta-Score v4) aus 17 Benchmark-Ergebnissen · Daten bis 07.11.2026

Was ist der Gesamtindex (Gradually Meta-Score v4)?

Ein Punktwert, der viele unabhängige Benchmarks zu einer Zahl zusammenfasst. 100 Punkte sind der Durchschnitt einer festen Referenzgruppe, höher ist besser. Command A Plus erreicht vorläufig 32,9 Punkte, noch ohne Platz.

Eigene Auswertung von gradually.ai, Methode benchmark-meta-score-v4 · für Command A Plus aus 17 Testreihen

Welche Daten
Nur aktuelle, geprüfte Ergebnisse unabhängiger Auswerter wie Artificial Analysis, Vals AI, LMArena, LiveBench und Epoch AI. Herstellerangaben sowie historische und strittige Werte zählen nicht.
Ein Wert je Test
Je Quelle und Testreihe zählt der neueste Abruf mit einem festen Aufbau. Testet eine Quelle mehrere Reasoning-Stufen, gilt die höchste dokumentierte. Eine Testreihe braucht mindestens 5 Modelle.
Vergleichbar machen
Prozentwerte werden so umgerechnet, dass Abstände nahe 0 und nahe 100 % fair zählen, danach wird jede Testreihe auf dieselbe Skala gebracht. So wiegt ein schwerer Test nicht mehr als ein leichter.
Gemeinsame Stärke
Ein statistisches Modell schätzt aus allen Testreihen zugleich eine gemeinsame Leistungsfähigkeit je Modell und je Bereich, wie stark ein Modell davon abweicht. Fehlende Tests werden nicht als null gezählt.
Gewichtung
Kernbereiche (Programmieren, Schlussfolgern, Mathematik, Wissen, Agenten, Allgemein und Multimodal) zählen zusammen 75 %, die Fachbereiche Finanzen, Recht und Gesundheit zusammen 25 %.
Die Punkteskala
Der Wert misst sich an einer festen Referenzgruppe aus 29 Modellen, ähnlich wie ein IQ-Wert: 100 Punkte sind ihr Durchschnitt, 15 Punkte eine Standardabweichung der Gruppe. Die Skala ist nach oben und unten offen und kein Prozentwert. Liegt ein Modell 15 Punkte vorn, schneidet es in etwa drei von vier Benchmark-Vergleichen besser ab. Neue Modelle verschieben die alten Werte nicht.
Platz nach Score
Der Platz folgt der Reihenfolge der Scores unter allen Modellen mit Platz, etwa „Platz 14 von 95“. Ob ein Vorsprung belastbar ist, prüft eine zweite Rechnung, die den Score 200-mal mit zufällig neu gezogenen Testfamilien wiederholt. Liegt ein Modell dabei nicht fast immer vorn, gelten zwei Modelle als gleichauf.
Mindestanforderung
Einen Wert gibt es erst ab 8 Testreihen aus 2 Quellen und 3 Bereichen, einen Platz nur bei ausreichender Genauigkeit. Fehlen Kernbereiche, steht der Hinweis „geschätzt“ dabei.
Was er nicht ist
Kein eigener Test von gradually.ai und kein Urteil über jede einzelne Aufgabe. Für eine bestimmte Aufgabe zählen die Bereichswerte und die einzelnen Benchmarks mehr.

Bis wann reicht das Wissen von Command A Plus?

Bis April 2025, laut Cohere. Das ist 13 Monate vor der Veröffentlichung.

Angabe von Cohere

Wie groß ist das Kontextfenster von Command A Plus?

128.000 Token. So viel Text liest Command A Plus auf einmal, das sind rund 190 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GLM-5.1200 Tsd.
DeepSeek-V3 0324164 Tsd.
GLM-4.5131 Tsd.
GPT OSS 120B131 Tsd.
Command A PlusPlatz 98 von 102128 Tsd.
DeepSeek-V3.2128 Tsd.
DeepSeek-R1128 Tsd.

Wie schnell ist Command A Plus?

177 Token pro Sekunde. Das ist schneller als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
Gemini 3 Flash Preview191
Gemini 3.5 Flash184
Gemini 3.6 Flash182
Command A PlusPlatz 13 von 100177
DeepSeek-V4.1-Flash176
DeepSeek V4.1 Flash 1017172
Qwen 3.7 Max165

Kann ich Command A Plus lokal nutzen?

Ja, die Gewichte sind offen. Mit 218 Mrd. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von Cohere

Offene Gewichte
ja
Lizenz
CC BY-NC-4.0
Parameter
218 Mrd.
davon aktiv je Token
25 Mrd.

Quellen und Datenstand

Alle 42 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis20034
Vals AI4019

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Geschwindigkeit

Cohere, Reasoning enabled; effort unspecified. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

Eingabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

RecherchestandRecherchestand 15. Oktober 2026. 11 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

evaluation-details

Hinweis

Der Beitrag nennt Methodikhinweise, aber keine vollständigen Aufgabenstände, Versuchszahlen oder Serving-Parameter für diese Zeilen.

Nicht veröffentlicht

AA per-profile sample counts

Originalwortlaut

Evaluator methodology task totals and repeats are published, but the exact Command A+ completed/scored denominator for each model-page field is not. No sampleCount has been populated.

Nicht veröffentlicht

AA model-page benchmark prompts and effort

Originalwortlaut

The profile is marked reasoning-enabled with reasoningTokens=2000, but the source does not bind those fields to each individual evaluation's executed prompt or effort.

Ungeklärt

Artificial Analysis Intelligence Index discrepancy

Originalwortlaut

Cohere's official launch page reports an unversioned index score of 37, while the current exact AA profile reports v4.3.2 value 13.1335002685349. Versions/execution are not comparable from the available record; current AA row is marked disputed.

Ungeklärt

CritPt status

Originalwortlaut

The exact profile exposes a numeric CritPt field, but AA's CritPt evaluator page says Under review with an expert audit underway; excluded rather than treated as a confirmed measurement.

Weitere QuelleArtificial Analysis (abgerufen 29. Oktober 2026; 2. November 2026; 7. November 2026)12
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026; 7. November 2026)12345678
Weitere QuelleArtificial Analysis (abgerufen 17. Oktober 2026; 2. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 7. November 2026)123
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 17. Oktober 2026; 2. November 2026; 7. November 2026)
Weitere QuelleVals AI (abgerufen 7. November 2026)1234
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 30. Oktober 2026; 31. Oktober 2026)
Weitere QuelleCohere Command A+ release evaluation notes (abgerufen 15. Oktober 2026; 17. Oktober 2026)
Weitere QuelleArtificial Analysis, Command A+ model profile (abgerufen 17. Oktober 2026)
Weitere QuelleToneBench, Cohere Command A+ (05-2026) profile (abgerufen 17. Oktober 2026; 20. Oktober 2026; 28. Oktober 2026; 30. Oktober 2026)
Weitere QuelleRed Hat AI, Command A+ 05-2026 FP8 Hugging Face model card, Evaluation > Accuracy table (BF16 comparator column) (abgerufen 18. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 15. Oktober 2026; 17. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)123
Weitere QuelleModellmetadaten (abgerufen 18. Oktober 2026)
Weitere QuelleCohere current model overview · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleCohere Command A Plus documentation · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleCohere Command A Plus model card · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0