
Claude Fable 5
In dieser Runde nicht verfügbar
Anthropic
Claude Fable 5 war ab dem 9. Juni 2026 die allgemein zugängliche Hälfte des Modellkerns, den es mit Claude Mythos 5 teilte. Es war der direkte Vorgänger von Claude Fable 5.1 und verband anspruchsvolle Programmierung, Wissensarbeit und Bildverständnis mit Schutzklassifizierern.
Seine Verfügbarkeit verlief ungewöhnlich. Nach einem Bericht von Amazon-Forschenden über eine Methode, die Fable-5-Schutzvorkehrungen bei der Schwachstellensuche umgehen konnte, führten US-Exportkontrollen zur Sperre vom 12. bis 30. Juni. Fable kehrte am 1. Juli global zurück. Anthropic führt es inzwischen als Legacy-Modell, die API bleibt nach Anbieterangabe verfügbar und verweist für neue Integrationen auf Fable 5.1.
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Zugang | APIQuelle |
| Kontextfenster | 1.000.000 TokenQuelle |
| Knowledge Cutoff | Januar 2026Quelle |
| Hinweise | Mythos-Klasse oberhalb von Opus, das leistungsfähigste breit veröffentlichte Modell, 1M Kontext (neuer Tokenizer, ca. 30 % mehr Token pro Text im Vergleich zu Modellen vor Opus 4.7), 128K Output, ausschließlich adaptives Denken, Sicherheitsklassifizierer mit Rückgriff auf Opus 4.8 bei Verweigerung. Vorübergehend ausgesetzt vom 12. bis 30. Juni 2026 unter einer US-Exportkontrollverordnung, nachdem ein Jailbreak entdeckt wurde; seit dem 1. Juli 2026 wieder allgemein verfügbar.Quelle |
| API-Modellkennung | claude-fable-5Quelle |
| Status laut Quelle | active (legacy)Quelle |
| Veröffentlichung | 2026-06-09Quelle |
| Maximale Ausgabe | 128.000 TokenQuelle |
| Eingabe | Text, imagesQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | adaptive (always on); default highQuelle |
| Wissensstand | 2026-01Quelle |
| Werkzeugaufrufe | JaQuelle |
| Strukturierte Ausgabe | JaQuelle |
Benchmark-Metaanalyse
Diese Gradually-Indizes ordnen ausgewählte veröffentlichte Messwerte auf einer Skala von 0 bis 100 ein. Sie sind keine Prozentgenauigkeit und keine Garantie für ein Ergebnis in deiner Anwendung.
Abrufstände der verwendeten Quellen 2026-08-26 - 2026-10-19
Index 85,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 79,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 88,6 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 98,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 93,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 94,4 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 91,9 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Noch nicht genug Abdeckung für einen Score
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Methodenfassung: benchmark-meta-score-v1
Es zählen aktive Messwerte aus geprüften Primärquellen, wenn mindestens fünf Modelle im selben dokumentierten Vergleichsschnitt aus Datensatz, Harness, Agent, Werkzeugen und Versuchsanzahl verglichen werden. Pro Benchmark-Reihe und Auswerter zählt ein gemeinsamer Setup-Schnitt aus dem neuesten Abruf; bei gleichem Datum wird der breitere Schnitt verwendet. Bei mehreren ausdrücklich erfassten Reasoning-Stufen derselben Quelle und Testreihe zählt die höchste dokumentierte Stufe (none bis max), nicht der höchste Ergebniswert. Die ausdrückliche Quellenangabe „Non-reasoning“ entspricht none. Bei dieser Auswahl zwischen mehreren Ergebnissen führen unbekannte oder mehrdeutige Stufen zum Ausschluss des Modells aus der betreffenden Reihe. Eindeutige Einzelkonfigurationen benötigen keine Stufenreihenfolge. Das jeweils beste Einzelergebnis eines Modells wird nicht ausgewählt. Rangperzentile mit gleichen Rohwerten teilen sich dasselbe Perzentil. Mehrere Reihen desselben Auswerters innerhalb einer Testfamilie werden gleich gewichtet, danach werden Auswerter in der Testfamilie, Testfamilien im Bereich und Bereiche im Gesamtindex jeweils gleich gewichtet. Nicht gemessene Reihen bleiben in Abdeckung und Grenzen sichtbar. Ein Gesamtwert erfordert mindestens vier Bereiche, sechs Testfamilien und zwei Quellen. Ein Bereichswert erfordert mindestens zwei Testfamilien. Jeder Gesamt- und Bereichsscore benötigt außerdem mindestens 50 % des jeweiligen Panelgewichts.
Veröffentlichte modellabhängige Parameter können abweichen. Das ist kein kontrolliertes Experiment; solche Vergleiche werden als vorläufig gekennzeichnet.
Nicht gemessene Anteile werden nicht als Nullwert eingesetzt. Sie senken die Abdeckung und fließen nur in die ausgewiesenen Grenzen ein. Werte aus unterschiedlichen Abdeckungen sind daher nicht unmittelbar gleich vollständig.
Die Grenzen halten die vorhandenen Perzentile fest und setzen für fehlende Beiträge beliebige Werte von 0 bis 100 an. Sie sind keine Konfidenzintervalle und keine Prognose für spätere Neuberechnungen.
Die Quellenzahl ist keine Anzahl unabhängiger Experimente.
OECD-Handbuch zu zusammengesetzten IndikatorenAlle 43 Testfamilien und 12 von 47 Rohmesswerten sind hier aufgeführt. Die vollständige Rechnung für alle Modelle enthält der JSON-Export.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 0,6 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 7,14 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 83 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 50 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,79 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 2,38 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,43 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 3,57 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 3,57 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 1,02 % · Abdeckung dieser Testfamilie: 100 %
Nominales Familiengewicht im Gesamtpanel: 0,48 % · Abdeckung dieser Testfamilie: 100 %
Jeder Auswerter misst andere Fähigkeiten unter eigenen Bedingungen. Testreihen, Gesamtindizes und ihre Komponenten bleiben getrennt. Die Ergebnisse darunter behalten ihre Skalen, Konfigurationen und Quelldaten.
| Auswerter | Testreihen | Gesamtindizes | Erfasste aktive Messwerte |
|---|---|---|---|
| Artificial Analysis | 10 | 1 | 13 |
| Vals AI | 27 | 2 | 211 |
| LMArena | 4 | 0 | 43 |
| LiveBench | 0 | 1 | 8 |
| Epoch AI | 6 | 0 | 12 |
| Scale AI Evals | 3 | 0 | 3 |
Die Abdeckung ist keine Qualitätsrangliste. Überschneidende Tests und mehrere Einstellungen zählen nicht als unabhängige Versuche. Herstellerangaben, historische und strittige Ergebnisse bleiben außerhalb dieser Übersicht und sind in den Detailbelegen gekennzeichnet.
Seite 1 von 25
Regelmäßig erneuerter Mix objektiv bewerteter Aufgaben in sieben Kategorien. Der Gesamtscore gilt nur für den jeweiligen Release und dessen Gewichtung.
| Teilaufgabe | Claude Fable 5 (Dieses Modell) | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.5 |
|---|---|---|---|---|
| Agentic coding | 62,2 (bester Wert dieser Zeile) | 56,2 | 54,9 | 54 |
| Overall | 82,97 (bester Wert dieser Zeile) | 81,05 | 77,94 | 80,19 |
| Coding | 86 (bester Wert dieser Zeile) | 83,9 | 78,2 | 82,1 |
| Data analysis | 80,5 | 79,8 | 79,3 | 81,6 (bester Wert dieser Zeile) |
| Instruction following | 75,8 (bester Wert dieser Zeile) | 71,8 | 64,6 | 70,7 |
| Language | 90,7 (bester Wert dieser Zeile) | 87,7 | 82,9 | 87,4 |
| Mathematics | 96 | 96,2 (bester Wert dieser Zeile) | 94,9 | 95,9 |
| Reasoning | 89,7 | 91,7 (bester Wert dieser Zeile) | 90,6 | 89,7 |
Einheit: Punktehöhere Werte sind besserStand 2. September 2026Quelle: LiveBenchBalken je Zeile skaliert, nicht über Zeilen hinweg
Overall
1.161 komplexe, häufig multimodale Rätsel prüfen kreative Problemlösung außerhalb klar definierter Schulaufgaben. Rätselkompetenz ist ein enger Spezialfall und kein Ersatz für professionelle oder alltägliche Aufgaben.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
600 realistische Finanzfragen mit gewichteten Kriterien, davon 300 im schwierigen Teildatensatz. Ein o4-mini-Juror bewertet die Antworten. Fachliche Richtigkeit und praktische Verlässlichkeit bleiben deshalb getrennte Fragen.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
500 realistische Rechtsfragen mit gewichteten Kriterien aus unterschiedlichen Ländern und Rechtsgebieten. Der Benchmark misst professionelle Antwortqualität, ersetzt aber weder Rechtsprüfung noch menschliche Verantwortung.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Binary resolution, pass@1
20 mehrstündige Repository-Aufgaben prüfen sehr lange Softwarearbeit mit binärem Enderfolg. Die Werte gehören zum v1.0-Agentensystem. SWE-Marathon v1.1 ist seit Juli 2026 veröffentlicht. Dieser Datensatz erfasst ausschließlich v1.0-Ergebnisse.
Hinweis (Claude Fable 5): Zwei Ablehnungen und drei nicht verfügbare Versuche wurden als null gewertet.
höhere Werte sind besserStand 9. August 2026Skala: 0 % - 100 %
Seite 1 von 25
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Fable 5
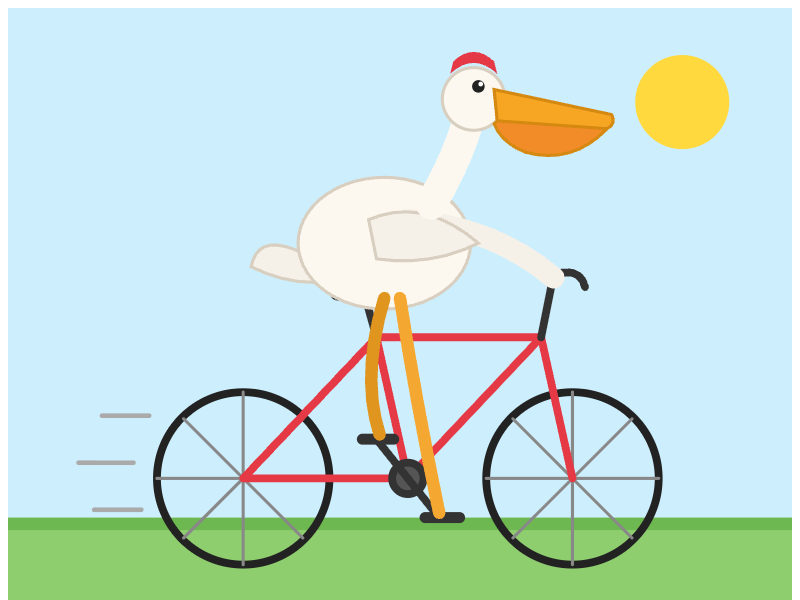
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)59,8 / 100