Zum Hauptinhalt springen

Direktvergleich

Claude Fable 5 vs. Mistral Medium 3.5

Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.

gemeinsame Messreihen
20
verschiedene Benchmarks
20
jüngster Abruf
29.09.2026

Modellauswahl ändern

Steckbrief

Allgemeine Daten

Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.

Allgemeine Daten von Claude Fable 5 und Mistral Medium 3.5
MerkmalClaude Fable 5Mistral Medium 3.5
AnbieterAnthropicMistral AI
Erschienen9. Juni 202628. Apr. 2026
VerfügbarkeitAktivAktiv
ModelltypProprietärOpen Weights
ParameterNicht veröffentlicht128 Mrd.
ArchitekturNicht veröffentlichtDense
Kontextfenster1.000.000 Token262.144 Token
WissensstandJanuar 2026Nicht veröffentlicht
Technische QuellenModell, Kontext, WissensstandModell, Kontext

Kosten

API-Preise im Vergleich

Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.

API-Preise von Claude Fable 5 und Mistral Medium 3.5
PreisartClaude Fable 5Mistral Medium 3.5
API-Eingabe10 $1,5 $
API-Ausgabe50 $7,5 $
Cache lesen1 $Nicht ausgewiesen
Cache schreiben (5 Min.)12,5 $Nicht ausgewiesen
Cache schreiben (1 Std.)20 $Nicht ausgewiesen
Preis geprüft22.09.2026 Quelle22.09.2026 Quelle
Claude Fable 5Mistral Medium 3.5
API-EingabeUSD pro 1 Mio. Token, Basistarif
Claude Fable 510 $
Mistral Medium 3.5Günstiger1,5 $
API-AusgabeUSD pro 1 Mio. Token, Basistarif
Claude Fable 550 $
Mistral Medium 3.5Günstiger7,5 $

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Preise nach Anbieter

Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.

Anbieterpreise von Claude Fable 5 und Mistral Medium 3.5
ModellAnbieterBezugsweg und TarifEingabe pro 1 Mio. TokenAusgabe pro 1 Mio. TokenQuelle
Claude Fable 5AnthropicDirekt beim EntwicklerStandard-APIGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle22.09.2026
Amazon BedrockÜber OpenRouteramazon-bedrockGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle02.10.2026
AnthropicÜber OpenRouteranthropicGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle02.10.2026
AzureÜber OpenRouterazureGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle02.10.2026
Claude Platform on AWSÜber OpenRouterclaude-on-awsGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle02.10.2026
GoogleÜber OpenRoutergoogle-vertex/europe11 $55 $Quelle02.10.2026
GoogleÜber OpenRoutergoogle-vertex/globalGünstigster erfasster Preis: 10 $Günstigster erfasster Preis: 50 $Quelle02.10.2026
Mistral Medium 3.5Mistral AIDirekt beim EntwicklerStandard-APIGünstigster erfasster Preis: 1,5 $Günstigster erfasster Preis: 7,5 $Quelle22.09.2026
MistralÜber OpenRoutermistralGünstigster erfasster Preis: 1,5 $Günstigster erfasster Preis: 7,5 $Quelle02.10.2026
MistralÜber OpenRoutermistral/eu1,65 $8,25 $Quelle02.10.2026
MistralÜber OpenRoutermistral/zdrGünstigster erfasster Preis: 1,5 $Günstigster erfasster Preis: 7,5 $Quelle02.10.2026

Leistung

Gemeinsame Benchmarks

Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.

Fähigkeitsprofil aus vergleichbaren Benchmarks

Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.

255075100CodingReasoningMathematikWissenFinanzenRechtAgenten-AufgabenGesundheit
Claude Fable 5
Mistral Medium 3.5
Coding: 100 / 27,5 (3 Benchmarkfamilien)
Reasoning: 100 / 37,4 (1 Benchmarkfamilie)
Mathematik: 100 / 9,5 (1 Benchmarkfamilie)
Wissen: 100 / 82,3 (1 Benchmarkfamilie)
Finanzen: 100 / 53,9 (6 Benchmarkfamilien)
Recht: 100 / 11,1 (2 Benchmarkfamilien)
Agenten-Aufgaben: 100 / 48,4 (1 Benchmarkfamilie)
Gesundheit: 100 / 68,4 (2 Benchmarkfamilien)

20 passende Messreihen aus 20 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 10 vergleichbaren Kategorien.

Claude Fable 5Mistral Medium 3.5
Code MigrationOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner55,065 %
Mistral Medium 3.55,127 %
CorpFin v2Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner71,834 %
Mistral Medium 3.558,78 %
EMBOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner73,666 %
Mistral Medium 3.511,185 %
Finance Agent (v2)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner56,314 %
Mistral Medium 3.532,103 %
GPQA DiamondOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner93,182 %
Mistral Medium 3.534,848 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner11,25 %
Mistral Medium 3.50,417 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner49,519 %
Mistral Medium 3.59,135 %
MedCodeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner56,07 %
Mistral Medium 3.533,752 %
MedScribeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner88,522 %
Mistral Medium 3.567,728 %
MMLU-ProOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner91,502 %
Mistral Medium 3.575,335 %
MortgageTaxOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner68,919 %
Mistral Medium 3.528,895 %
ProofBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Fable 5Gewinner95 %
Mistral Medium 3.59 %

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Benchmarkwerte von Claude Fable 5 und Mistral Medium 3.5
Benchmark und AufgabeClaude Fable 5Mistral Medium 3.5Quelle
Code MigrationOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner55,065 %
5,127 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
CorpFin v2Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner71,834 %
58,78 %
Vals AI
Quellendetails
Datenstand: 12.08.2026
EMBOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner73,666 %
11,185 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Finance Agent (v2)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner56,314 %
32,103 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
GPQA DiamondOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner93,182 %
34,848 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Harvey's Legal Agent BenchmarkOverall · Task fully resolved
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besser
Gewinner11,25 %
0,417 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Legal Research BenchOverall · All-pass
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besser
Gewinner49,519 %
9,135 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
MedCodeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner56,07 %
33,752 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MedScribeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner88,522 %
67,728 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MMLU-ProOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner91,502 %
75,335 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
MortgageTaxOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner68,919 %
28,895 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
ProofBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner95 %
9 %
Vals AI
Quellendetails
Datenstand: 28.09.2026
SAGEOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner51,89 %
37,613 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
SWE-bench VerifiedOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner95 %
66,4 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Tax Agent BenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner69,822 %
27,291 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
TaxEval v2Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner76,942 %
67,988 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Terminal-Bench 2.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner80,524 %
38,951 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vals IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: weighted index scoreBewertung: Mehr ist besser
Gewinner66,036 %
17,947 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vals Multimodal IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.2Messgröße: weighted index scoreBewertung: Mehr ist besser
Gewinner74,154 %
34,768 %
Vals AI
Quellendetails
Datenstand: 11.08.2026
Vibe Code Bench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands
Gewinner90,352 %
2,888 %
Vals AI
Quellendetails
Datenstand: 27.09.2026

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Eigene Modelltests

Unsere Tests

Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.

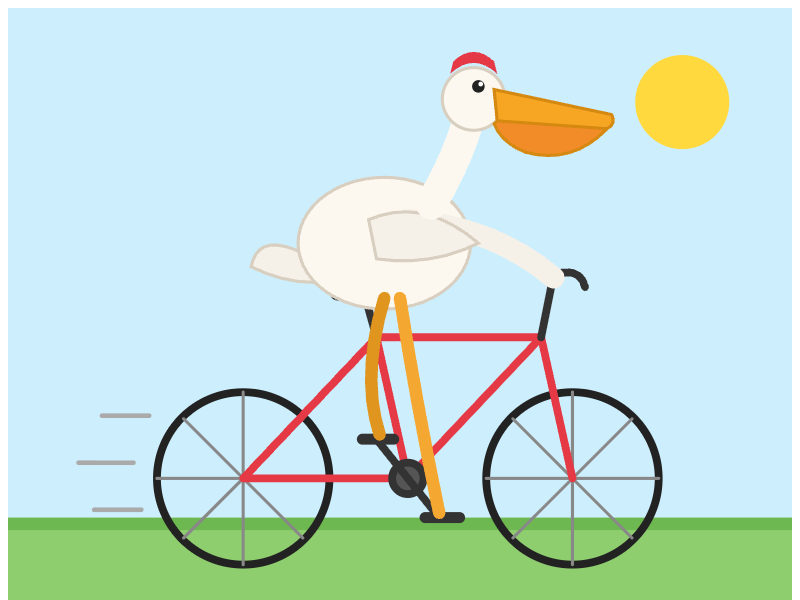
Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

Claude Fable 5

Claude Fable 5: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-fable-5
API-Modell laut Antwort
anthropic/claude-fable-5
Reasoning-Einstellung
high
Festgelegter Endpunkt
Anthropic | anthropic/claude-5-fable-20260609
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
53,1 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Mistral Medium 3.5

In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.

Reasoning (angefragt): high

Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
mistralai/mistral-medium-3-5
Reasoning-Einstellung
high
Festgelegter Endpunkt
Mistral | mistralai/mistral-medium-3.5-20260430
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)

So liest du den Vergleich

Ein Benchmark-Sieg ist kein Gesamturteil

Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.

Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.

Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.

Weitere Duelle

Vergleiche Claude Fable 5 und Mistral Medium 3.5 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.

Zum vollständigen LLM-Vergleich