
GLM-5.2
Z.ai
Das Besondere an GLM-5.2 ist sein 1-Mio.-Token-Fenster in Verbindung mit einer Mixture-of-Experts-Architektur. Z.ai nennt Dynamic Sparse Attention, IndexShare und Multi-Token Prediction als Bausteine des offen verfügbaren Flagship-Modells. Der lange Kontext ist damit für Aufgaben gedacht, die ihren Zustand über große Dokumente und viele Schritte behalten.
GLM-5.3 ist als direktes Update auf derselben Basis eingeordnet; die Gewichte bleiben ein eigener Zugangsweg. Der dokumentierte Nachfolger ändert damit die Modellidentität, nicht die Herkunft der Basis.
Der Index mittelt Rangperzentile aus 10 dokumentierten Vergleichskohorten.
Seite 1 von 18
Overall
502 technische Entscheidungspunkte aus Engineering- und Forschungsabläufen. Jedes Fragenpaar wird in beiden Antwortreihenfolgen vorgelegt. Der Gesamtscore mittelt Engineering und Forschung und verlangt, dass beide Reihenfolgen richtig beantwortet werden. Nicht parsebare Antworten zählen als falsch. Reasoning-Einstellung und Ausgabegrenze gehören zum Testaufbau.
Hinweis (GLM-5.2): 17 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 10 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 0 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 3 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 2 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 112 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 24 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 93 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
Hinweis: 459 von 1.004 Antworten waren nicht parsebar und wurden als falsch gewertet. Kein Gradually-Test.
höhere Werte sind besserStand 26. September 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
| Teilaufgabe | GLM-5.2 (Dieses Modell) | Claude Opus 5 | GLM-5.1 |
|---|---|---|---|
| Exact Pages | 63,64 % | 68,65 % (bester Wert dieser Zeile) | 61,77 % |
| Max Fitting Context | 68,42 % | 75,99 % (bester Wert dieser Zeile) | 66,32 % |
| Shared Max Context | 66,32 % | 74,94 % (bester Wert dieser Zeile) | 65,27 % |
höhere Werte sind besserStand 11. August 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
| Teilaufgabe | GLM-5.2 (Dieses Modell) | GPT-5.6 Sol | Claude Opus 5 | GPT-5.4 | GPT-5.5 | Gemini 3.5 Flash | DeepSeek-V4-Pro | GPT-5.6 Luna | DeepSeek-V4-Flash | Kimi K2.6 | Gemini 3.1 Pro Preview | Grok 4.3 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Patch | 81,03 % | 83,05 % (bester Wert dieser Zeile) | 81,36 % | 81,36 % | 81,36 % | 81,03 % | 79,66 % | 79,66 % | 72,41 % | 71,43 % | 69,49 % | 64,41 % |
| PoC | 73,68 % | 93,22 % (bester Wert dieser Zeile) | 0 % | 64,41 % | 79,66 % | 57,63 % | 57,63 % | 88,14 % | 61,02 % | 77,27 % | 3,39 % | 30,51 % |
höhere Werte sind besserStand 11. August 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg
Seite 1 von 18
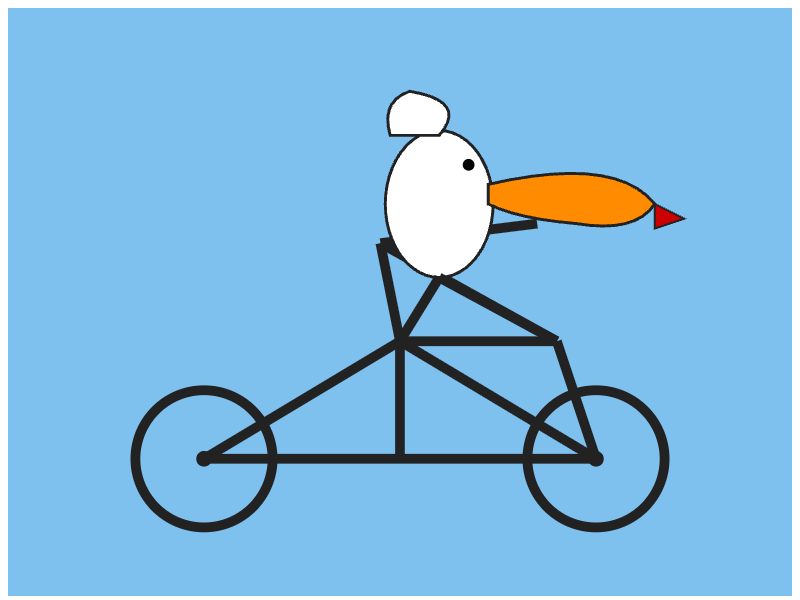
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
GLM-5.2
Ausgabe aus Sicherheitsgründen nicht dargestellt
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)52,9 / 100
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | Open WeightsQuelle |
| Zugang | API, LokalQuelle |
| Parameter | 744 Mrd.Quelle |
| Aktive Parameter | 40 Mrd.Quelle |
| Kontextfenster | 1.000.000 TokenQuelle |
| Hinweise | Veröffentlicht am 16. Juni 2026, 744B Parameter insgesamt, 40B aktiv, 1M Kontext, MIT-lizenzierte GewichteQuelle |
| Lizenz | MITQuelle |
| Eingabe | TextQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | thinking, non-thinkingQuelle |
| Werkzeugaufrufe | JaQuelle |
| API-Modellkennung | glm-5.2Quelle |
| Architektur | MoE with IndexShare sparse attention and MTPQuelle |