Ein menschlicher Text, den ich selbst in einen KI-Detektor eingefügt habe, kam als „KI-generiert“ zurück. Der Detektor gehörte ausgerechnet zu meiner eigenen Website.
Also habe ich Pangram, GPTZero, ZeroGPT, QuillBot, Detecting AI und Sapling mit deutschen und englischen Sachtexten ausprobiert. Meinen inzwischen entfernten Gradually-Detektor habe ich mit denselben vollständigen Texten gefüttert, die ich bei Pangram, GPTZero, ZeroGPT, QuillBot und Detecting AI geprüft habe.
- Pangram ordnete meine sechs vollständigen Texte richtig als menschlich, KI oder gemischt ein. Im englischen Mischtext markierte es den Anfang der KI-Passage trotzdem als menschlich.
- GPTZero und QuillBot erkannten die vier reinen Texte. Die Mischtexte hielten sie überwiegend oder vollständig für menschlich.
- ZeroGPT, Detecting AI und Sapling lieferten Fehlalarme bei menschlichen Texten. Sapling schnitt außerdem lange Eingaben nach 2.000 Zeichen ab.
Wenn ich heute einen Text gegenprüfen müsste, würde ich mit Pangram anfangen. GPTZero wäre meine zweite Wahl für reine Texte. Bei Sapling wäre ich vorsichtiger, gerade wenn ein menschlicher Text plötzlich einen hohen KI-Wert bekommt.
1. Pangram
Bei Pangram habe ich sechs Sachtexte eingegeben. Je einen menschlichen, einen KI-generierten und einen gemischten Text auf Deutsch und Englisch. Die menschlichen Ausgangstexte behandelten Photosynthese und den Wasserkreislauf.
Alle sechs Berichte landeten in der passenden Kategorie. Bei den Mischtexten erkannte Pangram beide Quellen. Im englischen Bericht war die Markierung aber nicht exakt. Der erste KI-Satz mit 19 Wörtern erschien noch im menschlichen Abschnitt.
Meine sechs Pangram-Prüfungen vom 19. September 2026. Die Herkunft war vor der Eingabe bekannt.
Die Bedienung war angenehm. Die Berichte erschienen im Verlauf. Den letzten konnte ich später wieder öffnen. Ich konnte auch eine DOCX-Datei und ein textbasiertes PDF importieren und analysieren. Für die genaue Passage würde ich trotzdem immer selbst in den Text schauen.
Sechs Texte machen daraus noch keine allgemeine Trefferquote. Mehr zur Bedienung steht in meinem Pangram-Test.
Laut Preisseite gibt es 2.000 kostenlose Wörter pro Tag. Individual kostet bei monatlicher Zahlung 20 US-Dollar für 300.000 Wörter pro Monat. Ich nutzte für diesen Test einen bereits vorhandenen Lizenzzugang.
2. GPTZero
Bei GPTZero habe ich dieselben sechs vollständigen Sachtexte eingegeben wie bei Pangram. Die beiden menschlichen Texte erkannte es als menschlich. Auch bei den zwei reinen KI-Texten lag es richtig. Beim deutschen KI-Text zeigte es allerdings nur 66 % für die KI-Klasse an.
Die Mischtexte waren schwieriger. Beim deutschen Text zeigte GPTZero 51 % für „Mensch“ und 49 % für „Gemischt“. Beim englischen waren es 93 % für „Mensch“ und nur 6 % für „Gemischt“. Beide Texte enthielten tatsächlich menschliche und KI-generierte Passagen.
Dieselben sechs Sachtexte bei GPTZero am 24. September und Pangram am 19. September 2026. Die Prozentwerte sind GPTZeros Einschätzung der ganzen Textklasse, keine gemessenen KI-Anteile.
In meinem kostenlosen Konto hatte ich ein monatliches Guthaben von 10.000 Credits. Jeder dieser Scans kostete einen Credit pro Wort. Die kostenlose Hervorhebung einzelner Sätze war nach dem ersten Scan verbraucht, die Einordnung des gesamten Textes funktionierte weiter. Die aktuellen Tarife findest du auf der Preisseite von GPTZero.
Für einen reinen KI- oder Menschentext war GPTZero in dieser kleinen Runde nützlich. Wenn ein Text überarbeitet oder nur teilweise mit KI geschrieben wurde, würde ich mich nicht auf die Einordnung des ganzen Textes verlassen.
3. ZeroGPT
ZeroGPT ließ mich alle sechs vollständigen Texte ohne Anmeldung prüfen. Beim ersten Ergebnis musste ich zweimal hinschauen. Der menschlich verfasste deutsche Photosynthese-Text hieß dort „AI/GPT Generated“. Daneben standen 69,8 % KI/GPT.
Die beiden reinen KI-Texte bekamen 75,1 % und 99,2 %. Die Mischtexte lagen bei 90,2 % und 80,9 % KI/GPT, obwohl jeweils auch ein menschlicher Abschnitt darin steckte. Eine eigene Mischklasse zeigte mir ZeroGPT nicht. Besonders verwirrend war der menschliche englische Text. Er wurde insgesamt als eher menschlich bezeichnet, daneben standen aber 62 % KI/GPT.
Dieselben sechs Sachtexte bei ZeroGPT am 24. September und Pangram am 19. September 2026.
 gradually.ai
Der Fehlalarm beim deutschen Text reicht mir, um mit dem Ergebnis vorsichtig zu sein. Auch die widersprüchliche Anzeige beim englischen Text würde ich nicht ohne Prüfung an jemanden weitergeben.
4. QuillBot
QuillBot stufte beide menschlichen Texte mit 100 % als menschlich ein. Bei den reinen KI-Texten zeigte es 52 % und 76 % KI an. Der deutsche KI-Text lag damit nur knapp über der Hälfte.
Dann kamen die Mischtexte. In beiden steckte ein menschlicher und ein KI-generierter Abschnitt. QuillBot zeigte für beide trotzdem 0 % KI und 100 % menschlich an. Der zusätzliche Wert für „von Menschen geschrieben und umformuliert“ blieb ebenfalls bei 0 %. Gerade bei einem nur teilweise mit KI geschriebenen Text würde ich mich deshalb nicht auf diese Anzeige verlassen.
Dieselben sechs Sachtexte bei QuillBot am 24. und 25. September und Pangram am 19. September 2026.
gradually.aiNach fünf Prüfungen an diesem Tag meldete QuillBot, dass keine Scans mehr verfügbar seien. Den sechsten Text konnte ich am Folgetag prüfen. Die Produktseite nennt bis zu sechs Gratisprüfungen pro Tag und 1.200 Wörter pro Prüfung.
5. Detecting AI
Bei Detecting AI konnte ich meine sechs vollständigen Texte ohne Konto hochladen. Mein menschlicher deutscher Photosynthese-Text bekam 7 % KI-Wert und wurde als „wahrscheinlich menschlich verfasst“ eingeordnet. Der ebenfalls menschliche englische Text landete dagegen mit 42 % bei „gemischtes Ergebnis“. Zehn seiner 32 Sätze markierte das Tool sogar als wahrscheinlich KI. Für mich ist das ein deutlicher Fehlalarm.
Die zwei reinen KI-Texte bekamen 65 % und 67 % KI-Wert. Beide hießen trotzdem „gemischtes Ergebnis“. Noch auffälliger fand ich den deutschen Mischtext. Er bekam 7 % und die Einordnung „wahrscheinlich menschlich verfasst“. Nur der englische Mischtext wurde passend als gemischt eingeordnet. Bei den vier Texten, die vollständig von einem Menschen oder einer KI stammten, passte damit nur eine Gesamteinordnung.
Dieselben sechs Sachtexte bei Detecting AI am 25. September und Pangram am 19. September 2026.
gradually.aiNach diesen Ergebnissen würde ich weder die Gesamtklasse noch die farbigen Satzmarkierungen als Beweis für die Herkunft eines Textes verwenden. Die öffentliche Eingabeseite ließ mich ohne Anmeldung prüfen.
6. Sapling
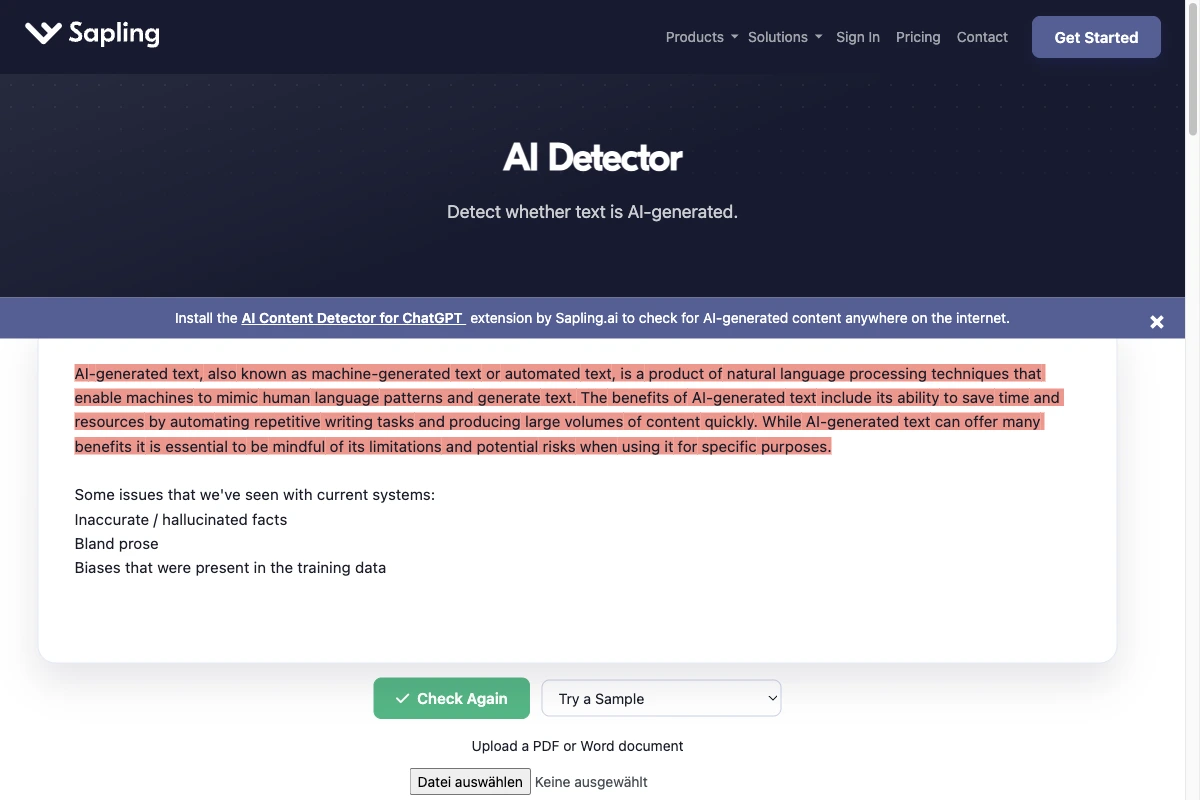
Bei Sapling blieb nach dem Einfügen meines Textes erst einmal der alte Wert des Beispieltexts stehen. Ich musste ausdrücklich auf „Check Again“ klicken. Bei meinen ersten längeren Eingaben kam die nächste Überraschung. Das Tool bewertete nur die ersten 2.000 Zeichen. Bei einem Mischtext mit angehängter KI-Passage kann dadurch gerade der interessante Teil fehlen.
Also habe ich sechs kürzere Texte verwendet, jeweils unter 1.600 Zeichen. Diesmal wurden alle vollständig verarbeitet. Zwei davon stammten aus älteren, menschlich verfassten Sachtexten. Sapling zeigte für sie trotzdem 97,7 % und 84,8 % KI an.
Meine sechs Sapling-Prüfungen vom 19. September 2026.
gradually.aiDie farbigen Satzmarkierungen wirken eindeutig. Nach diesen beiden Fehlalarmen würde ich daraus aber keinen Vorwurf gegen einen Autor ableiten. Auch 100,0 % in der Anzeige sind ein Modellwert, keine Gewissheit.
Die Preisseite nennt 2.000 Zeichen pro Gratisprüfung und 25 US-Dollar monatlich für Pro. Ob der längere Pro-Umfang in meinem Konto hätte greifen sollen, konnte ich nicht klären. Für meine Prüfung war die tatsächlich verarbeitete Textlänge entscheidend.
7. Gradually
Mein eigener Detektor erhielt dieselben sechs vollständigen Texte wie Pangram, GPTZero, QuillBot und ZeroGPT. Gut abgeschnitten hat er nicht. Beide menschlichen Sachtexte wurden als KI eingestuft. Bei einem weiteren kurzen deutschen Text übersah er umgekehrt die KI-Herkunft.
Auch die Bedienung hatte einen ernsten Fehler. Wenn ich den Text ersetzte oder das Feld leerte, blieb das alte Ergebnis stehen. Im Verlauf waren die Schaltflächen zum Wiederherstellen deaktiviert. So lässt sich ein Ergebnis leicht dem falschen Text zuordnen.
Die deutsche Version ist inzwischen entfernt. Ich würde sie nach diesen Erfahrungen nicht empfehlen.
8. Mein Urteil
Wenn du jetzt einen Detektor ausprobieren willst, nimm Pangram und beginne mit einem eigenen menschlichen Text. Die sechs Ergebnisse waren in meinem Versuch gut, die ungenaue Mischtext-Markierung zeigt aber, warum ich einzelne Passagen nicht blind übernehmen würde.
GPTZero und QuillBot trafen bei den vier reinen Texten ebenfalls die richtige Klasse. GPTZero ordnete beide Mischtexte überwiegend als menschlich ein, QuillBot sogar vollständig. ZeroGPT bezeichnete drei der vier reinen Texte passend, zeigte beim englischen menschlichen Text jedoch gleichzeitig 62 % KI/GPT an. Detecting AI lag bei drei der vier reinen Texte mit der Gesamtklasse daneben. Mein eigener Gradually-Detektor erkannte zwei der vier reinen Texte richtig.
gradually.aiSapling ist schnell ausprobiert, hat meine beiden menschlichen Sachtexte aber mit hohen KI-Scores versehen. Bei längeren Eingaben musst du zudem prüfen, welcher Teil wirklich analysiert wurde. Sapling bekam andere, kürzere Texte. Seine Zahlen lassen sich deshalb nicht direkt mit Pangram und GPTZero vergleichen.
Teste zuerst einen Text, den du selbst geschrieben hast und dessen Herkunft du kennst. Wenn ein Tool schon dabei danebenliegt, weißt du mehr als nach zehn Werbeversprechen.
9. So habe ich die KI-Detektoren getestet
Mich interessierten drei Fragen. Erkennt ein Detektor einen vollständig erzeugten KI-Text? Lässt er einen menschlichen Text in Ruhe? Und bemerkt er es, wenn ich an einen menschlichen Text einen KI-Abschnitt anhänge?
Dafür habe ich sechs Sachtexte verwendet, drei auf Deutsch und drei auf Englisch. Die deutschen Texte erklären Photosynthese, die englischen den Wasserkreislauf. Pro Sprache gibt es einen menschlichen Text, einen KI-Text und einen Mischtext.
- Menschliche Texte. Die beiden Auszüge stammen aus Wikipedia-Fassungen von 2021. Der deutsche Text umfasst 406 Wörter, der englische 578.
- KI-Texte. Diese ließ ich am 12. September 2026 mit der Modellkonfiguration
gpt-5.6-lunaerzeugen. Heraus kamen 506 deutsche und 496 englische Wörter. - Mischtexte. Ich habe jeweils den Anfang des menschlichen Textes mit einem KI-Abschnitt verbunden. Beim deutschen Text stammen 111 von 451 Wörtern aus der KI, beim englischen 121 von 472. Der KI-Anteil beträgt damit ungefähr ein Viertel.
Die Schreibaufträge waren bewusst unspektakulär. Auf Deutsch sollte die KI erklären, wie Photosynthese funktioniert, welche Stoffe und Energieformen daran beteiligt sind und warum sie für Ökosysteme wichtig ist. Auf Englisch ging es um Verdunstung, Kondensation, Niederschlag, Versickerung und Wasserspeicherung sowie die Rolle von Sonnenenergie und Schwerkraft.
Vorgegeben waren jeweils 450-550 Wörter für interessierte Erwachsene ohne Fachwissen, zusammenhängende Absätze und keine Überschriften oder Listen. Ich habe weder einen Humanizer verwendet noch die KI aufgefordert, Detektoren zu umgehen.
Zwischen dem 19. und 25. September 2026 habe ich dieselben sechs vollständigen Texte mit Pangram, GPTZero, ZeroGPT, QuillBot, Detecting AI und meinem eigenen Gradually-Detektor geprüft. Sapling bekam wegen der Zeichenbegrenzung sechs andere, kürzere Texte. Deshalb stehen seine Ergebnisse separat.
Im Vergleichsdiagramm zählen nur die vier eindeutig menschlichen oder vollständig KI-generierten Texte. Bei den Mischtexten schaue ich zusätzlich darauf, ob das Tool den angehängten KI-Abschnitt findet. Die Prozentanzeigen rechne ich nicht in eine gemeinsame Erkennungsrate um, denn die Anbieter meinen damit unterschiedliche Dinge. Sechs Texte zu zwei Themen zeigen konkrete Stärken und Fehler, aber keine allgemeine Trefferquote für alle Textarten und KI-Modelle.
10. Wie funktionieren KI-Detektoren?
Ein Detektor kann einem Text nicht ansehen, wer ihn geschrieben hat. Er sucht nach Mustern, die zu seinen Beispielen menschlicher oder KI-generierter Sprache passen. Dafür gibt es mehrere Ansätze.
Textmerkmale und Wahrscheinlichkeiten
Einfache Verfahren zählen etwa wiederkehrende Wörter und Wortfolgen oder vergleichen Satzlängen. Lesbarkeitswerte wie der Flesch-Index beschreiben dagegen, wie leicht sich ein Text lesen lässt. Das kann eine Eigenschaft des Textes sein, ist aber kein Herkunftsnachweis.
Andere Verfahren prüfen mit einem Sprachmodell, wie vorhersehbar die verwendeten Wörter sind. Der Begriff „Perplexität“ beschreibt dabei, wie gut ein Modell die Wortfolge vorhersagen kann. Als „Burstiness“ wird in diesem Zusammenhang oft die Schwankung solcher Muster oder der Satzstruktur bezeichnet. Gleichmäßige, vorhersehbare Sprache ist aber nicht automatisch KI-Sprache. Auch eine menschliche Gebrauchsanweisung kann sehr vorhersehbar sein.
Trainierte Klassifikatoren
Ein Klassifikator lernt anhand beschrifteter Beispiele, welche Muster eher in menschlichen und welche eher in erzeugten Texten auftreten. Das Modell muss dafür nicht dasselbe sein, das den Text geschrieben hat. Die Modellbeschreibung von Pangram 4 nennt beispielsweise eine Architektur mit mehreren spezialisierten Teilmodellen und die Klassen menschlich, KI-unterstützt und KI-generiert.
Entscheidend ist, wie gut die Trainingsbeispiele zum geprüften Text passen. Ein gutes Ergebnis bei englischen Schulaufsätzen lässt sich nicht einfach auf deutsche Produktbeschreibungen übertragen. Auch GPTZero weist auf Grenzen bei Textarten, Sprachen und kurzen Eingaben hin. Eine schön gestaltete Prozentanzeige ändert daran nichts.
11. Gibt es Wasserzeichen in KI-Texten?
Ja. Google nutzt SynthID für Texte in Gemini. Auch Anthropic versieht inzwischen die Antworten bestimmter Claude-Modelle mit Textwasserzeichen. Die pauschale Aussage „KI-Texte haben keine Wasserzeichen“ stimmt damit nicht mehr.
Allerdings markiert nicht jeder Anbieter jede Antwort auf dieselbe Weise. Ein Wasserzeichen in einem Bild sagt nichts darüber aus, ob auch der danebenstehende Chat-Text markiert wurde. Und selbst beim selben Anbieter kann sich der Status je nach Modell und Zugang unterscheiden.
Welche Anbieter markieren ihre KI-Texte?
Für einen kopierten Artikel oder eine Hausarbeit ist vor allem wichtig, ob die Markierung im Text selbst steckt. Die folgende Übersicht unterscheidet das von Bildwasserzeichen, Dateimetadaten und Hinweisen in einer Chat-Oberfläche.
Stand 30. September 2026. Bestätigt bedeutet hier vom Anbieter für die genannte Ausgabe und den genannten Zugang dokumentiert. Nicht bestätigt bedeutet nicht nachweislich wasserzeichenfrei.
„Nicht bestätigt“ bedeutet deshalb nicht „wasserzeichenfrei“. Eine fehlende öffentliche Erklärung ist etwas anderes als eine Zusicherung des Anbieters, dass seine Texte keinerlei Markierung enthalten.
Google Gemini und SynthID
Google nennt auf seiner SynthID-Seite die Gemini-App und die Webversion ausdrücklich als Einsatzorte für Textwasserzeichen. Das ist ein bereits eingesetztes Verfahren, nicht nur ein Forschungsvorschlag.
Weniger eindeutig ist die öffentliche Zuordnung zu einzelnen Modellen. Aus „Gemini nutzt SynthID“ würde ich nicht ableiten, dass jede Version von Gemini Pro, Flash oder Flash-Lite über jeden Zugang identisch markiert wird. Die genannte Seite liefert keine vollständige Tabelle für die Gemini API, Vertex AI und sämtliche Modellversionen.
Außerdem solltest du das Erzeugen und das Prüfen auseinanderhalten. Google beschreibt dort die öffentliche SynthID-Prüfung für Bilder, Videos und Audio. Daraus ergibt sich kein allgemein verfügbarer Textprüfer, in den du beliebige Absätze einfügst und der dir ein offizielles SynthID-Ergebnis liefert.
Auch Googles offene Modelle sind ein eigener Fall. Die SynthID-Text-Referenzimplementierung enthält Beispiele mit Gemma 1.0 in den Varianten 2B-IT und 7B-IT sowie mit GPT-2. Das zeigt, dass sich diese Modelle mit dem Verfahren betreiben lassen. Es bedeutet nicht, dass jeder lokal erzeugte Gemma- oder GPT-2-Text automatisch ein Google-Wasserzeichen trägt.
Anthropic Claude und die konkreten Modelle
Anthropics Modelltabelle unterscheidet folgende Claude-Versionen.
Textwasserzeichen in eigenen Produkten/API und bei AWS, Google Cloud und Microsoft Foundry. Stand 30. September 2026.
Die technische Beschreibung von Anthropic nennt eine Variante von SynthID Text. Sie markiert Text über die Erzeugung der Wortfolge. Die Dokumentation für Fable 5.1 bestätigt außerdem, dass weder versteckte Zeichen noch Informationen über dich oder deine Organisation hinzugefügt werden.
Ein Claude-Wasserzeichen würde ich auch nicht mit „Claude hat alles selbst geschrieben“ übersetzen. Anthropic beschreibt in seiner technischen Erklärung ausdrücklich auch bearbeitete Inhalte. Eine Übersetzung oder Überarbeitung kann einen Text mit einem Claude-Signal erzeugen, obwohl die Vorlage und ihre Gedanken von einem Menschen stammen.
Die offizielle Textprüfung ist laut Ankündigung zu Fable 5.1 und Mythos 5.1 zunächst ausgewählten Organisationen in einer geschlossenen Vorschau zugänglich. Ein privater Nutzer hat damit nicht automatisch einen frei verfügbaren Claude-Wasserzeichen-Scanner. Der Dateiprüfer für Content Credentials ist wiederum ein anderes Werkzeug.
ChatGPT und OpenAI
Bei OpenAI wäre die Aussage „ChatGPT-Texte sind jetzt mit SynthID versehen“ zu weitgehend. Die aktuelle Dokumentation zu Herkunftssignalen beschreibt SynthID für Bild- und Audioausgaben sowie Content Credentials für Bilder. Text wird dort als Ziel für den weiteren Ausbau genannt.
Das ist keine Bestätigung, dass die Textantworten aller GPT-Modelle in ChatGPT, Codex oder der API schon statistische Wasserzeichen enthalten. Eine konkrete GPT-Modellliste für einen solchen Einsatz liefert diese Quelle nicht. Umgekehrt würde ich daraus keine Garantie ableiten, dass jeder ChatGPT-Text ohne Wasserzeichen ist.
Besonders leicht lässt sich das bei einem Screenshot verwechseln. Ein Wasserzeichen im erzeugten Bild wäre eine Aussage über dieses Bild. Es wäre kein Nachweis dafür, dass auch eine separat kopierte Bildbeschreibung oder Chat-Antwort dasselbe Wasserzeichen enthält.
Meta, Grok, DeepSeek, Mistral und Qwen
Bei den weiteren Anbietern lohnt sich ein Blick darauf, was überhaupt markiert wird.
- Meta. Die Meta-AI-Seite zur Bilderzeugung beschreibt Content Seal als unsichtbares Bildwasserzeichen. Sie bestätigt damit keine vergleichbare Markierung in Meta-AI-Chat-Texten oder in sämtlichen Llama-Modellen.
- xAI. In der Grok-FAQ geht es bei den Wasserzeichen ausdrücklich um erzeugte Bilder und Videos. Für kopierte Grok-Textantworten ist das keine Zusage.
- DeepSeek. Abschnitt 5.3 der chinesischen Nutzungsbedingungen bestätigt Kennzeichnungen für KI-Inhalte innerhalb der Plattform. Die Passage erklärt aber weder ein SynthID-ähnliches Verfahren noch eine Zuordnung zu einzelnen Textmodellen. „Als KI gekennzeichnet“ und „statistisch im kopierten Text markiert“ sind deshalb nicht austauschbar.
- Mistral. Die Bedingungen für Partnerbereitstellungen erwähnen in Abschnitt 2.5 Wasserzeichen zur Rückverfolgung von Modellkopien bei einem besonderen Zugang zu den Gewichten. Hier ist das Modell selbst der Gegenstand. Daraus lässt sich kein allgemeines Textwasserzeichen für Le Chat ableiten.
- Qwen. Der Parameter für Wasserzeichen in der Qwen-Image-Dokumentation fügt eine sichtbare Kennzeichnung unten rechts im Bild hinzu. Das ist keine entsprechende Funktion für die Wortfolge eines Qwen-Chat-Texts.
Wie entsteht ein statistisches Textwasserzeichen?
Ein Sprachmodell setzt seine Antwort aus Tokens zusammen. Das sind Textbausteine, die auch kürzer als ein Wort sein können. Bei vielen Formulierungen stehen mehrere mögliche Fortsetzungen zur Auswahl. Ein Textwasserzeichen nutzt diesen Spielraum, um über viele Auswahlentscheidungen hinweg ein prüfbares Muster zu hinterlassen.
Du musst dafür weder ein merkwürdiges Wort noch eine bestimmte Zeichenfolge sehen. Bei SynthID wird die Auswahl während der Erzeugung beeinflusst. Die Entwicklerdokumentation von Google beschreibt dafür eine Konfiguration mit Schlüsseln und einem passenden Prüfverfahren. Deshalb kann ein einfacher Texteditor das Muster nicht wie ein zusätzliches Leerzeichen anzeigen.
Das erklärt auch, warum „unsichtbare Zeichen entfernen“ keine allgemeine Lösung ist. Dabei werden Zeichen gelöscht. Ein statistisches Wasserzeichen steckt dagegen in den Auswahlentscheidungen hinter den tatsächlich lesbaren Textbausteinen.
Ich würde vier Dinge getrennt betrachten.
- Statistisches Textwasserzeichen. Ein Muster in der erzeugten Wortfolge, das ein dafür geeignetes Verfahren prüft.
- Unsichtbare Unicode-Zeichen. Zusätzliche Zeichen im Text. Ihr Vorkommen allein ist kein Beweis für SynthID oder für eine bestimmte KI.
- Content Credentials. Signierte Herkunftsangaben zu einer Datei. Beim Kopieren ihres sichtbaren Inhalts entsteht daraus nicht automatisch ein Textwasserzeichen.
- Sichtbare KI-Kennzeichnung. Ein Hinweis in der Oberfläche oder auf einem Bild. Der Hinweis und der eigentliche Textinhalt sind unterschiedliche Dinge.
Können auch lokal laufende Modelle Wasserzeichen erzeugen?
Ja, wenn ihre Erzeugungssoftware dafür eingerichtet ist. Ein offenes Modell ist nicht allein wegen seiner herunterladbaren Gewichte automatisch wasserzeichenfrei. Entscheidend ist auch, was die Software beim Erzeugen der Antwort macht.
Ein konkretes Beispiel liefert vLLM. Die Entwickler zeigen, wie sich ein statistisches Gumbel-max-Wasserzeichen beim Betrieb von Mistral-7B-Instruct-v0.3 aktivieren lässt. Das ist eine Konfiguration des Betreibers, keine Aussage, dass Mistral dieses Wasserzeichen jedem Nutzer standardmäßig mitliefert.
Ebenso lässt sich SynthID laut Googles Entwickleranleitung ausdrücklich in die Texterzeugung einbauen. Bei einem fremden Dienst mit Gemma, Llama, Qwen oder einem anderen offenen Modell würde ich deshalb nicht nur nach dem Modellnamen fragen, sondern auch nach der konkreten Bereitstellung.
Wie zuverlässig ist die Prüfung eines Wasserzeichens?
Ein eingebettetes Muster ist kein unzerstörbarer Stempel. Google nennt in seiner Beschreibung der Grenzen von SynthID unter anderem kurze Antworten, stark vorgegebene Formulierungen, gründliches Umschreiben und Übersetzen als Schwierigkeiten.
Bei „Paris“ als Antwort auf eine Frage nach der französischen Hauptstadt gibt es kaum Spielraum für viele unterschiedliche Wortentscheidungen. Ein längerer frei formulierter Absatz bietet dafür mehr Möglichkeiten. Trotzdem gibt es keine universelle Mindestlänge, ab der jedes Wasserzeichen jedes Anbieters sicher erkannt wird.
Auch eine Übersetzung ist kein einfacher Ja-nein-Fall. Sie kann das Signal aus der ursprünglichen Wortfolge schwächen. Wird sie aber von einem Modell mit aktiver Textmarkierung neu erzeugt, kann die Übersetzung ein neues Wasserzeichen bekommen. Anthropic erläutert diesen Unterschied in seiner technischen Beschreibung.
Schließlich muss der Prüfer zum Verfahren passen. Dass eine Software irgendeinen KI-Text erkennt, heißt nicht, dass sie den richtigen Schlüssel und das richtige Prüfverfahren für ein bestimmtes Wasserzeichen besitzt. Der Name „KI-Detektor“ allein reicht dafür nicht.
Was bedeutet das für Pangram, GPTZero und deine Texte?
Ein allgemeiner KI-Score und eine Wasserzeichenprüfung beantworten unterschiedliche Fragen. Der KI-Detektor bewertet, wie ein Text auf sein Modell wirkt. Eine Wasserzeichenprüfung sucht nach einer bestimmten absichtlich eingebetteten Markierung.
Ein hoher Pangram- oder GPTZero-Wert ist deshalb kein Nachweis für ein gefundenes SynthID- oder Claude-Wasserzeichen. Wenn ein Tool einen solchen Fund behauptet, würde ich einen Bericht erwarten, der das konkrete Verfahren und das Ergebnis ausdrücklich benennt.
Für eine wichtige Entscheidung würde ich mir diese fünf Fragen stellen.
- Welcher Anbieter und welches konkrete Modell haben den Text erzeugt oder bearbeitet?
- Über welchen Zugang entstand die Antwort, etwa die Chat-App, eine API oder ein eigener Server?
- War Textmarkierung dort zum Zeitpunkt der Erzeugung bereits dokumentiert?
- Prüft das verwendete Werkzeug dieses Wasserzeichen oder liefert es nur einen allgemeinen KI-Wert?
- Liegt der ursprüngliche Text vor oder wurde er gekürzt, übersetzt, überarbeitet oder mit anderen Passagen vermischt?
Ein positives Signal kann auf eine Verarbeitung durch einen bestimmten Anbieter hinweisen. Es identifiziert aber nicht automatisch den Menschen hinter dem Text, den vollständigen Schreibprozess oder den Anteil eigener Gedanken. Ein negatives Ergebnis ist ebenfalls kein Beweis für menschliches Schreiben. Für einen Vorwurf oder eine Bewertung würde ich weiterhin Entwürfe, Quellen und den Versionsverlauf hinzuziehen.
12. Woran kannst du KI-Texte selbst erkennen?
Nicht an einem einzelnen Wort. „Delve“, „in der heutigen digitalen Welt“ oder fehlerfreie Grammatik reichen dafür genauso wenig wie gleich lange Absätze. Solche Auffälligkeiten können ein Anlass sein, genauer hinzusehen. Als Beweis taugen sie nicht.
Ich würde beim Lesen vor allem auf diese Punkte achten.
- Viele Worte, wenig zusätzliche Information. Wiederholt der Text denselben Gedanken in mehreren Absätzen, ohne ihn genauer zu erklären?
- Behauptungen ohne greifbare Belege. Werden angebliche Studien, Tests oder Erfahrungen genannt, die du nirgends nachvollziehen kannst?
- Widersprüche und falsche Quellen. Passen Zahlen, Namen und Beispiele zusammen? Existieren die verlinkten Quellen und sagen sie tatsächlich das Behauptete?
- Ungewöhnliche Stilwechsel. Ändern sich Wortwahl oder Kenntnisstand mitten im Text auffällig? Das kann auf mehrere Bearbeitungsschritte hinweisen, muss aber nichts mit KI zu tun haben.
Die Gegenprobe ist genauso wichtig. Menschen schreiben formelhaft und machen Sachfehler. KI kann lockere Sprache, ungewöhnliche Wortschöpfungen und absichtliche Tippfehler erzeugen. Die Faustregel „glatt geschrieben gleich KI“ führt deshalb schnell zu falschen Anschuldigungen.
Wenn es darauf ankommt, prüfe erst die konkreten Aussagen und Quellen. Bitte anschließend um Entwürfe, den Versionsverlauf oder eine Erklärung, wie der Text entstanden ist. Ein Detektor kann dir zusätzliche Hinweise geben. Er ersetzt dieses Gespräch nicht.
Häufige Fragen zu KI-Textdetektoren
Ja. Pangram bietet laut Preisseite bis zu 2.000 kostenlose Wörter pro Tag ohne hinterlegte Zahlungsmethode (Stand September 2026). Das reicht, um das Tool mit einigen eigenen Texten auszuprobieren. Auch GPTZero, QuillBot und die anderen hier gezeigten Detektoren konnte ich zumindest begrenzt kostenlos nutzen.
Schau nicht nur auf die Zahl der Gratisprüfungen. Wichtig ist auch, wie viel Text pro Prüfung verarbeitet wird und ob du die markierten Stellen sehen kannst. Bei Sapling wurde meine lange Eingabe nach 2.000 Zeichen abgeschnitten.
Nicht automatisch, dass 80 % der Wörter von einer KI stammen. Die Tools meinen mit ihren Prozentwerten unterschiedliche Dinge. Bei GPTZero beziehen sich die Klassenwahrscheinlichkeiten auf die Einordnung des gesamten Dokuments. Pangram beschreibt seine Textanteile dagegen als Anteil der Zeichen, die es der jeweiligen Kategorie zuordnet.
Auch diese Zuordnung kann falsch sein. Lies deshalb die Erklärung zur Anzeige und schau dir die markierten Stellen an. Ich würde weder Prozentwerte verschiedener Tools direkt gegeneinander aufrechnen noch daraus einen Durchschnitt bilden.
Nein. Eine KI-Prüfung schätzt ein, ob ein Text mit KI entstanden sein könnte. Eine Plagiatsprüfung sucht nach Übereinstimmungen mit vorhandenen Quellen. Auch QuillBot unterscheidet diese beiden Aufgaben.
Ein abgeschriebener menschlicher Text kann beim KI-Detektor unauffällig bleiben. Umgekehrt ist ein hoher KI-Wert kein Nachweis dafür, dass jemand eine bestimmte Quelle kopiert hat. Wenn du einen eingereichten Artikel beurteilst, solltest du Herkunft, Quellenangaben und sachliche Richtigkeit getrennt prüfen. Ein einzelner grüner Haken ersetzt das nicht.