
Claude Sonnet 4.5
Anthropic
Besonders an Claude Sonnet 4.5 war laut Anthropic die Computerbedienung. In der Veröffentlichung hob der Anbieter den OSWorld-Verified-Wert von 61,4 % hervor. Als Vorgänger von Claude Sonnet 4.6 zielte es auf komplexe Coding- und Agentenaufgaben.
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Zugang | APIQuelle |
| Kontextfenster | 200.000 TokenQuelle |
| Knowledge Cutoff | Januar 2025Quelle |
| Hinweise | Anthropic macht keine Angaben zur ParameteranzahlQuelle |
| API-Modellkennung | claude-sonnet-4-5-20250929Quelle |
| Status laut Quelle | active (legacy)Quelle |
| Veröffentlichung | 2025-09-29Quelle |
| Maximale Ausgabe | 64.000 TokenQuelle |
| Eingabe | Text, imagesQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | extended thinkingQuelle |
| Wissensstand | 2025-01 reliable / 2025-07 trainingQuelle |
| Werkzeugaufrufe | JaQuelle |
| Strukturierte Ausgabe | JaQuelle |
Seite 1 von 4
Overall
Berkeleys Function-Calling-Test verbindet einzelne und mehrstufige Tool-Aufrufe mit Websuche, Gedächtnis und Halluzinationsmessung. Der Gesamtscore ist ein ungewichteter Mix der Teilbereiche und hängt von nativem Function Calling oder Prompt-Workarounds ab.
höhere Werte sind besserStand 2. September 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 Bewertung - 1.103,18 Bewertung
Automatic validation
45 öffentliche Aufgaben zur Reproduktion von Forschungsergebnissen mit Code, Daten und Abhängigkeiten. Automatische und manuell geprüfte Werte sind verschiedene Metriken. Das Agentengerüst beeinflusst den Score stark.
höhere Werte sind besserStand 6. August 2026Skala: 0 % - 100 %
Accuracy
65 wissenschaftliche Programmierprobleme mit 338 Teilproblemen aus 16 Forschungsgebieten. Zero Shot, Tool Calling und HAL Generalist sind nicht direkt miteinander vergleichbar.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Attack success rate
365 schädliche Sequenzen prüfen Sicherheitsrisiken bei mehrstufiger Werkzeugnutzung. Eine niedrigere Angriffs-Erfolgsrate ist besser. Kompetenz und Sicherheit sind getrennte Größen.
Hinweis (Claude Sonnet 4.5): Tabelle 4 nennt für die Ablehnungsquote 15,43 %. Tabelle 9 desselben Papers nennt 15,34 %. Hier steht der Wert aus der direkten Einzel-gegen-Mehrfachdialog-Tabelle.
niedrigere Werte sind besserStand 9. August 2026Skala: 0 % - 100 %
Refusal rate
365 schädliche Sequenzen prüfen Sicherheitsrisiken bei mehrstufiger Werkzeugnutzung. Eine niedrigere Angriffs-Erfolgsrate ist besser. Kompetenz und Sicherheit sind getrennte Größen.
Hinweis (Claude Sonnet 4.5): Tabelle 4 nennt für die Ablehnungsquote 15,43 %. Tabelle 9 desselben Papers nennt 15,34 %. Hier steht der Wert aus der direkten Einzel-gegen-Mehrfachdialog-Tabelle.
höhere Werte sind besserStand 9. August 2026Skala: 0 % - 100 %
Overall
Mehrstufige Gespräche prüfen Erinnern, Anweisungsbindung, versionierte Überarbeitung und innere Konsistenz. Die Aufgaben wurden anhand gemeinsamer Fehler sechs älterer Spitzenmodelle ausgewählt und können diese Modelle benachteiligen.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
600 realistische Finanzfragen mit gewichteten Kriterien, davon 300 im schwierigen Teildatensatz. Ein o4-mini-Juror bewertet die Antworten. Fachliche Richtigkeit und praktische Verlässlichkeit bleiben deshalb getrennte Fragen.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
Overall
500 realistische Rechtsfragen mit gewichteten Kriterien aus unterschiedlichen Ländern und Rechtsgebieten. Der Benchmark misst professionelle Antwortqualität, ersetzt aber weder Rechtsprüfung noch menschliche Verantwortung.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
Overall
höhere Werte sind besserStand 29. September 2026Skala: 0 % - 100 %
Seite 1 von 4
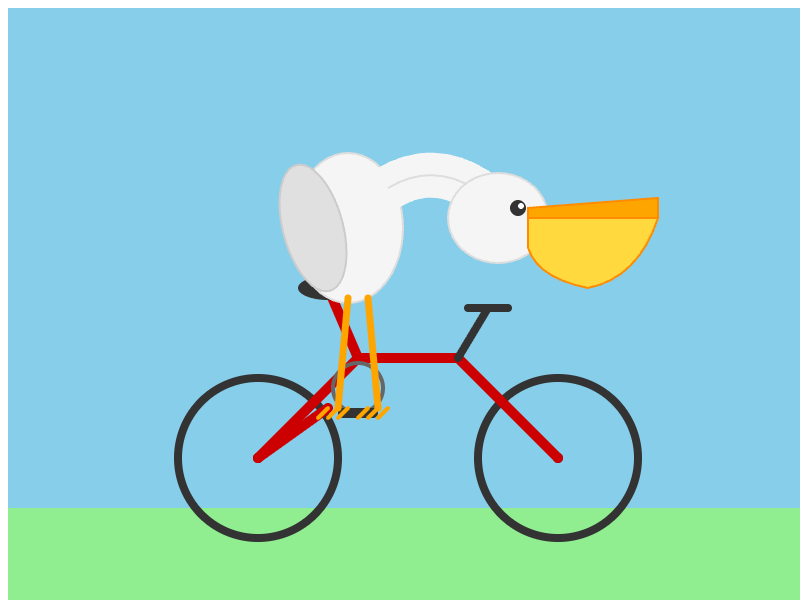
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Sonnet 4.5
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)49,8 / 100
| Art | Nachweis und Datenstand |
|---|---|
| Geschwindigkeit | Anthropic, Non-reasoning. Ausgabetempo nach dem ersten empfangenen Textabschnitt, nicht die gesamte Antwortzeit. Bei Artificial Analysis als veraltet eingeordnet. Artificial Analysis pflegt dort nur noch den Standard-Workload mit 10.000 Eingabe-Token. Abgerufen am 8. September 2026. |
| Preis | API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten. |
| Eingabe | Dokumentierte Modalitäten. Abgerufen am 8. September 2026. |
| Ausgabe | Dokumentierte Modalitäten. Abgerufen am 8. September 2026. |
| Recherchestand | Recherchestand 8. September 2026. 3 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell. |
| In den geprüften Quellen nicht gefunden | parameters-billions Originalwortlaut Anthropic does not publish parameter counts for this model. |
| In den geprüften Quellen nicht gefunden | active-parameters-billions Originalwortlaut Anthropic does not publish active parameter counts for this model. |
| Weitere Quelle | Modellmetadaten |
| Weitere Quelle | Kontextfenster-Daten |
| Weitere Quelle | Berkeley BFCL (abgerufen 2. September 2026) |
| Weitere Quelle | Princeton HAL (abgerufen 5. August 2026) |
| Weitere Quelle | Princeton HAL (abgerufen 6. August 2026) |
| Weitere Quelle | Princeton HAL (abgerufen 5. August 2026) |
| Weitere Quelle | Princeton HAL (abgerufen 6. August 2026) |
| Weitere Quelle | Princeton HAL (abgerufen 5. August 2026) |
| Weitere Quelle | MCP-Universe (abgerufen 9. August 2026) |
| Weitere Quelle | MT-AgentRisk (abgerufen 9. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Scale AI (abgerufen 26. August 2026) |
| Weitere Quelle | Vals AI (abgerufen 29. September 2026) |
| Weitere Quelle | Vals AI (abgerufen 29. September 2026) |
| Weitere Quelle | Vals AI (abgerufen 29. September 2026) |
| Weitere Quelle | Vals AI (abgerufen 29. September 2026) |
| Weitere Quelle | Vals AI (abgerufen 29. September 2026) |
| Weitere Quelle | Anthropic (abgerufen 8. September 2026) · Anthropic, Introducing Claude Sonnet 4.5 · Redaktionelle Beschreibung geprüft am 2. Oktober 2026 |
| Weitere Quelle | OpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Vercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Creative Commons Attribution 4.0 |
| Weitere Quelle | Anthropic "Introducing Claude Sonnet 4.6" announcement (2026-09-19) |