
GPT-4.1
OpenAI
GPT-4.1 erweiterte den API-Kontext gegenüber GPT-4o von 128.000 auf rund eine Million Token. OpenAI verbesserte zugleich Coding und Instruktionsbefolgung, etwa das Einhalten eines vorgegebenen Antwortformats und den Umgang mit Anweisungen, bestimmte Verhaltensweisen zu vermeiden.
Die Veröffentlichung konzentrierte sich auf die API. GPT-5 führte später eine allgemeine GPT-Stufe mit zusätzlichem Reasoning ein.
Der Index mittelt Rangperzentile aus 10 dokumentierten Vergleichskohorten.
Seite 1 von 12
3.513 öffentliche Beispiele prüfen Faktentreue bei Dokumenten, Bildern, internem Wissen und Websuche. Der Gesamtscore mittelt vier verschiedene Fähigkeiten. Die Teilwerte bleiben für Entscheidungen wichtiger.
| Teilaufgabe | GPT-4.1 (Dieses Modell) | Gemini 2.5 Pro | GPT-5 | Claude Opus 4.5 |
|---|---|---|---|---|
| Document grounding | 45,6 % | 74,2 % (bester Wert dieser Zeile) | 69,6 % | 62,1 % |
| Multimodal factuality | 40,1 % | 46,9 % (bester Wert dieser Zeile) | 44,1 % | 39,2 % |
| FACTS overall score | 50,5 % | 62,1 % (bester Wert dieser Zeile) | 61,8 % | 51,3 % |
| Parametric knowledge | 51,5 % | 63,2 % (bester Wert dieser Zeile) | 55,8 % | 30,6 % |
| Factuality with search | 64,6 % | 63,9 % | 77,7 % (bester Wert dieser Zeile) | 73,2 % |
höhere Werte sind besserStand 9. August 2026Quelle: Google DeepMindBalken je Zeile skaliert, nicht über Zeilen hinweg
Accuracy
33 automatisch prüfbare HAL-Aufgaben aus 214 realistischen, zeitaufwendigen Web-Rechercheaufgaben. Der veröffentlichte HAL-Ausschnitt ist kleiner als der vollständige Datensatz. Die Kosten berücksichtigen keine Cache-Vorteile.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
300 verifizierte Aufgaben auf 136 dynamischen Live-Websites. SeeAct und Browser-Use sind unterschiedliche Agentengerüste und bleiben deshalb getrennte Vergleichsgruppen.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
300 verifizierte Aufgaben auf 136 dynamischen Live-Websites. SeeAct und Browser-Use sind unterschiedliche Agentengerüste und bleiben deshalb getrennte Vergleichsgruppen.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
65 wissenschaftliche Programmierprobleme mit 338 Teilproblemen aus 16 Forschungsgebieten. Zero Shot, Tool Calling und HAL Generalist sind nicht direkt miteinander vergleichbar.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
65 wissenschaftliche Programmierprobleme mit 338 Teilproblemen aus 16 Forschungsgebieten. Zero Shot, Tool Calling und HAL Generalist sind nicht direkt miteinander vergleichbar.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
65 wissenschaftliche Programmierprobleme mit 338 Teilproblemen aus 16 Forschungsgebieten. Zero Shot, Tool Calling und HAL Generalist sind nicht direkt miteinander vergleichbar.
höhere Werte sind besserStand 5. August 2026Skala: 0 % - 100 %
Accuracy
102 von Fachleuten geprüfte Aufgaben für datengetriebene wissenschaftliche Arbeit. Agentengerüst, Werkzeuge und Codeausführung sind Teil des Ergebnisses. HAL nennt an verschiedenen Stellen 42 und 44 zugrunde liegende Publikationen.
höhere Werte sind besserStand 6. August 2026Skala: 0 % - 100 %
Seite 1 von 12
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-4.1
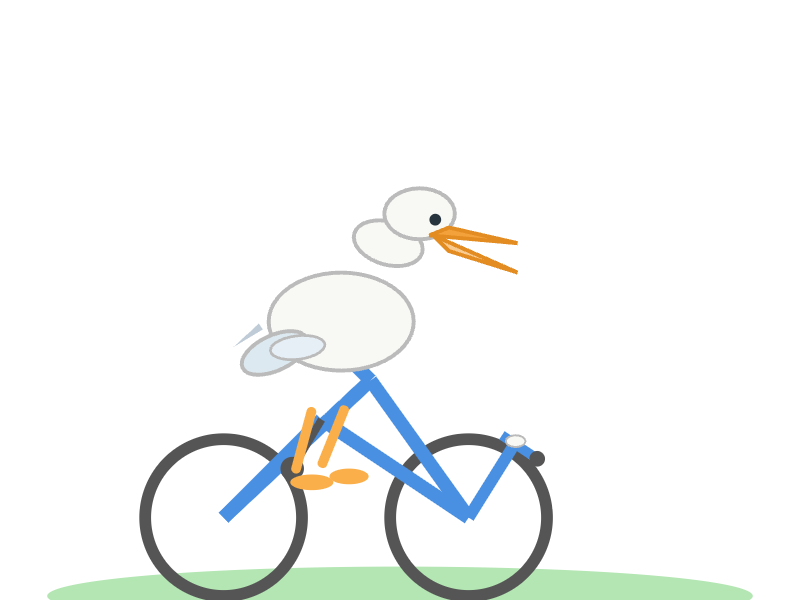
Reasoning (angefragt): nicht vorgegeben
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)37,4 / 100
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Zugang | APIQuelle |
| Kontextfenster | 1.047.576 TokenQuelle |
| Knowledge Cutoff | 1. Juni 2024Quelle |
| Hinweise | 1M Kontext, Parameterzahl nicht veröffentlichtQuelle |
| API-Modellkennung | gpt-4.1Quelle |
| Maximale Ausgabe | 32.768 TokenQuelle |
| Wissensstand | 2024-06-01Quelle |
| Eingabe | Text, BildQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | noneQuelle |
| API-Schnittstellen | Responses API, Chat Completions APIQuelle |
| Werkzeugaufrufe | JaQuelle |
| Strukturierte Ausgabe | JaQuelle |
| Veröffentlichung | 2025-04-14Quelle |