
o4-mini
In dieser Runde nicht verfügbar
OpenAI
Neu an o4-mini gegenüber o3-mini war das Reasoning mit Bildeingaben. In ChatGPT kann es Bilder während des Nachdenkens untersuchen und Werkzeuge wie Python einbeziehen. Der Hersteller nennt Mathematik, Coding und visuelle Aufgaben als Trainingsschwerpunkte.
OpenAI veröffentlichte o4-mini zusammen mit o3.
Der Auswahlindex des LLM-Vergleichshubs mittelt Rangperzentile aus 65 dokumentierten Vergleichskohorten. Die Benchmark-Meta-Scores stehen im Benchmarkbereich.
Benchmark-Metaanalyse
Diese Gradually-Indizes ordnen ausgewählte veröffentlichte Messwerte auf einer Skala von 0 bis 100 ein. Sie sind keine Prozentgenauigkeit und keine Garantie für ein Ergebnis in deiner Anwendung.
Abrufstände der verwendeten Quellen 2026-08-05 - 2026-10-19
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 2,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 1,8 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 2,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 1,5 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index unter 1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 1,3 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Index 1,1 / 100
vorläufig
Die veröffentlichten Konfigurationen unterscheiden sich innerhalb dieser Vergleichskohorte. Den Index daher als vorläufig lesen.
Methodenfassung: benchmark-meta-score-v3
Es zählen aktive Messwerte aus geprüften Primärquellen, wenn mindestens fünf Modelle im selben dokumentierten Vergleichsschnitt aus Datensatz, Harness, Agent, Werkzeugen und Versuchsanzahl verglichen werden. Pro Benchmark-Reihe und Auswerter zählt ein gemeinsamer Setup-Schnitt aus dem neuesten Abruf. Bei mehreren ausdrücklich erfassten Reasoning-Stufen derselben Quelle und Testreihe zählt die höchste dokumentierte Stufe (none bis max), nicht der höchste Ergebniswert. Die ausdrückliche Quellenangabe „Non-reasoning“ entspricht none. Unbekannte oder mehrdeutige Stufen führen zum Ausschluss des Modells aus der betreffenden Reihe. Innerhalb jeder Reihe werden Prozentwerte und Quoten logit-transformiert, andere Einheiten bleiben unverändert, und anschließend werden alle Werte standardisiert. Ein Ein-Faktor-Modell schätzt daraus eine gemeinsame Leistungsstärke je Modell und je Reihe, wie deutlich sie zwischen den Modellen trennt. Bereichswerte weichen davon nur so weit ab, wie die eigenen Ergebnisse im Bereich es belegen. Der Gesamtwert gewichtet die Kernbereiche mit 75 % und Finanzen, Recht und Gesundheit mit 25 %. Er erfordert mindestens acht Testreihen aus zwei Quellen und drei Bereichen. Die Skala von 0 bis 100 bezieht sich auf eine feste Referenzgruppe aus 29 Sprachmodellen, deren Durchschnitt bei 50 liegt.
Veröffentlichte modellabhängige Parameter können abweichen. Das ist kein kontrolliertes Experiment; solche Vergleiche werden als vorläufig gekennzeichnet.
Nicht gemessene Reihen werden nicht als Nullwert eingesetzt. Fehlen einem Modell eigene Werte in einem Kernbereich, steht dort seine Gesamtstärke, und der Hinweis „geschätzt, ohne eigene Werte in …“ nennt den Bereich. Weniger Testreihen führen zu einem größeren Standardfehler.
Das 95-%-Intervall folgt aus dem Standardfehler von 200 Neuberechnungen mit zufällig neu gezogenen Testfamilien. Es beschreibt, wie genau die erfassten Testreihen den Wert festlegen. Es ist keine Prognose für künftige Aufgaben oder spätere Neuberechnungen mit anderen Teilnehmern.
Die Quellenzahl ist keine Anzahl unabhängiger Experimente.
OECD-Handbuch zu zusammengesetzten IndikatorenAlle 25 Testfamilien und 12 von 26 Rohmesswerten sind hier aufgeführt. Die vollständige Rechnung für alle Modelle enthält der JSON-Export.
Gewicht der Familie im festen Testpanel (informativ): 2,14 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 1,53 % · Abdeckung dieser Testfamilie: 50 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,89 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,89 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,71 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,71 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 2,68 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 1,19 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 2,08 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,71 % · Abdeckung dieser Testfamilie: 100 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 0,71 % · Abdeckung dieser Testfamilie: 50 %
Veröffentlichte Konfigurationen unterscheiden sich in dieser Kohorte.
Gewicht der Familie im festen Testpanel (informativ): 1,19 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 0,71 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,08 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,14 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,78 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,78 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,78 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,14 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 3,57 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 1,19 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 0 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 1,19 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,68 % · Abdeckung dieser Testfamilie: 100 %
Gewicht der Familie im festen Testpanel (informativ): 2,68 % · Abdeckung dieser Testfamilie: 100 %
Jeder Auswerter misst andere Fähigkeiten unter eigenen Bedingungen. Testreihen, Gesamtindizes und ihre Komponenten bleiben getrennt. Die Ergebnisse darunter behalten ihre Skalen, Konfigurationen und Quelldaten.
| Auswerter | Testreihen | Gesamtindizes | Erfasste aktive Messwerte |
|---|---|---|---|
| Artificial Analysis | 3 | 0 | 10 |
| Vals AI | 15 | 0 | 69 |
| Princeton HAL | 6 | 0 | 18 |
| Scale AI Evals | 4 | 0 | 5 |
Die Abdeckung ist keine Qualitätsrangliste. Überschneidende Tests und mehrere Einstellungen zählen nicht als unabhängige Versuche. Herstellerangaben, historische und strittige Ergebnisse bleiben außerhalb dieser Übersicht und sind in den Detailbelegen gekennzeichnet.
Bei 6 Messwerten dieser Quellen ist die Zuordnung zu einer Testreihe noch offen. Sie erhöhen die Zahl der Testreihen nicht.
Seite 1 von 11
11.829 parallele Aufgaben je Sprache vergleichen Fachwissen und Reasoning in 29 Sprachen. Die Ergebnisse gelten für 5-Shot Chain of Thought und sind nicht mit MMLU-Pro gleichzusetzen.
| Teilaufgabe | o4-mini (Dieses Modell) | DeepSeek-R1 | GPT-4.1 | DeepSeek-V3 |
|---|---|---|---|---|
| Average across 29 languages | 69,3 % | 75,5 % (bester Wert dieser Zeile) | 72,7 % | 70,5 % |
| German | 73,5 % | 76,7 % (bester Wert dieser Zeile) | 76,4 % | 75,1 % |
höhere Werte sind besserStand 9. August 2026Quelle: MMLU-ProXBalken je Zeile skaliert, nicht über Zeilen hinweg
Overall
600 realistische Finanzfragen mit gewichteten Kriterien, davon 300 im schwierigen Teildatensatz. Ein o4-mini-Juror bewertet die Antworten. Fachliche Richtigkeit und praktische Verlässlichkeit bleiben deshalb getrennte Fragen.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
| Teilaufgabe | o4-mini (Dieses Modell) | o3 | o3-mini |
|---|---|---|---|
| Exact Pages | 63,99 % (bester Wert dieser Zeile) | 63,52 % | 56,41 % |
| Max Fitting Context | 55,01 % | 56,06 % (bester Wert dieser Zeile) | 33,57 % |
| Overall | 58,97 % | 59,71 % (bester Wert dieser Zeile) | 45,3 % |
| Shared Max Context | 57,93 % | 59,56 % (bester Wert dieser Zeile) | 45,92 % |
höhere Werte sind besserStand 15. Oktober 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg
Overall
500 realistische Rechtsfragen mit gewichteten Kriterien aus unterschiedlichen Ländern und Rechtsgebieten. Der Benchmark misst professionelle Antwortqualität, ersetzt aber weder Rechtsprüfung noch menschliche Verantwortung.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
Overall
1.204 visuelle Aufgaben verlangen Bildbearbeitung, Python, Websuche oder Rechnerzugriff mit höchstens 20 Werkzeugaufrufen. Der Score gehört zum kompletten multimodalen Werkzeugsystem. Das Modell allein lässt sich daraus nicht isolieren.
höhere Werte sind besserStand 26. August 2026Skala: 0 % - 100 %
| Teilaufgabe | o4-mini (Dieses Modell) | o3 | o3-mini | o1 |
|---|---|---|---|---|
| Few-Shot CoT | 73,74 % | 82,83 % (bester Wert dieser Zeile) | 74,24 % | 72,73 % |
| Zero-Shot CoT | 75,25 % | 85,35 % (bester Wert dieser Zeile) | 76,77 % | 73,74 % |
| Overall | 74,5 % | 84,09 % (bester Wert dieser Zeile) | 75,51 % | 73,23 % |
höhere Werte sind besserStand 15. Oktober 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg
Seite 1 von 11
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
o4-mini
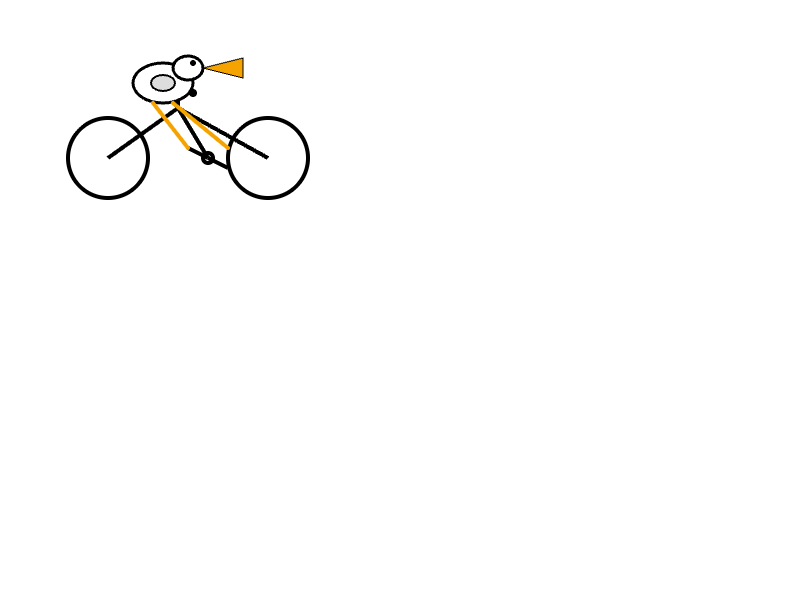
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)20,2 / 100
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Kontextfenster | 200.000 TokenQuelle |
| Knowledge Cutoff | 1. Juni 2024Quelle |
| Hinweise | Reasoning-Modell, Parameterzahl nicht veröffentlichtQuelle |
| API-Modellkennung | o4-miniQuelle |
| Maximale Ausgabe | 100.000 TokenQuelle |
| Wissensstand | 2024-06-01Quelle |
| Eingabe | Text, BildQuelle |
| Ausgabe | TextQuelle |
| Reasoning-Modus | low, medium, high, xhighQuelle |
| API-Schnittstellen | Responses API, Chat Completions APIQuelle |
| Strukturierte Ausgabe | JaQuelle |
| Veröffentlichung | 2025-04-16Quelle |