Zum Hauptinhalt springen

OpenAISprachmodellAktiv

GPT-6 Luna

GPT-6 Luna liegt im oberen Mittelfeld: Platz 35 von 92 im Gesamtindex. Per API ist es günstig.

LeistungPlatz 35 von 92

96,3Gesamtindexhöher ist besser

TempoPlatz 40 von 100

101Token pro Sekundehöher ist besser

PreisPlatz 8 von 95

Eingabe 0,10 $ · Ausgabe 0,50 $

0,20 $je 1 Mio. Tokenniedriger ist besser

KontextPlatz 2 von 102

1,05 Mio.Token auf einmal≈ 1.580 A4-Seiten

BeliebtheitPlatz 30 von 785

60von 100+8 zum Vormonat

beruht auf Suche, Nutzung und Aufmerksamkeit

Zusammenfassung

Es ist günstig: 0,20 $ je 1 Mio. Token (Eingabe und Ausgabe gemischt), ein typisches Modell kostet 1,55 $. Mit 101 Token pro Sekunde schreibt es schneller als ein typisches Modell (87).

Neu an GPT-6 Luna sind die besseren Ergebnisse bei mehrstufigen Arbeitsabläufen gegenüber GPT-5.6 Luna. In OpenAIs AutomationBench-Vergleich erreicht Luna bei hohem Reasoning-Aufwand 5,4 Prozentpunkte mehr bei 58 % geringeren Kosten pro Aufgabe. Der Test umfasst Abläufe über mehrere Unternehmensanwendungen.

Luna bleibt die kleinste und günstigste GPT-6-Stufe. GPT-6.1 Sol deckt die leistungsfähigere Sol-Linie ab.

Benchmarks von GPT-6 Luna

Gesamtindex (Gradually Meta-Score v4)

20 von 92 Modellen

4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

GPT-6 Luna nach Reasoning-Stufe

Punkte auf der Skala des Gesamtindex. Der Wert bei max ist der Gesamtindex von GPT-6 Luna, die übrigen Stufen leiten sich aus denselben Testreihen von Artificial Analysis ab. Fehlende Stufen werden nie geschätzt.

406080100120ohnelowmediumhighxhighmaxDeepSeek-V4.1-Flash · ohne: 84,7DeepSeek-V4.1-Flash · max: 99,7GLM-5.3 · low: 89,4GLM-5.3 · max: 100,7GPT-6 Luna · ohne: 59,4GPT-6 Luna · low: 65,2GPT-6 Luna · medium: 82,4GPT-6 Luna · high: 87,1GPT-6 Luna · xhigh: 90,6GPT-6 Luna · max: 96,3
GPT-6 Lunaohne 59,4 · low 65,2 · medium 82,4 · high 87,1 · xhigh 90,6 · max 96,3DeepSeek-V4.1-Flashohne 84,7 · max 99,7GLM-5.3low 89,4 · max 100,7Gefüllter Punkt: Stufe des Gesamtindex. Schattierung: 95-%-Bereich.

Quelle: Meta-Score v4; Stufen: Artificial Analysis

Tempo

20 von 100 Modellen

Mercury 2.5576Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.1 Flash-Lite336Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash-Lite299Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Nemotron 3.5 Lightning245Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Claude Haiku 5.5236Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
o3-mini230Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Ling 3.0 Flash199Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V3 0324195Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 mini191Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3 Flash Preview191Token/s · Konfiguration Non-reasoning · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.5 Flash184Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Gemini 3.6 Flash182Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Command A Plus177Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek-V4.1-Flash176Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
DeepSeek V4.1 Flash 1017172Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
Qwen 3.7 Max165Token/s · Konfiguration Reasoning enabled; effort unspecified · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-5.4 nano153Token/s · Konfiguration Xhigh effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 20B152Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT OSS 120B151Token/s · Konfiguration High effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06
GPT-6 Luna101Token/s · Konfiguration Max effort · AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt · Abgerufen 2026-11-06

Ausgabe-Token pro Sekunde, gemessen von Artificial Analysis

Leistung gegen Preis

lohnendster Bereich: stärker und günstiger als die Hälfte der gezeigten Modellebeste Leistung für den Preis

801001200,10 $0,50 $2 $10 $20 $Gemini 3.6 Flash: 96,7, 1,50 $Step 5 Preview: 97,3, 1,43 $MiMo V2.6 Flash: 98,3, 0,18 $Claude Opus 4.8: 99,0, 10 $DeepSeek-V4.1-Flash: 99,7, 0,26 $Qwen 3.8 Max 0902: 100,3, 2,48 $GLM-5.3: 100,7, 2,15 $GPT-5.6 Terra: 100,7, 4,50 $MiMo V2.6 Pro: 100,9, 0,54 $GPT-5.5: 100,9, 11,25 $Kimi K3: 101,2, 6 $Grok 4.6: 102,4, 3 $Grok 4.7: 103,4, 3 $Claude Haiku 5.5: 103,4, 0,20 $GPT-6.1 Terra: 105,3, 2 $Gemini 3.8 Flash: 106,5, 1,50 $DeepSeek V4.1 Flash 1017: 106,6, 0,26 $Muse Spark 1.3: 107,4, 2 $GPT-5.6 Sol: 108,7, 8 $GPT-6 Sol: 110,5, 4 $Claude Fable 5: 112,5, 20 $Kimi K3.1 Pro: 112,9, 4 $Muse Wonder: 113,4, 8 $Claude Opus 5: 117,2, 10 $GPT-6.1 Sol: 119,2, 4 $GPT-6 Astra: 121,3, 20 $Gemini 4 Argon: 122,3, 4 $Claude Sonnet 5.5: 122,8, 4 $Claude Fable 5.1: 123,8, 20 $Claude Opus 5.5: 126,1, 8 $GPT-6 Luna: 96,3, 0,20 $GPT-6 LunaClaude Opus 5.5Claude Fable 5.1Claude Sonnet 5.5Gemini 4 ArgonGPT-6 AstraGPT-6.1 SolClaude Opus 5Muse WonderKimi K3.1 ProClaude Fable 5GPT-6 SolGPT-5.6 SolMuse Spark 1.3DeepSeek V4.1 Flash 1017Gemini 3.8 FlashGPT-6.1 TerraClaude Haiku 5.5Grok 4.7Grok 4.6Kimi K3GPT-5.5MiMo V2.6 ProGPT-5.6 TerraGLM-5.3Qwen 3.8 Max 0902DeepSeek-V4.1-FlashClaude Opus 4.8MiMo V2.6 FlashStep 5 PreviewGemini 3.6 FlashPreis je 1 Mio. Token, Mischpreis (log. Achse)Gesamtindex

GPT-6 Luna nach Aufgabenbereich

Punkte, 100 = Durchschnitt der Referenzgruppe · höher ist besser

MathematikPlatz 9 von 47105,5
AgentenPlatz 32 von 9899,5
FinanzenPlatz 38 von 10498,3
SchlussfolgernPlatz 32 von 7297,8
ProgrammierenPlatz 35 von 10997,5
GesundheitPlatz 28 von 7295,2
AllgemeinPlatz 31 von 6594,4
MultimodalPlatz 20 von 4792,0
RechtPlatz 41 von 7290,7
WissenPlatz 19 von 3289,2

Text-Arena

Wie Menschen die Antworten im Blindvergleich bewerten, Elo-Punkte mit Stilkontrolle · höher ist besser

20 von 40 Modellen

Stand 30. Oktober 2026 · Quelle: LMArena

WebDev-Arena

Wie Menschen gebaute Webseiten und Web-Apps im Blindvergleich bewerten, Elo-Punkte · höher ist besser

20 von 43 Modellen

Stand 30. Oktober 2026 · Quelle: LMArena

Terminal-Bench 4.0

Anteil gelöster Aufgaben, die das Modell als Agent im Terminal erledigt, in Prozent · höher ist besser

20 von 38 Modellen

Stand 7. November 2026 · Quelle: Vals AI

Vibe Code Bench

Anteil der Apps, die das Modell aus einer Beschreibung korrekt baut, in Prozent · höher ist besser

20 von 51 Modellen

Stand 7. November 2026 · Quelle: Vals AI

Alle 1.076 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 89

Veröffentlichte Benchmarks

Allgemeine Aufgaben

BioMysteryBench

TeilaufgabeGPT-6 Luna (Dieses Modell)GPT-6.1 SolGPT-6 AstraGPT-6 SolGPT-5.6 SolGPT-5.6 Luna
Hard17,65 %39,22 % (bester Wert dieser Zeile)37,26 %35,29 %29,41 %27,45 %
Human-solvable71,69 %89,04 % (bester Wert dieser Zeile)89,04 % (bester Wert dieser Zeile)84,02 %80,82 %69,41 %
Overall61,48 %79,63 % (bester Wert dieser Zeile)79,26 %74,82 %71,11 %61,48 %

höhere Werte sind besserStand 7. November 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg

Methodik und Einordnung
Messgröße
accuracy

Finanzen

ClaimBench

TeilaufgabeGPT-6 Luna (Dieses Modell)GPT-6.1 Sol
Direct support100 % (bester Wert dieser Zeile)100 % (bester Wert dieser Zeile)
Missing evidence100 % (bester Wert dieser Zeile)100 % (bester Wert dieser Zeile)
Non-supporting citation100 % (bester Wert dieser Zeile)100 % (bester Wert dieser Zeile)
Numeric discrepancy100 % (bester Wert dieser Zeile)100 % (bester Wert dieser Zeile)
Overall99,18 %100 % (bester Wert dieser Zeile)
Subtle contradiction95,92 %100 % (bester Wert dieser Zeile)

höhere Werte sind besserStand 7. November 2026Quelle: Vals AIBalken je Zeile skaliert, nicht über Zeilen hinweg

Methodik und Einordnung
Messgröße
accuracy

Dokumentierte Messdetails

BioMysteryBench: Hard (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
17.647
Bewertung
17.647
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
human_difficult
Aufgabenbezeichnung
Hard
Richtung
Mehr ist besser
Vergleichskohorte
vals-biomysterybench:1:human_difficult
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 566.382. Standardfehler: 3.396. Kosten je Aufgabe in USD: 0.058804. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
BioMysteryBench: Human-solvable (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
71.689
Bewertung
71.689
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
human_solvable
Aufgabenbezeichnung
Human-solvable
Richtung
Mehr ist besser
Vergleichskohorte
vals-biomysterybench:1:human_solvable
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 513.89. Standardfehler: 2.416. Kosten je Aufgabe in USD: 0.051939. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
BioMysteryBench: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
61.481
Bewertung
61.481
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Vergleichskohorte
vals-biomysterybench:1:overall
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 523.805. Standardfehler: 2.593. Kosten je Aufgabe in USD: 0.053236. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Harness: Terminus 2. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Direct support (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
100
Bewertung
100
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
direct_support
Aufgabenbezeichnung
Direct support
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:direct_support
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 6.911378. Standardfehler: 0. Kosten je Aufgabe in USD: 0.00132. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Missing evidence (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
100
Bewertung
100
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
missing_evidence
Aufgabenbezeichnung
Missing evidence
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:missing_evidence
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 7.086452. Standardfehler: 0. Kosten je Aufgabe in USD: 0.001385. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Non-supporting citation (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
100
Bewertung
100
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
non_supporting_citation
Aufgabenbezeichnung
Non-supporting citation
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:non_supporting_citation
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 7.176003. Standardfehler: 0. Kosten je Aufgabe in USD: 0.001385. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Numeric discrepancy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
100
Bewertung
100
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
numeric_discrepancy
Aufgabenbezeichnung
Numeric discrepancy
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:numeric_discrepancy
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 7.372316. Standardfehler: 0. Kosten je Aufgabe in USD: 0.001414. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
99.184
Bewertung
99.184
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:overall
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 7.283. Standardfehler: 0.203. Kosten je Aufgabe in USD: 0.001372. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI
ClaimBench: Subtle contradiction (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
95.918
Bewertung
95.918
Messgröße
accuracy
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
subtle_contradiction
Aufgabenbezeichnung
Subtle contradiction
Richtung
Mehr ist besser
Vergleichskohorte
vals-claimbench:1:subtle_contradiction
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: openai/gpt-6-luna. Name des Quellmodells: GPT-6 Luna. Anbieter laut Quelle: OpenAI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-10-23. Reasoning-Stufe: max. Maximale Ausgabetoken: 128000. Latenz in Sekunden: 7.866128. Standardfehler: 1.001. Kosten je Aufgabe in USD: 0.001357. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-claimbench-2026-11-07-6aa89f0db85e. Prüfsumme der Quelldaten: 6aa89f0db85e2bdc765ff8d942de0d491dd37f2f2e635bb4a95b0f92746fc6d3. Parserversion: vals-astro-v4. Importiert am: 2026-11-07
Vergleichsmethodik
Reasoning-Stufe: max. Maximale Ausgabetoken: 128000
Quelle Vals AI

Seite 1 von 89

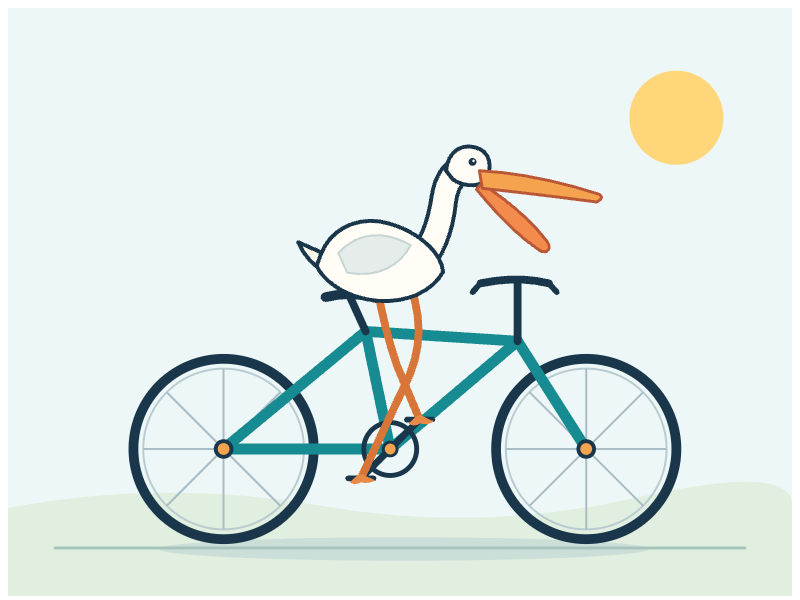
Selbst ansehen: ein Auftrag, ein Versuch

Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

GPT-6 Luna: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

01.10.2026 · 47 s · 0,0022 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-6-luna
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
4.493 Token
Kosten des Versuchs
0,0022 $
Antwortzeit
46,7 s
API-Modell laut Antwort
openai/gpt-6-luna
Festgelegter Endpunkt
OpenAI | openai/gpt-6-luna-20260922
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Ursprung der Aufgabe: Simon Willison
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

GPT-6 Luna

In dieser Runde nicht verfügbar

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 100 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

GPT-6 LunaGemini 3.8 Flash 61Muse Spark 1.3 61Claude Sonnet 5.5 60GPT-5.4 mini 59

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

GPT-6 Luna im Vergleich

Mit anderem Modell vergleichen

Die beliebtesten Vergleiche

  1. 1GPT-6 Luna vs. GPT-5.6 Terra
  2. 2Claude Haiku 5.5 vs. GPT-6 Luna
  3. 3GPT-6 Luna vs. Gemini 3.8 Flash
  4. 4GPT-6 Luna vs. DeepSeek-V4.1-Flash
  5. 5GPT-6 Luna vs. GPT-5.4 mini
  6. 6GPT-6 Astra vs. GPT-6 Luna
  7. 7GPT-6 Luna vs. GLM-5.3-Flash
  8. 8GPT-6.1 Sol vs. GPT-6 Luna
  9. 9GPT-6 Luna vs. DeepSeek-V4-Pro
Alle 56 Vergleiche zeigen
  1. 10Claude Sonnet 5 vs. GPT-6 Luna
  2. 11GPT-6 Luna vs. Gemini 3.5 Flash-Lite
  3. 12Claude Haiku 4.5 vs. GPT-6 Luna
  4. 13Claude Sonnet 4.6 vs. GPT-6 Luna
  5. 14GPT-6 Luna vs. GPT-5.4
  6. 15GPT-6 Luna vs. Gemini 3.1 Pro Preview
  7. 16Claude Sonnet 5.5 vs. GPT-6 Luna
  8. 17GPT-6 Luna vs. DeepSeek V4.1 Flash 1017
  9. 18Claude Opus 4.8 vs. GPT-6 Luna
  10. 19GPT-6 Luna vs. GPT-5.6 Sol
  11. 20GPT-6 Luna vs. Grok 4.7
  12. 21GPT-6 Luna vs. Gemini 3.6 Flash
  13. 22GPT-6 Sol vs. GPT-6 Luna
  14. 23Claude Opus 4.6 vs. GPT-6 Luna
  15. 24Claude Sonnet 4.5 vs. GPT-6 Luna
  16. 25GPT-6 Luna vs. Muse Spark 1.3
  17. 26GPT-6 Luna vs. DeepSeek-V4-Flash
  18. 27Claude Opus 5.5 vs. GPT-6 Luna
  19. 28GPT-6 Luna vs. Qwen 3.8 27B
  20. 29GPT-6 Luna vs. Qwen 3.8 Max 0902
  21. 30GPT-6 Luna vs. GLM-5.2
  22. 31GPT-6 Luna vs. GPT-5.5
  23. 32GPT-6 Luna vs. Gemini 3.7 Flash
  24. 33Claude Fable 5.1 vs. GPT-6 Luna
  25. 34GPT-6 Luna vs. GLM-5.3
  26. 35GPT-6 Luna vs. Grok 4.6
  27. 36Claude Opus 4.5 vs. GPT-6 Luna
  28. 37GPT-6 Luna vs. MiMo-V2.5
  29. 38Claude Fable 5 vs. GPT-6 Luna
  30. 39GPT-6 Luna vs. Mistral Large 4
  31. 40GPT-6 Luna vs. Gemini 3.5 Flash
  32. 41GPT-6.1 Terra vs. GPT-6 Luna
  33. 42GPT-6 Luna vs. Mistral Medium 3.5
  34. 43GPT-6 Luna vs. Grok 4.5
  35. 44Claude Opus 4.7 vs. GPT-6 Luna
  36. 45GPT-6 Luna vs. Gemini 4 Argon
  37. 46Claude Opus 5 vs. GPT-6 Luna
  38. 47GPT-6 Luna vs. Gemini 4 Carbon
  39. 48GPT-6 Luna vs. Muse Wonder
  40. 49GPT-6 Luna vs. Muse Wonder Full
  41. 50GPT-6 Luna vs. Grok 4.3
  42. 51GPT-6 Luna vs. Kimi K3.1 Pro
  43. 52GPT-6 Luna vs. Kimi K3
  44. 53GPT-6 Luna vs. Kimi K2.6
  45. 54GPT-6 Luna vs. GLM-5.1
  46. 55GPT-6 Luna vs. Mistral Large 3
  47. 56GPT-6 Luna vs. MiMo-V2.5-Pro

Alle technischen Daten

Architektur

Wissensstand
18. Mai 2026
Quelle: Wissensstand

Ein- und Ausgabe

Kontextfenster
1.050.000 Token
Quelle: Kontextfenster
Maximale Ausgabe
128.000 Token
Quelle: Maximale Ausgabe
Eingabe
Text, Bild
Quelle: Eingabe
Ausgabe
Text
Quelle: Ausgabe
Reasoning-Modus
none, low, medium, high, xhigh, max
Quelle: Reasoning-Modus
Werkzeugaufrufe
Ja
Quelle: Werkzeugaufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Proprietär
Quelle: Gewichte
Veröffentlichung
22.09.2026
Quelle: Veröffentlichung

API

API-Modellkennung
gpt-6-luna
Quelle: API-Modellkennung

Weitere Angaben

Hinweise
Veröffentlicht am 22. September 2026 als günstigste GPT-6-Stufe, laut OpenAI das effizienteste Modell für klar umrissene Aufgaben in hohem Volumen. 1,05 Millionen Token Kontext, 128.000 Token maximale Ausgabe und Knowledge Cutoff am 18. Mai 2026. API-Preis 0,10 $ / 0,50 $ pro Million Input- und Output-Token, halb so viel wie der Aktionspreis von GPT-5.6 Luna. Reasoning-Effort von none bis max, Standard ist medium. Offizielle API-ID: gpt-6-luna.
Quelle: Hinweise

Preise

Preisansicht wählen

9 Angebote, Preise in US-Dollar je 1 Mio. Token, Mischpreis aus 3 Teilen Eingabe und 1 Teil Ausgabe.

Angebote filtern
AnbieterEingabeAusgabeCache lesenCache schreibenMischpreis
OpenAIdirekt0,10 $0,50 $0,01 $0,125 $0,20 $
OpenAIüber 272.000 Kontext-Tokendirekt0,20 $0,75 $0,02 $0,25 $0,34 $
OpenAIFlex0,05 $0,25 $k. A.k. A.0,10 $
Amazon BedrockGlobal0,10 $0,50 $k. A.k. A.0,20 $
Azure0,10 $0,50 $k. A.k. A.0,20 $
OpenAI0,10 $0,50 $k. A.k. A.0,20 $
Amazon BedrockUs-east-10,11 $0,55 $k. A.k. A.0,22 $
AzureEU0,11 $0,55 $k. A.k. A.0,22 $
AzureUS0,11 $0,55 $k. A.k. A.0,22 $
OpenAIFast0,20 $1 $k. A.k. A.0,40 $

Cache-Preise stammen aus dem Direkttarif, OpenRouter meldet sie für die übrigen Anbieter nicht. Direktpreis laut Hersteller, geprüft am 22.09.2026. Anbieterpreise über OpenRouter, Stand 07.11.2026. Zum LLM-Preisindex

2 Preisänderungen seit Beginn der Messung.

EingabeAusgabe

0 $0,20 $0,40 $0,60 $0,80 $22.09.202607.11.2026
Täglich beobachteter Preis im LLM-Preisindex in US-Dollar je 1 Mio. Token. Der Index nutzt einen Marktpreis aus mehreren Quellen, der vom Direktpreis des Herstellers abweichen kann.

Bei OpenAI kostenlos nutzbar (ChatGPT Free), mehr ab 8 € im Monat (ChatGPT Go). Über andere Anbieter ab ≈ 1,07 € im Monat (Command Code Go, mit begrenztem Guthaben). 57 Tarife in Deutschland.

Tarife filtern
TarifPreis im MonatHinweis
ChatGPT FreeOpenAIkostenlosAbo des Herstellers
ChatGPT GoOpenAI8 €Abo des Herstellers
ChatGPT PlusOpenAI23 €Abo des Herstellers
ChatGPT Business Standard-PlatzOpenAI26 €Abo des Herstellers, mit begrenztem Guthaben, für Teams, je Nutzer
ChatGPT Pro $100OpenAI103 €Abo des Herstellers, mit begrenztem Guthaben
ChatGPT Business Premium-PlatzOpenAI130 €Abo des Herstellers, mit begrenztem Guthaben, für Teams, je Nutzer
ChatGPT EnterpriseOpenAIk. A.Abo des Herstellers, für Unternehmen, je Nutzer
ChatGPT Pro $500OpenAIk. A.Abo des Herstellers, mit begrenztem Guthaben
ElevenLabs Freekostenlosmit begrenztem Guthaben
Genspark Freekostenlosmit begrenztem Guthaben
JetBrains AI Freekostenlosmit begrenztem Guthaben
Lovable Freekostenlosmit begrenztem Guthaben
Zed Studentkostenlos
Command Code Go≈ 1,07 €mit begrenztem Guthaben
ElevenLabs Starter≈ 6,39 €mit begrenztem Guthaben
Command Code GOAT≈ 10,66 €mit begrenztem Guthaben
GitHub Copilot Pro≈ 10,66 €mit begrenztem Guthaben
Zed Pro≈ 10,66 €
JetBrains AI Pro11,90 €mit begrenztem Guthaben
GitHub Copilot Business≈ 20,25 €mit begrenztem Guthaben, für Teams, je Nutzer
Command Code Pro≈ 21,32 €mit begrenztem Guthaben
Replit Core≈ 21,32 €
ElevenLabs Creator≈ 23,45 €mit begrenztem Guthaben
JetBrains AI Pro23,80 €mit begrenztem Guthaben, für Teams, je Nutzer
Lovable Pro25 €mit begrenztem Guthaben
Genspark Plus≈ 26,64 €mit begrenztem Guthaben
Langdock Business Standard29,75 €für Teams, je Nutzer
JetBrains AI Ultimate35,70 €mit begrenztem Guthaben
GitHub Copilot Enterprise≈ 41,57 €mit begrenztem Guthaben, für Unternehmen, je Nutzer
GitHub Copilot Pro+≈ 41,57 €mit begrenztem Guthaben
Genspark for Business Team≈ 42,63 €mit begrenztem Guthaben, für Teams, je Nutzer
Lovable Business50 €mit begrenztem Guthaben, für Teams
Mindverse Studio Team58,31 €für Teams, je Nutzer
Higgsfield Plus70,21 €mit begrenztem Guthaben
Mindverse Studio Pro70,21 €je Nutzer
JetBrains AI Ultimate71,40 €mit begrenztem Guthaben, für Teams, je Nutzer
Higgsfield Team94,01 €mit begrenztem Guthaben, für Teams, je Nutzer
ElevenLabs Pro≈ 105,52 €mit begrenztem Guthaben
Command Code Max 10×≈ 106,58 €mit begrenztem Guthaben
GitHub Copilot Max≈ 106,58 €mit begrenztem Guthaben
Replit Pro≈ 106,58 €
Krea Max≈ 111,91 €mit begrenztem Guthaben
Langdock Business Max117,81 €für Teams, je Nutzer
Higgsfield Ultra153,51 €mit begrenztem Guthaben
Higgsfield Scale201,11 €mit begrenztem Guthaben, für Teams, je Nutzer
Command Code Max 20×≈ 213,17 €mit begrenztem Guthaben
Krea Business≈ 213,17 €mit begrenztem Guthaben, für Teams
Genspark Pro≈ 266,45 €mit begrenztem Guthaben
ElevenLabs Scale≈ 318,68 €mit begrenztem Guthaben, für Teams
ElevenLabs Business≈ 1.055,17 €mit begrenztem Guthaben, für Teams
ElevenLabs Enterprisek. A.für Unternehmen
Genspark for Business Enterprisek. A.mit begrenztem Guthaben, für Unternehmen, je Nutzer
Higgsfield Enterprisek. A.für Unternehmen
JetBrains AI Enterprisek. A.mit begrenztem Guthaben, für Unternehmen, je Nutzer
Krea Enterprisek. A.für Unternehmen
Lovable Enterprisek. A.für Unternehmen
Replit Enterprisek. A.für Unternehmen

Geschätzte Europreise zum EZB-Kurs vom 06.11.2026.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu GPT-6 Luna

Wie gut ist GPT-6 Luna in Benchmarks?

Ordentlich: Platz 35 von 92 im Gesamtindex.

Gesamtindex (Gradually Meta-Score v4) aus 48 Benchmark-Ergebnissen · Daten bis 07.11.2026

LeistungGesamtindex in Punkten, 100 = Durchschnitt der Referenzgruppe · höher ist besser
Step 5 Preview97,3
Gemini 3.5 Flash96,9
Gemini 3.6 Flash96,7
GPT-6 LunaPlatz 3596,3
Grok 4.594,6
GLM-5.3-Flash94,2
GPT-5.6 Luna93,9

Was ist der Gesamtindex (Gradually Meta-Score v4)?

Ein Punktwert, der viele unabhängige Benchmarks zu einer Zahl zusammenfasst. 100 Punkte sind der Durchschnitt einer festen Referenzgruppe, höher ist besser. GPT-6 Luna erreicht 96,3 Punkte, das ist Platz 35 von 92.

Eigene Auswertung von gradually.ai, Methode benchmark-meta-score-v4 · für GPT-6 Luna aus 48 Testreihen

Welche Daten
Nur aktuelle, geprüfte Ergebnisse unabhängiger Auswerter wie Artificial Analysis, Vals AI, LMArena, LiveBench und Epoch AI. Herstellerangaben sowie historische und strittige Werte zählen nicht.
Ein Wert je Test
Je Quelle und Testreihe zählt der neueste Abruf mit einem festen Aufbau. Testet eine Quelle mehrere Reasoning-Stufen, gilt die höchste dokumentierte. Eine Testreihe braucht mindestens 5 Modelle.
Vergleichbar machen
Prozentwerte werden so umgerechnet, dass Abstände nahe 0 und nahe 100 % fair zählen, danach wird jede Testreihe auf dieselbe Skala gebracht. So wiegt ein schwerer Test nicht mehr als ein leichter.
Gemeinsame Stärke
Ein statistisches Modell schätzt aus allen Testreihen zugleich eine gemeinsame Leistungsfähigkeit je Modell und je Bereich, wie stark ein Modell davon abweicht. Fehlende Tests werden nicht als null gezählt.
Gewichtung
Kernbereiche (Programmieren, Schlussfolgern, Mathematik, Wissen, Agenten, Allgemein und Multimodal) zählen zusammen 75 %, die Fachbereiche Finanzen, Recht und Gesundheit zusammen 25 %.
Die Punkteskala
Der Wert misst sich an einer festen Referenzgruppe aus 29 Modellen, ähnlich wie ein IQ-Wert: 100 Punkte sind ihr Durchschnitt, 15 Punkte eine Standardabweichung der Gruppe. Die Skala ist nach oben und unten offen und kein Prozentwert. Liegt ein Modell 15 Punkte vorn, schneidet es in etwa drei von vier Benchmark-Vergleichen besser ab. Neue Modelle verschieben die alten Werte nicht.
Platz nach Score
Der Platz folgt der Reihenfolge der Scores unter allen Modellen mit Platz, etwa „Platz 14 von 95“. Ob ein Vorsprung belastbar ist, prüft eine zweite Rechnung, die den Score 200-mal mit zufällig neu gezogenen Testfamilien wiederholt. Liegt ein Modell dabei nicht fast immer vorn, gelten zwei Modelle als gleichauf.
Mindestanforderung
Einen Wert gibt es erst ab 8 Testreihen aus 2 Quellen und 3 Bereichen, einen Platz nur bei ausreichender Genauigkeit. Fehlen Kernbereiche, steht der Hinweis „geschätzt“ dabei.
Was er nicht ist
Kein eigener Test von gradually.ai und kein Urteil über jede einzelne Aufgabe. Für eine bestimmte Aufgabe zählen die Bereichswerte und die einzelnen Benchmarks mehr.

Was kostet GPT-6 Luna?

Per API 0,10 $ je 1 Mio. Token Eingabe und 0,50 $ Ausgabe. Das ist günstig.

Preise vom 07.11.2026

Preis für die Ausgabe seit Beginn der MessungDollar je 1 Mio. Token · niedriger ist besser

22.09.202607.11.2026

Erster Preis am 22.09.2026: 0,50 $. Seit 24.09.2026: 0,50 $.

Bis wann reicht das Wissen von GPT-6 Luna?

Bis 18.05.2026, laut OpenAI. Das ist 4 Monate vor der Veröffentlichung.

Angabe von OpenAI

Wie groß ist das Kontextfenster von GPT-6 Luna?

1,05 Mio. Token. So viel Text liest GPT-6 Luna auf einmal, das sind rund 1.580 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GPT-6 LunaPlatz 2 von 1021,05 Mio.
GPT-5.6 Luna1,05 Mio.
Gemini 3.6 Flash1,05 Mio.
Gemini 3.5 Flash1,05 Mio.
GLM-5.3-Flash1 Mio.
Claude Opus 4.71 Mio.
Grok 4.5500 Tsd.

Wie schnell ist GPT-6 Luna?

101 Token pro Sekunde. Das ist schneller als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
Gemini 3.5 Flash184
Gemini 3.6 Flash182
Step 5 Preview132
GPT-6 LunaPlatz 40 von 100101
GPT-5.6 Luna94
Grok 4.571
GLM-5.3-Flash56

Kann ich GPT-6 Luna lokal nutzen?

Nein. OpenAI veröffentlicht die Gewichte nicht.

Angaben von OpenAI

Offene Gewichte
nein
Lizenz
k. A.
Parameter
k. A.
davon aktiv je Token
k. A.

Wo kann ich GPT-6 Luna nutzen?

Bei OpenAI kostenlos nutzbar. Zusammen mit anderen Anbietern sind es 57 Tarife in Deutschland, dazu kommt die API.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei OpenAI

8 Tarife, kostenlos (ChatGPT Free).

Über andere Anbieter

49 Tarife bei 12 Anbietern, ab ≈ 1,07 € im Monat (Command Code Go), mit begrenztem Guthaben.

Per API

0,10 $ Eingabe, 0,50 $ Ausgabe je 1 Mio. Token, unverändert seit 24.09.2026.

Ist GPT-6 Luna besser als GPT-5.6 Luna?

Im Gesamtindex nicht klar: Beide liegen gleichauf. Vorn liegt es in den Bereichen Mathematik und Wissen.

GPT-5.6 Luna als Vorgänger laut Introducing GPT-6 Sol and Luna, geprüft am 22.09.2026

LeistungGesamtindex, 100 Punkte = Durchschnitt · höher ist besser
96,3

GPT-6 Luna

Platz 35

93,9

GPT-5.6 Luna

Platz 38

TempoToken pro Sekunde · höher ist besser
101

GPT-6 Luna

eher schnell

94

GPT-5.6 Luna

eher schnell

PreisDollar je 1 Mio. Token, 3 Teile Eingabe und 1 Teil Ausgabe · niedriger ist besser
0,20 $

GPT-6 Luna

günstiger

0,45 $

GPT-5.6 Luna

2,3-mal so teuer

GPT-6 LunaGPT-5.6 Luna100 Punkte = Durchschnitt, höher ist besser
Programmierengleichauf13 und 11 TestsGPT-6 Luna: 97,5GPT-5.6 Luna: 96,0
Schlussfolgerngleichauf4 und 3 TestsGPT-6 Luna: 97,8GPT-5.6 Luna: 98,1
MathematikGPT-6 Luna vornGPT-6 Luna: 105,5GPT-5.6 Luna: 94,9
WissenGPT-6 Luna vornGPT-6 Luna: 89,2GPT-5.6 Luna: 83,9
Agentengleichauf4 und 6 TestsGPT-6 Luna: 99,5GPT-5.6 Luna: 97,6
AllgemeinGPT-6 Luna leicht vornnicht sicher · je 5 TestsGPT-6 Luna: 94,4GPT-5.6 Luna: 90,9
Finanzengleichauf5 und 6 TestsGPT-6 Luna: 98,3GPT-5.6 Luna: 98,2
RechtGPT-5.6 Luna leicht vornnicht sicher · 3 und 2 TestsGPT-6 Luna: 90,7GPT-5.6 Luna: 95,2
Gesundheitgleichaufje 2 TestsGPT-6 Luna: 95,2GPT-5.6 Luna: 92,4
Multimodalgleichauf2 und 3 TestsGPT-6 Luna: 92,0GPT-5.6 Luna: 92,2

Quellen und Datenstand

Alle 112 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis14086
Vals AI285291
LMArena4043
LiveBench7146
Epoch AI6013
ARC Prize0024
Scale AI Evals004

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten. 42 Messwerte sind noch keiner Testreihe zugeordnet.

ArtNachweis und Datenstand
Geschwindigkeit

OpenAI, Max effort. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

Preis

API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten.

Eingabe

Dokumentierte Modalitäten. Abgerufen am 22. September 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 22. September 2026.

RecherchestandRecherchestand 22. September 2026. 73 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
In den geprüften Quellen nicht gefunden

parameters-billions

Originalwortlaut

OpenAI does not publish parameter counts.

Ungeklärt

fresh-agent-arena-leaderboard

Hinweis

Die aktuelle Agent-Arena-Rangliste wurde im gerenderten Webreader geprüft, der Roh-Endpunkt lieferte jedoch HTTP 403. Ohne vollständig erfassten Quelltext wurden keine dynamischen Werte ergänzt.

Nicht veröffentlicht

confidence-interval-95

Originalwortlaut

No per-model 95% interval for this row is published in the paper’s Table 6; no interval has been inferred.

Nicht veröffentlicht

api-snapshot-id

Originalwortlaut

The paper gives the exact API alias and release date but not a pinned provider snapshot identifier.

Nicht veröffentlicht

serving-revision-and-test-denominators

Hinweis

ARC-Prize-Seiten nennen je Zeile weder N und KI noch eine unveränderliche Serving-Revision. Parallel nennt den Modellsnapshot nicht und variiert Reasoning- und Tokenlimits nach Anbieterempfehlung.

Ungeklärt

model snapshot, evaluation run date and per-model N

Originalwortlaut

The opened public benchmark article does not give GPT-6 Luna's pinned API snapshot, an evaluation run date for this score table, or a per-model sample count. None is inferred from dataset descriptions.

Nicht veröffentlicht

PRBench-Datensatz und modellspezifische Laufeinstellungen

Hinweis

Die aktuelle Ranglistenseite nennt für diese Zeile weder den vollständigen noch den schwierigen Datensatz und veröffentlicht keine modellspezifischen Laufeinstellungen oder Messdaten.

Weitere QuelleModellmetadaten (abgerufen 22. September 2026) · Introducing GPT-6 Sol and GPT-6 Luna · Redaktionelle Beschreibung geprüft am 4. Oktober 2026
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 2. November 2026; 7. November 2026)123456789
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 29. Oktober 2026; 2. November 2026; 7. November 2026)12
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026)12
Weitere QuelleArtificial Analysis (abgerufen 19. Oktober 2026; 2. November 2026)12
Weitere QuelleArtificial Analysis (abgerufen 5. November 2026; 7. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 7. November 2026)12
Weitere QuelleLMArena (abgerufen 30. Oktober 2026)1234
Weitere QuelleLMArena (abgerufen 28. Oktober 2026)12
Weitere QuelleLMArena (abgerufen 16. Oktober 2026)1234
Weitere QuelleVals AI (abgerufen 7. November 2026)1234567891011121314151617181920212223242526
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 7. November 2026)123
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 31. Oktober 2026; 7. November 2026)
Weitere QuelleVals AI (abgerufen 17. Oktober 2026; 7. November 2026)
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 30. Oktober 2026; 31. Oktober 2026)
Weitere QuelleVals AI (abgerufen 28. Oktober 2026; 7. November 2026)
Weitere QuelleLiveBench (abgerufen 16. Oktober 2026)1 (am 2. November 2026 nicht abrufbar) https://livebench.ai/table_2026_09_02.csv2 (am 2. November 2026 nicht abrufbar) https://livebench.ai/breakdown_2026_09_02.json
Weitere QuelleArena AI (abgerufen 17. Oktober 2026)
Weitere QuellePolicyBench (PolicyEngine), official frozen US paper and leaderboard (abgerufen 17. Oktober 2026)
Weitere QuelleARC Prize Verified Leaderboard (abgerufen 17. Oktober 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 17. Oktober 2026)
Weitere QuelleAndroid Developers, Android Bench leaderboard (abgerufen 17. Oktober 2026)
Weitere QuelleVetEval, GPT-6 Luna model page (abgerufen 17. Oktober 2026)
Weitere QuelleBANGLAPLAN research team, Constraint-Based Planning and Decision-Making in Bangla (abgerufen 17. Oktober 2026)
Weitere QuelleJoonlab GPT-6.1 Sol benchmark, pinned data commit (abgerufen 17. Oktober 2026)123
Weitere QuelleEpoch AI, AI systems are improving rapidly at Slay the Spire and its sequel (abgerufen 17. Oktober 2026)
Weitere QuelleVeriContest paper authors (abgerufen 18. Oktober 2026)
Weitere QuelleEpoch AI benchmark run dataset snapshot (abgerufen 19. Oktober 2026; 28. Oktober 2026)
Weitere QuelleAssemblyAI Voice Standard Bench (abgerufen 19. Oktober 2026)
Weitere QuelleRoboflow Vision Evals (abgerufen 19. Oktober 2026; 28. Oktober 2026)
Weitere QuelleAgent Arena (abgerufen 20. Oktober 2026)
Weitere QuelleVulcanBench Frontier v4, Code quality protocol v3.16 (abgerufen 20. Oktober 2026)
Weitere QuelleOpenAI (abgerufen 22. Oktober 2026)
Weitere Quelleuhyo, React Proficiency Benchmark (abgerufen 22. Oktober 2026)
Weitere QuelleOpenAI Deployment Safety Hub, GPT-6.1 Sol system-card addendum (abgerufen 23. Oktober 2026)
Weitere QuelleOpenAI, GPT-6.1 Sol System Card Addendum (abgerufen 23. Oktober 2026)
Weitere QuelleLiveBench (abgerufen 28. Oktober 2026)12
Weitere QuelleScale AI (abgerufen 28. Oktober 2026)
Weitere QuelleTerminal-Bench (abgerufen 28. Oktober 2026)
Weitere QuelleDuelLab GameBench 2 model results (abgerufen 28. Oktober 2026; 2. November 2026; 5. November 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 28. Oktober 2026; 5. November 2026)
Weitere QuelleTowards AI ToneBench (abgerufen 28. Oktober 2026; 30. Oktober 2026)123
Weitere QuelleGoogle on Kaggle (abgerufen 28. Oktober 2026)1234
Weitere QuelleMathBench.ai (abgerufen 28. Oktober 2026)
Weitere QuelleScale AI HSS (abgerufen 28. Oktober 2026)
Weitere QuelleScale AI DistressBench (abgerufen 28. Oktober 2026)
Weitere QuelleScale AI FORTRESS (abgerufen 28. Oktober 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 5. November 2026)
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0