GPT-6 Luna
Noch nicht getestet
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | GPT-6 Luna | GPT-5.6 Luna |
|---|---|---|
| Anbieter | OpenAI | OpenAI |
| Erschienen | 22. Sept. 2026 | 9. Juli 2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.050.000 Token | 1.050.000 Token |
| Wissensstand | 18. Mai 2026 | 16. Februar 2026 |
| Technische Quellen | Modell, Kontext | Modell, Kontext, Wissensstand |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | GPT-6 Luna | GPT-5.6 Luna |
|---|---|---|
| API-Eingabe | 0,1 $ ≤272K / 0,2 $ >272K | 0,2 $ ≤272K / 0,4 $ >272K |
| API-Ausgabe | 0,5 $ ≤272K / 0,75 $ >272K | 1,2 $ ≤272K / 1,8 $ >272K |
| Cache lesen | 0,01 $ ≤272K / 0,02 $ >272K | 0,02 $ ≤272K / 0,04 $ >272K |
| Cache schreiben (5 Min.) | 0,13 $ ≤272K / 0,25 $ >272K | 0,25 $ ≤272K / 0,5 $ >272K |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| GPT-6 Luna | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 0,1 $ | Günstigster erfasster Preis: 0,5 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 0,2 $ | 0,75 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 0,11 $ | 0,55 $ | Quelle23.09.2026 | |
| Azure | Über OpenRouterazure/eu | 0,11 $ | 0,55 $ | Quelle23.09.2026 | |
| Azure | Über OpenRouterazure/us | 0,11 $ | 0,55 $ | Quelle23.09.2026 | |
| OpenAI | Über OpenRouteropenai | Günstigster erfasster Preis: 0,1 $ | Günstigster erfasster Preis: 0,5 $ | Quelle23.09.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 0,2 $ | 1 $ | Quelle23.09.2026 | |
| GPT-5.6 Luna | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 0,2 $ | 1,2 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 0,4 $ | 1,8 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 0,22 $ | 1,32 $ | Quelle23.09.2026 | |
| Azure | Über OpenRouterazure | 0,2 $ | 1,2 $ | Quelle23.09.2026 | |
| Azure | Über OpenRouterazure/eu | 0,22 $ | 1,32 $ | Quelle23.09.2026 | |
| Azure | Über OpenRouterazure/us | 0,22 $ | 1,32 $ | Quelle23.09.2026 | |
| OpenAI | Über OpenRouteropenai | 0,2 $ | 1,2 $ | Quelle23.09.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 0,4 $ | 2,4 $ | Quelle23.09.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 0,1 $ | Günstigster erfasster Preis: 0,6 $ | Quelle23.09.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
18 passende Messreihen aus 18 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 10 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | GPT-6 Luna | GPT-5.6 Luna | Quelle |
|---|---|---|---|
BioMysteryBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: Terminus 2 | Gleichstand61,481 % | Gleichstand61,481 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Code MigrationOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 42,554 % | Gewinner44,55 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
EMBOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner68,515 % | 67,116 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Finance Agent (v2)OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser | 49,873 % | Gewinner55,044 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besser | Gewinner2,917 % | 1,25 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
IOIOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser | 55,556 % | Gewinner61,778 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Legal Research BenchOverall · All-passTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besser | 30,288 % | Gewinner36,538 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
MedCodeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner44,685 % | 42,391 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
MedScribeOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 83,71 % | Gewinner84,391 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
MysteryMechanismOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner19,369 % | 14,414 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
ProgramBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner0,5 % | 0 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
ProofBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner64 % | 60 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Public Benefits Bench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser | 57,645 % | Gewinner61,164 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
SAGEOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | Gewinner48,091 % | 44,22 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Tax Agent BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser | 58,864 % | Gewinner60,815 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Terminal-Bench 2.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besser | 73,034 % | Gewinner79,026 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Vals IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: weighted index scoreBewertung: Mehr ist besser | 58,45 % | Gewinner59,881 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Vibe Code Bench v1.1OverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands | Gewinner81,649 % | 77,055 % | Vals AIQuellendetailsDatenstand: 22.09.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-6 Luna
Noch nicht getestet
GPT-5.6 Luna
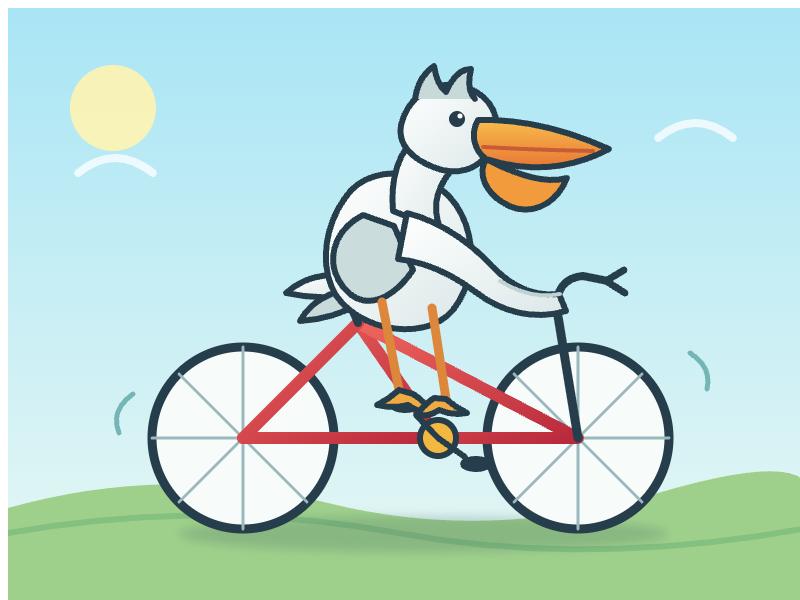
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche GPT-6 Luna und GPT-5.6 Luna mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.