Zum Hauptinhalt springen

AnthropicOpenAILLM-Duell

Claude Opus 5.5vs.GPT-5.6 Luna

Wer ist besser?

Claude Opus 5.5 schneidet besser als GPT-5.6 Luna ab, aber kostet 20-mal (Eingabe) und 16,7-mal (Ausgabe) so viel.

Opus 5.5 vorn
LeistungGesamtindex, 100 Punkte = Durchschnitt
126,1

Claude Opus 5.5

Platz 1

93,9

GPT-5.6 Luna

Platz 38

etwa gleich schnell
TempoToken pro Sekunde
106

Claude Opus 5.5

94

GPT-5.6 Luna

GPT-5.6 Luna günstiger
Preis$ je 1 Mio. Token
8 $

Claude Opus 5.5

0,45 $

GPT-5.6 Luna

Opus 5.5 beliebter
Beliebtheit0 bis 100
68

Claude Opus 5.5

Platz 8 von 785

45

GPT-5.6 Luna

Platz 176 von 785

Ab 272.000 Token im Kontext kostet GPT-5.6 Luna mehr: 0,40 $ Eingabe und 1,80 $ Ausgabe je 1 Mio. Token.

Nimm Claude Opus 5.5 für

WissenMathematikAllgemeinProgrammierenProduktivitätMultimodalGesundheitRechtSchlussfolgernFinanzenAgenten

Nimm GPT-5.6 Luna für

Kein klarer Vorteil

Wo liegt der Unterschied?

Stärken im Überblick

Opus 5.5GPT-5.6 LunaMedian aller Modelle mit Platz

9511513575ProgrammierenOpus 5.5SchlussfolgernOpus 5.5MathematikOpus 5.5WissenOpus 5.5AgentenOpus 5.5AllgemeinOpus 5.5MultimodalOpus 5.5FinanzenOpus 5.5RechtOpus 5.5GesundheitOpus 5.5
ProgrammierenOpus 5.5 vorn
Opus 5.5129,9Platz 1
GPT-5.6 Luna96,0Platz 41
Median aller Modelle mit Platz84,1

95-%-Bereich: Opus 5.5 121,2 bis 138,7, GPT-5.6 Luna 86,4 bis 105,6.

BereichOpus 5.5GPT-5.6 Luna

Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 75 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100.

Opus 5.5 liegt in 10 von 10 Bereichen vorn, GPT-5.6 Luna in keinem.

Opus 5.5 vorn: 10

Bereiche im Gesamtindex
WissenOpus 5.5 +47131,4 zu 83,9
MathematikOpus 5.5 +37131,8 zu 94,9
AllgemeinOpus 5.5 +34125,1 zu 90,9
ProgrammierenOpus 5.5 +34129,9 zu 96,0
MultimodalOpus 5.5 +31123,1 zu 92,2
SchlussfolgernOpus 5.5 +24122,5 zu 98,1
AgentenOpus 5.5 +20117,2 zu 97,6
Fachgebiete
GesundheitOpus 5.5 +30122,1 zu 92,4
RechtOpus 5.5 +26121,5 zu 95,2
FinanzenOpus 5.5 +23121,4 zu 98,2

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

4 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
ProduktivitätOpus 5.5 +32125,0 zu 92,5
Cybersicherheitzu wenig Daten120,5 zu 98,0
Suchenur Opus 5.5 mit Wertung
Bildungnur Opus 5.5 mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

Claude Opus 5.5 gegen GPT-5.6 Luna auf gleicher Stufe

Beide Modelle auf denselben Stufen gemessen. So zeigt sich, ob ein Vorsprung vom Modell kommt oder nur von mehr Rechenaufwand.

maxOpus 5.5 vorn
Opus 5.5 126,1 gegen GPT-5.6 Luna 93,9 · Abstand 33,3 · Testreihen 12
Gesamtindex (max gegen max)Opus 5.5 vorn
Opus 5.5 126,1 gegen GPT-5.6 Luna 93,9

Abstand und Urteil vergleichen nur die Testreihen von Artificial Analysis, in denen beide Modelle auf dieser Stufe gemessen sind. Gleichauf unter 3 Punkten, vorn erst bei einem Abstand über zwei Standardfehlern. Die Einzelwerte stützen sich auf alle Testreihen des jeweiligen Modells, deshalb weicht ihre Differenz vom Abstand ab.

Welches Modell für welche Aufgabe?

Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.

Code schreiben und Fehler findenOpus 5.5Programmieren 129,9 zu 96,0
Mathe und DatenanalyseOpus 5.5Mathematik 131,8 zu 94,9, Schlussfolgern 122,5 zu 98,1
Fakten und RechercheOpus 5.5Wissen 131,4 zu 83,9, Suche ohne Wertung für GPT-5.6 Luna
Agenten und WorkflowsOpus 5.5Agenten 117,2 zu 97,6
Schnelle Antworten im Chatetwa gleich106 zu 94 Token pro Sekunde
SicherheitsanalysenoffenCybersicherheit 120,5 zu 98,0 (zu wenig Daten)
Viele Anfragen, kleines BudgetGPT-5.6 Luna8 $ zu 0,45 $ je 1 Mio. Token
Finanz-, Rechts- und MedizintexteOpus 5.5Finanzen 121,4 zu 98,2, Recht 121,5 zu 95,2, Gesundheit 122,1 zu 92,4
Bilder, Screenshots und PDFsOpus 5.5Multimodal 123,1 zu 92,2

Selbst ansehen: gleicher Auftrag, ein Versuch

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

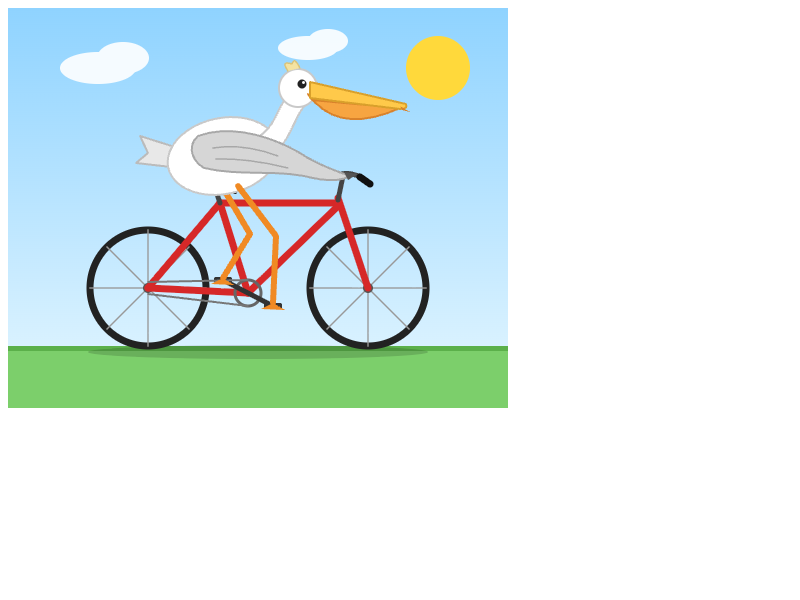
Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

Ursprung der Aufgabe: Simon Willison

Claude Opus 5.5

Claude Opus 5.5: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

01.10.2026 · 33 s · 0,07 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-opus-5.5
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
3.536 Token
Kosten des Versuchs
0,0708 $
Antwortzeit
33,2 s
API-Modell laut Antwort
anthropic/claude-opus-5.5
Festgelegter Endpunkt
Anthropic | anthropic/claude-opus-5.5-20260921
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

GPT-5.6 Luna
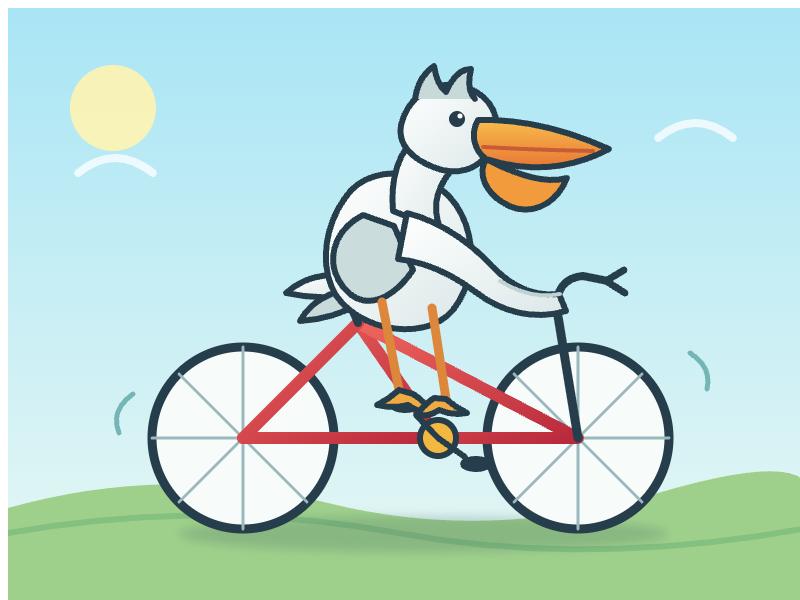
GPT-5.6 Luna: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

07.09.2026 · 50 s · 0,0038 $

Testdetails
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.6-luna
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
3.164 Token
Kosten des Versuchs
0,0038 $
Antwortzeit
49,9 s
API-Modell laut Antwort
openai/gpt-5.6-luna
Festgelegter Endpunkt
OpenAI | openai/gpt-5.6-luna-20260709
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

Claude Opus 5.5

In dieser Runde nicht verfügbar

GPT-5.6 Luna

In dieser Runde nicht verfügbar

Claude Opus 5.5 und GPT-5.6 Luna im Gesamtindex

Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.

Gesamtindex (Gradually Meta-Score v4)

20 von 92 Modellen

4 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

Claude Opus 5.5max126,1
Gemini 4 Carbonhigh125,8
Claude Fable 5.1max123,8
Claude Sonnet 5.5max122,8
Gemini 4 Argonhigh122,3
GPT-6 Astramax121,3
GPT-6.1 Solmax119,2
Muse Wonder Fullmax118,3
Claude Opus 5max117,2
Muse Wondermax113,4
Kimi K3.1 Promax112,9
Claude Fable 5max112,5
GPT-6 Solmax110,5
GPT-5.6 Solmax108,7
Muse Spark 1.3max107,4
Gemini 3.7 Flashhigh107,1
DeepSeek V4.1 Flash 1017max106,6
Gemini 3.8 Flashhigh106,5
GPT-6.1 Terramax105,3
GPT-5.6 Lunamax93,9

Beliebtheit im Vergleich

Wie oft die Modelle gesucht, genutzt und erwähnt werden, auf einer Skala von 0 bis 100.

Claude Opus 5.5 ist beliebter als GPT-5.6 Luna: 68 zu 45 von 100.

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

Claude Opus 5.5GPT-5.6 Luna

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlClaude Opus 5.5GPT-5.6 Luna
Leistung
GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser126,193,9
PlatzPlatz 1 von 92Platz 38 von 92
Preis je 1 Mio. Token
Eingabewas du schickst4 $0,20 $über 272.000 Token: 0,40 $
Ausgabewas das Modell schreibt20 $1,20 $über 272.000 Token: 1,80 $
Kosten je Aufgabe (eigene Tests)Durchschnitt aus 3 Aufgaben des ursprünglichen Testprotokolls, die beide Modelle bestanden haben (ohne SVG-Kurztest)0,11 $0,008 $
Tempo
Token pro Sekunde10694
Beliebtheit
BeliebtheitSuche, Nutzung und Erwähnungen, 0 bis 10068Platz 8 von 78545Platz 176 von 785
Technik
Kontextfensterwie viel Text das Modell auf einmal liest1 Mio. Token≈ 1.500 A4-Seiten1,05 Mio. Token≈ 1.580 A4-Seiten
WissensstandJuni 202616.02.2026
Veröffentlicht22.09.202609.07.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinnein

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gibt es eine bessere Wahl?

Nachfolger von GPT-5.6 LunaGPT-6 Luna

Gesamtindex 96,3, Platz 350,10 $ Eingabe und 0,50 $ Ausgabe je 1 Mio. Token

Opus 5.5 vs. GPT-6 Luna
Günstiger als GPT-5.6 LunaDeepSeek V4.1 Flash 1017

Gesamtindex 106,6, Platz 170,15 $ Eingabe und 0,60 $ Ausgabe je 1 Mio. Token

Opus 5.5 vs. DeepSeek V4.1 Flash 1017

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: Claude Opus 5.5B: GPT-5.6 Luna

BioMysteryBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 79,3 %GPT-5.6 Luna: 61,5 %Vals AIStand 05.11.2026
Code MigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 66,6 %GPT-5.6 Luna: 44,6 %Vals AIStand 29.10.2026
CyberBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 55,4 %GPT-5.6 Luna: 73,6 %Vals AIStand 05.11.2026
EMBOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 75,9 %GPT-5.6 Luna: 67,1 %Vals AIStand 20.10.2026
Finance Agent (v2)Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 58,6 %GPT-5.6 Luna: 55,0 %Vals AIStand 29.10.2026
IOIOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 95,1 %GPT-5.6 Luna: 61,8 %Vals AIStand 29.10.2026
Legal Research BenchOverall · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 50,5 %GPT-5.6 Luna: 36,5 %Vals AIStand 05.11.2026
LMArena Text, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.509GPT-5.6 Luna: 1.453LMArenaStand 28.10.2026
LMArena Vision, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.293GPT-5.6 Luna: 1.257LMArenaStand 19.10.2026
MedCodeOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 49,8 %GPT-5.6 Luna: 42,4 %Vals AIStand 29.10.2026
54 weitere Benchmarks anzeigen
MedScribeOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 91,4 %GPT-5.6 Luna: 84,4 %Vals AIStand 29.10.2026
MysteryMechanismOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 49,6 %GPT-5.6 Luna: 14,4 %Vals AIStand 29.10.2026
ProgramBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 18,5 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
ProofBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 100 %GPT-5.6 Luna: 60 %Vals AIStand 29.10.2026
Public Benefits Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 70,6 %GPT-5.6 Luna: 61,2 %Vals AIStand 12.10.2026
SRE BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 33,6 %GPT-5.6 Luna: 1,5 %Vals AIStand 05.11.2026
Tax Agent BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 45,6 %GPT-5.6 Luna: 24,8 %Vals AIStand 05.11.2026
Terminal-Bench 4.0Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 65,2 %GPT-5.6 Luna: 11,6 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 47,1 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
Vals Science IndexOverall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 58,7 %GPT-5.6 Luna: 25,3 %Vals AIStand 25.10.2026
Vibe Code Bench 1-100Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 30,4 %GPT-5.6 Luna: 22,6 %Vals AIStand 29.10.2026
Vibe Code Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 90,3 %GPT-5.6 Luna: 77,1 %Vals AIStand 05.11.2026
BioMysteryBenchHard · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 47,1 %GPT-5.6 Luna: 27,5 %Vals AIStand 05.11.2026
Code MigrationCLI · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 65,5 %GPT-5.6 Luna: 36,1 %Vals AIStand 29.10.2026
CyberBench v1.1Patch · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 85,7 %GPT-5.6 Luna: 83,9 %Vals AIStand 05.11.2026
EMBComps · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 76,4 %GPT-5.6 Luna: 54,6 %Vals AIStand 20.10.2026
Finance Agent (v2)Adjustments · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 54,5 %GPT-5.6 Luna: 52,0 %Vals AIStand 29.10.2026
IOIIOI 2024 · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 100 %GPT-5.6 Luna: 85 %Vals AIStand 29.10.2026
Legal Research BenchAdministrative / Regulatory · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 65,2 %GPT-5.6 Luna: 48,5 %Vals AIStand 05.11.2026
LMArena Text, Style ControlBusiness, management and finance · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.495GPT-5.6 Luna: 1.462LMArenaStand 28.10.2026
LMArena Vision, Style ControlCreative writing with images · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.287GPT-5.6 Luna: 1.257LMArenaStand 19.10.2026
ProgramBenchAlmost Resolved · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 65 %GPT-5.6 Luna: 9 %Vals AIStand 05.11.2026
SRE BenchCapability Score · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 53,6 %GPT-5.6 Luna: 6,4 %Vals AIStand 05.11.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 30 %GPT-5.6 Luna: 10 %Vals AIStand 05.11.2026
Terminal-Bench 4.0Hardware · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 60 %GPT-5.6 Luna: 0 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceEarth Sciences · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 37,5 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
Vals Science IndexBioMysteryBench · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 79,3 %GPT-5.6 Luna: 61,5 %Vals AIStand 25.10.2026
BioMysteryBenchHuman-solvable · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 86,8 %GPT-5.6 Luna: 69,4 %Vals AIStand 05.11.2026
Code MigrationCOBOL · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 70 %GPT-5.6 Luna: 70 %Vals AIStand 29.10.2026
CyberBench v1.1PoC · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 25,0 %GPT-5.6 Luna: 63,3 %Vals AIStand 05.11.2026
EMBDataroom · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 84,9 %GPT-5.6 Luna: 83,0 %Vals AIStand 20.10.2026
Finance Agent (v2)All-Pass · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 48,1 %GPT-5.6 Luna: 43,3 %Vals AIStand 29.10.2026
IOIIOI 2025 · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 100,0 %GPT-5.6 Luna: 49,8 %Vals AIStand 29.10.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 85,4 %GPT-5.6 Luna: 87,5 %Vals AIStand 05.11.2026
LMArena Text, Style ControlChinese · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.574GPT-5.6 Luna: 1.478LMArenaStand 28.10.2026
LMArena Vision, Style ControlDiagram understanding · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.330GPT-5.6 Luna: 1.280LMArenaStand 19.10.2026
ProgramBenchFully Resolved · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 18,5 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
SRE BenchFully Solved · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 33,6 %GPT-5.6 Luna: 1,5 %Vals AIStand 05.11.2026
Tax Agent BenchControversy & Precedence Analysis (weighted pass) · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 66,9 %GPT-5.6 Luna: 61,2 %Vals AIStand 05.11.2026
Terminal-Bench 4.0Media · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 75 %GPT-5.6 Luna: 0 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceEngineering Sciences · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 22,2 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
Vals Science IndexMysteryMechanism · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 49,6 %GPT-5.6 Luna: 14,4 %Vals AIStand 25.10.2026
Code MigrationCode Quality · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 4,541 / 5GPT-5.6 Luna: 3,195 / 5Vals AIStand 29.10.2026
EMBDCF · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 70,1 %GPT-5.6 Luna: 60,5 %Vals AIStand 20.10.2026
Finance Agent (v2)Comparables · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 45,8 %GPT-5.6 Luna: 48,3 %Vals AIStand 29.10.2026
IOIIOI 2026 · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 85,2 %GPT-5.6 Luna: 50,5 %Vals AIStand 29.10.2026
Legal Research BenchBusiness & Commercial · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 48,8 %GPT-5.6 Luna: 32,6 %Vals AIStand 05.11.2026
LMArena Text, Style ControlCoding · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.551GPT-5.6 Luna: 1.502LMArenaStand 28.10.2026
LMArena Vision, Style ControlEnglish · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 1.284GPT-5.6 Luna: 1.262LMArenaStand 19.10.2026
ProgramBenchRaw Pass Rate · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 87,0 %GPT-5.6 Luna: 68,3 %Vals AIStand 05.11.2026
Tax Agent BenchCurrent & Temporal Analysis · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 46,6 %GPT-5.6 Luna: 33,0 %Vals AIStand 05.11.2026
Terminal-Bench 4.0ML · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 81,8 %GPT-5.6 Luna: 18,2 %Vals AIStand 05.11.2026
Terminal-Bench-ScienceLife Sciences · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 52,6 %GPT-5.6 Luna: 0,0 %Vals AIStand 05.11.2026
Vals Science IndexTerminal-Bench-Science · höher ist besserTestaufbau nicht identisch dokumentiertClaude Opus 5.5: 47,1 %GPT-5.6 Luna: 0,0 %Vals AIStand 25.10.2026

Weitere Vergleiche

Vergleiche Claude Opus 5.5 und GPT-5.6 Luna mit den Modellen, die am häufigsten mit ihnen verglichen werden.

Anderes Duell vergleichen

Die beliebtesten Vergleiche

  1. 1Claude Opus 5.5 vs. GPT-6 Astra
  2. 2Claude Opus 5.5 vs. Claude Sonnet 5.5
  3. 3Claude Opus 5.5 vs. DeepSeek-V4-Pro
  4. 4Claude Opus 5.5 vs. Kimi K3.1 Pro
  5. 5Claude Opus 5.5 vs. Gemini 4 Argon
  6. 6Claude Opus 5.5 vs. Gemini 3.8 Flash
  7. 7Claude Opus 5.5 vs. Claude Fable 5.1
  8. 8Claude Opus 5.5 vs. DeepSeek-V4.1-Flash
  9. 9Claude Opus 5.5 vs. Qwen 3.8 Max 0902
Alle 70 Vergleiche zeigen
  1. 10Claude Opus 5.5 vs. GLM-5.3-Flash
  2. 11Claude Opus 5.5 vs. GPT-6.1 Sol
  3. 12Claude Opus 5.5 vs. Kimi K3
  4. 13Claude Opus 5.5 vs. Claude Sonnet 5
  5. 14Claude Opus 5.5 vs. Claude Haiku 5.5
  6. 15Claude Opus 5.5 vs. GLM-5.3
  7. 16Claude Opus 5.5 vs. GPT-5.6 Terra
  8. 17Claude Opus 5.5 vs. Gemini 3.1 Pro Preview
  9. 18Claude Opus 5.5 vs. Claude Opus 4.6
  10. 19Claude Opus 5.5 vs. Claude Sonnet 4.6
  11. 20Claude Opus 5.5 vs. Qwen 3.8 27B
  12. 21Claude Opus 5.5 vs. Grok 4.6
  13. 22Claude Opus 5.5 vs. GLM-5.2
  14. 23Claude Opus 5.5 vs. Gemini 4 Carbon
  15. 24Claude Opus 5.5 vs. DeepSeek V4.1 Flash 1017
  16. 25Claude Opus 5.5 vs. Claude Sonnet 4.5
  17. 26Claude Opus 5.5 vs. Muse Spark 1.3
  18. 27Claude Opus 5.5 vs. Claude Opus 4.8
  19. 28GPT-5.6 Luna vs. Gemini 3.8 Flash
  20. 29Claude Opus 5.5 vs. Mistral Large 4
  21. 30Claude Opus 5.5 vs. GPT-5.6 Sol
  22. 31Claude Opus 5.5 vs. GPT-5.5
  23. 32GPT-5.6 Luna vs. GPT-5.4 mini
  24. 33GPT-6.1 Sol vs. GPT-5.6 Luna
  25. 34Claude Opus 5.5 vs. DeepSeek-V4-Flash
  26. 35Claude Sonnet 5.5 vs. GPT-5.6 Luna
  27. 36Claude Opus 5.5 vs. Grok 4.7
  28. 37Claude Haiku 5.5 vs. GPT-5.6 Luna
  29. 38Claude Opus 5.5 vs. Mistral Large 3
  30. 39Claude Opus 5.5 vs. GPT-6 Luna
  31. 40Claude Opus 5.5 vs. Claude Opus 4.5
  32. 41GPT-5.6 Luna vs. DeepSeek V4.1 Flash 1017
  33. 42Claude Opus 5.5 vs. Claude Fable 5
  34. 43Claude Opus 5.5 vs. GPT-6 Sol
  35. 44GPT-5.6 Luna vs. DeepSeek-V4.1-Flash
  36. 45Claude Opus 5.5 vs. Gemini 3.6 Flash
  37. 46Claude Opus 5.5 vs. Mistral Medium 3.5
  38. 47GPT-6 Sol vs. GPT-5.6 Luna
  39. 48Claude Opus 5.5 vs. Muse Wonder Full
  40. 49GPT-5.6 Luna vs. Qwen 3.8 27B
  41. 50GPT-5.6 Luna vs. Grok 4.7
  42. 51Claude Opus 5.5 vs. Claude Haiku 4.5
  43. 52GPT-5.6 Luna vs. DeepSeek-V4-Flash
  44. 53Claude Opus 5 vs. GPT-5.6 Luna
  45. 54Claude Opus 5.5 vs. Gemini 3.5 Flash
  46. 55Claude Opus 5.5 vs. GPT-6.1 Terra
  47. 56Claude Opus 5.5 vs. GPT-5.4
  48. 57Claude Sonnet 4.5 vs. GPT-5.6 Luna
  49. 58Claude Opus 5.5 vs. GLM-5.1
  50. 59GPT-5.6 Luna vs. Gemini 3.7 Flash
  51. 60Claude Sonnet 5 vs. GPT-5.6 Luna
  52. 61GPT-5.6 Sol vs. GPT-5.6 Luna
  53. 62GPT-5.6 Luna vs. Gemini 3.1 Pro Preview
  54. 63GPT-5.6 Luna vs. GLM-5.3-Flash
  55. 64GPT-5.6 Luna vs. Mistral Large 4
  56. 65GPT-5.6 Luna vs. GPT-5.4
  57. 66Claude Haiku 4.5 vs. GPT-5.6 Luna
  58. 67GPT-5.6 Luna vs. GPT-5.5
  59. 68Claude Opus 4.5 vs. GPT-5.6 Luna
  60. 69GPT-6.1 Terra vs. GPT-5.6 Luna
  61. 70GPT-5.6 Luna vs. Gemini 4 Argon