Claude Opus 5.5
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Opus 5.5 | GLM-5.1 |
|---|---|---|
| Anbieter | Anthropic | Z.ai |
| Erschienen | 22. Sept. 2026 | 7. Apr. 2026 |
| Verfügbarkeit | Aktiv | Open Source |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 744 Mrd., 40 Mrd. aktiv |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1.000.000 Token | 200.000 Token |
| Wissensstand | Juni 2026 | Nicht veröffentlicht |
| Technische Quellen | Modell | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Opus 5.5 | GLM-5.1 |
|---|---|---|
| API-Eingabe | 4 $ | 1,4 $ |
| API-Ausgabe | 20 $ | 4,4 $ |
| Cache lesen | 0,2 $ | 0,26 $ |
| Cache schreiben (5 Min.) | 5 $ | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | 8 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle17.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/eu-west-1 | 4,4 $ | 22 $ | Quelle17.10.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 4,4 $ | 22 $ | Quelle17.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle17.10.2026 | |
| Anthropic | Über OpenRouteranthropic/fast | 8 $ | 40 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/global | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/us | 4,4 $ | 22 $ | Quelle17.10.2026 | |
| Claude Platform on AWS | Über OpenRouterclaude-on-aws | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle17.10.2026 | |
| Über OpenRoutergoogle-vertex/europe | 4,4 $ | 22 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 4 $ | Günstigster erfasster Preis: 20 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/us | 4,4 $ | 22 $ | Quelle17.10.2026 | ||
| GLM-5.1 | Z.ai | Direkt beim EntwicklerStandard-API | 1,4 $ | 4,4 $ | Quelle22.09.2026 |
| Alibaba | Über OpenRouteralibaba/fp8 | 1,33 $ | 4,18 $ | Quelle17.10.2026 | |
| AtlasCloud | Über OpenRouteratlas-cloud/fp8 | 1,26 $ | 3,96 $ | Quelle17.10.2026 | |
| Baidu | Über OpenRouterbaidu/fp8 | Günstigster erfasster Preis: 0,9646 $ | Günstigster erfasster Preis: 3,0316 $ | Quelle17.10.2026 | |
| Chutes | Über OpenRouterchutes/fp8 | 0,98 $ | 3,08 $ | Quelle17.10.2026 | |
| Friendli | Über OpenRouterfriendli | 1,4 $ | 4,4 $ | Quelle17.10.2026 | |
| GMICloud | Über OpenRoutergmicloud/fp8 | 1,4 $ | 4,4 $ | Quelle17.10.2026 | |
| Nebius | Über OpenRouternebius/fp8 | 1,4 $ | 4,4 $ | Quelle17.10.2026 | |
| Novita | Über OpenRouternovita/fp8 | 1,38 $ | 4,4 $ | Quelle17.10.2026 | |
| Phala | Über OpenRouterphala | 1,21 $ | 4,2 $ | Quelle17.10.2026 | |
| SiliconFlow | Über OpenRoutersiliconflow/fp8 | 1,19 $ | 3,74 $ | Quelle17.10.2026 | |
| StreamLake | Über OpenRouterstreamlake/fp8 | 0,966 $ | 3,036 $ | Quelle17.10.2026 | |
| Venice | Über OpenRoutervenice/fp8 | 1,4014 $ | 4,4044 $ | Quelle17.10.2026 | |
| Z.AI | Über OpenRouterz-ai/fp8 | 1,4 $ | 4,4 $ | Quelle17.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Opus 5.5 | GLM-5.1 | Quelle |
|---|---|---|---|
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert66,646 % | 25,768 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert58,587 % | 44,792 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert3,75 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert50,481 % | 27,885 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-max, Reasoning: max, Harness: Arena Code Arena WebDev GLM-5.1: Snapshot: glm-5.1, Harness: Arena Code Arena WebDevClaude Opus 5.5: Arena-Bewertung aus 2.597 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 10.746 veröffentlichten Paarvergleichen. | Höherer Messwert1.811,149 95-%-Konfidenzintervall: ±14,586Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.508,395 95-%-Konfidenzintervall: ±6,771Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 7.687 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 62.175 veröffentlichten Paarvergleichen. | Höherer Messwert1.508,083 95-%-Konfidenzintervall: ±7,535Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.465,374 95-%-Konfidenzintervall: ±3,602Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 30.000 tokens | Höherer Messwert49,797 % | 41,604 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 30.000 tokens | Höherer Messwert91,43 % | 72,27 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert18,5 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Public Benefits Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert70,636 % | 61,84 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert87,64 % | 56,929 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Harness: OpenHands, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert90,294 % | 31,456 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert65,528 % | 18,833 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert54,528 % | 43,276 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert82,246 % | 71,377 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert65,152 % | 31,818 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-max, Reasoning: max, Harness: Arena Code Arena WebDev GLM-5.1: Snapshot: glm-5.1, Harness: Arena Code Arena WebDevClaude Opus 5.5: Arena-Bewertung aus 2.597 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 10.746 veröffentlichten Paarvergleichen. | Höherer Messwert1.811,149 95-%-Konfidenzintervall: ±14,586Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.508,395 95-%-Konfidenzintervall: ±6,771Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 1.370 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 12.030 veröffentlichten Paarvergleichen. | Höherer Messwert1.492,054 95-%-Konfidenzintervall: ±16,446Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.465,499 95-%-Konfidenzintervall: ±6,25Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert65 % | 1 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert100 % | 83,333 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Code MigrationCOBOLTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert70 % | 46,571 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)All-PassTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert48,111 % | 32,68 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchAdministrative / Regulatory · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert85,427 % | 80,005 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-max, Reasoning: max, Harness: Arena Code Arena WebDev GLM-5.1: Snapshot: glm-5.1, Harness: Arena Code Arena WebDevClaude Opus 5.5: Arena-Bewertung aus 122 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 1.210 veröffentlichten Paarvergleichen. | Höherer Messwert1.762,971 95-%-Konfidenzintervall: ±64,035Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.509,083 95-%-Konfidenzintervall: ±18,189Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 704 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 4.311 veröffentlichten Paarvergleichen. | Höherer Messwert1.574,432 95-%-Konfidenzintervall: ±22,751Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.512,757 95-%-Konfidenzintervall: ±9,666Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchFully ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert18,5 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1HardTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert81,111 % | 37,778 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Code MigrationCode QualityTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: mean reviewer code-quality ratingBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert4,541 / 5 | 3,544 / 5 | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)ComparablesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert45,756 % | 41,557 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert82,969 % | 53,405 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchBusiness & Commercial · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert48,837 % | 23,256 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevWebdev-reactTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-max, Reasoning: max, Harness: Arena Code Arena WebDev GLM-5.1: Snapshot: glm-5.1, Harness: Arena Code Arena WebDevClaude Opus 5.5: Arena-Bewertung aus 1.788 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 8.193 veröffentlichten Paarvergleichen. | Höherer Messwert1.859,041 95-%-Konfidenzintervall: ±18,379Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.505,232 95-%-Konfidenzintervall: ±7,631Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 1.755 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 16.961 veröffentlichten Paarvergleichen. | Höherer Messwert1.545,148 95-%-Konfidenzintervall: ±14,437Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.512,302 95-%-Konfidenzintervall: ±5,549Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchRaw Pass RateTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: raw test pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert86,986 % | 50,879 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 2.1MediumTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert90,303 % | 65,455 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Finance Agent (v2)Disclosure AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert71,045 % | 52,713 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchBusiness & Commercial · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | 70,961 % | Höherer Messwert81,655 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 1.834 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 12.127 veröffentlichten Paarvergleichen. | Höherer Messwert1.517,113 95-%-Konfidenzintervall: ±15,408Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.447,334 95-%-Konfidenzintervall: ±6,452Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)Earnings AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert77,992 % | 56,958 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkBanking Finance · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert88,848 % | 71,004 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchCivil Litigation · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert48,148 % | 22,222 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 2.927 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 26.692 veröffentlichten Paarvergleichen. | Höherer Messwert1.511,808 95-%-Konfidenzintervall: ±11,435Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.480,944 95-%-Konfidenzintervall: ±4,656Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)Financial ModelingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert26,886 % | 13,466 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkBanking Finance · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchCivil Litigation · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | 74,02 % | Höherer Messwert83,513 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 2.079 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 14.753 veröffentlichten Paarvergleichen. | Höherer Messwert1.495,048 95-%-Konfidenzintervall: ±14,18Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.442,133 95-%-Konfidenzintervall: ±5,949Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)General Qualitative AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert67,773 % | 63,665 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkBankruptcy Restructuring · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | 69,896 % | Höherer Messwert75,433 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchConstitutional / Civil Rights · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert42,105 % | 34,211 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 5.667 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 46.453 veröffentlichten Paarvergleichen. | Höherer Messwert1.526,972 95-%-Konfidenzintervall: ±10,377Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.471,538 95-%-Konfidenzintervall: ±4,716Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)General Quantitative AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert79,293 % | 61,87 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkBankruptcy Restructuring · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchConstitutional / Civil Rights · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert85,038 % | 84,883 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 853 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 6.634 veröffentlichten Paarvergleichen. | Höherer Messwert1.539,07 95-%-Konfidenzintervall: ±20,663Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.495,565 95-%-Konfidenzintervall: ±7,941Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)Market AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert69,422 % | 51,861 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkCapital Markets · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert90,196 % | 71,765 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchCriminal · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert42,105 % | 29,825 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 256 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 2.199 veröffentlichten Paarvergleichen. | Höherer Messwert1.508,919 95-%-Konfidenzintervall: ±37,17Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.482,622 95-%-Konfidenzintervall: ±14,364Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Finance Agent (v2)PrecedentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert34,59 % | 17,764 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkCapital Markets · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchCriminal · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Opus 5.5: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GLM-5.1: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert82,909 % | 78,143 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 5.5: Snapshot: claude-opus-5.5-high, Reasoning: high, Harness: Arena Text, style control GLM-5.1: Snapshot: glm-5.1, Harness: Arena Text, style controlClaude Opus 5.5: Arena-Bewertung aus 4.793 veröffentlichten Paarvergleichen.GLM-5.1: Arena-Bewertung aus 40.763 veröffentlichten Paarvergleichen. | Höherer Messwert1.531,777 95-%-Konfidenzintervall: ±9,284Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.488,92 95-%-Konfidenzintervall: ±4,198Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
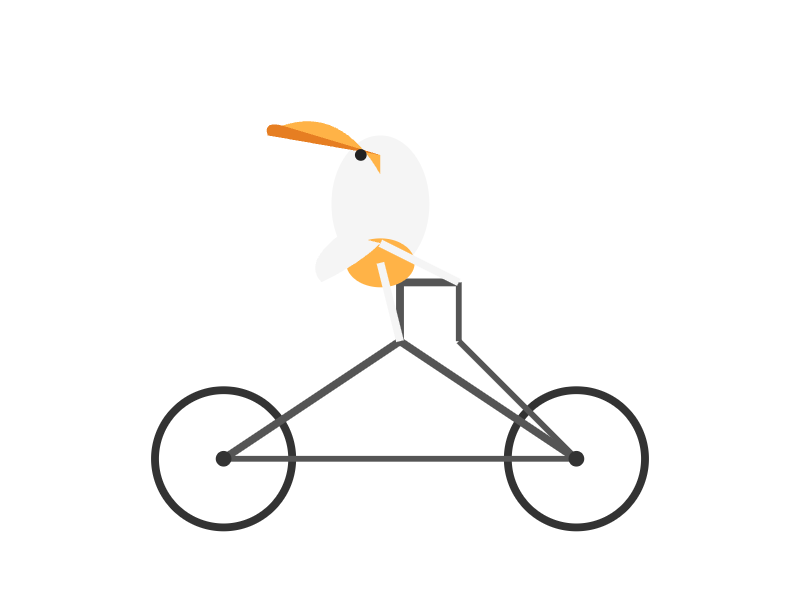
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 5.5
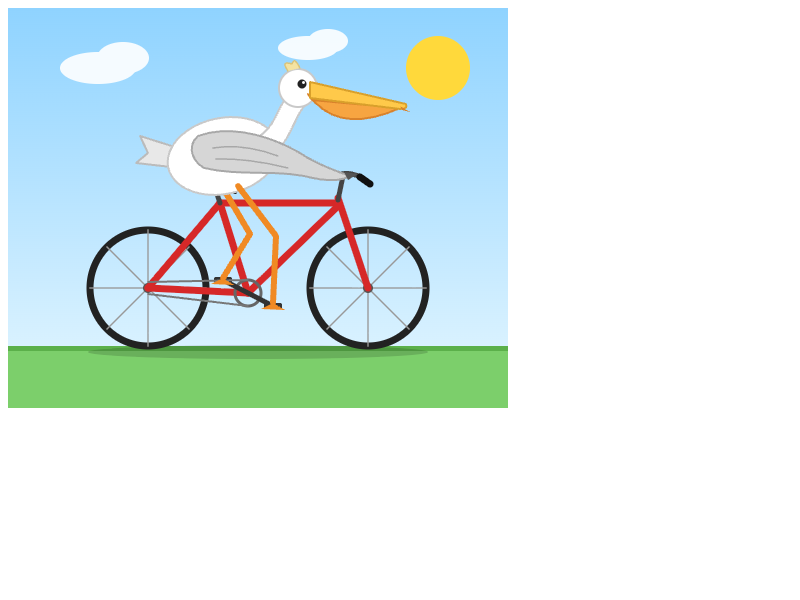
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GLM-5.1
Ausgabe aus Sicherheitsgründen nicht dargestellt
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Opus 5.5 und GLM-5.1 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.