Zum Hauptinhalt springen

Direktvergleich

GPT-5.6 Terra vs. Kimi K3

Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.

gemeinsame Messreihen
201
verschiedene Benchmarks
31
jüngster Abruf
29.09.2026

Modellauswahl ändern

Steckbrief

Allgemeine Daten

Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.

Allgemeine Daten von GPT-5.6 Terra und Kimi K3
MerkmalGPT-5.6 TerraKimi K3
AnbieterOpenAIMoonshot AI
Erschienen9. Juli 202616. Juli 2026
VerfügbarkeitAktivAktiv
ModelltypProprietärOpen Weights
ParameterNicht veröffentlicht2,8 Billionen, 104 Mrd. aktiv
ArchitekturNicht veröffentlichtMixture of Experts
Kontextfenster1.050.000 Token1.048.576 Token
Wissensstand16. Februar 2026Nicht veröffentlicht
Technische QuellenModell, Kontext, WissensstandModell

Kosten

API-Preise im Vergleich

Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.

API-Preise von GPT-5.6 Terra und Kimi K3
PreisartGPT-5.6 TerraKimi K3
API-Eingabe2 $ ≤272K / 4 $ >272K3 $
API-Ausgabe12 $ ≤272K / 18 $ >272K15 $
Cache lesen0,2 $ ≤272K / 0,4 $ >272K0,3 $
Cache schreiben (5 Min.)2,5 $ ≤272K / 5 $ >272KNicht ausgewiesen
Cache schreiben (1 Std.)Nicht ausgewiesenNicht ausgewiesen
Preis geprüft22.09.2026 Quelle22.09.2026 Quelle
GPT-5.6 TerraKimi K3
API-EingabeUSD pro 1 Mio. Token, Basistarif
GPT-5.6 TerraGünstiger2 $
Kimi K33 $
API-AusgabeUSD pro 1 Mio. Token, Basistarif
GPT-5.6 TerraGünstiger12 $
Kimi K315 $
Cache lesenUSD pro 1 Mio. Token, Basistarif
GPT-5.6 TerraGünstiger0,2 $
Kimi K30,3 $

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Preise nach Anbieter

Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.

Anbieterpreise von GPT-5.6 Terra und Kimi K3
ModellAnbieterBezugsweg und TarifEingabe pro 1 Mio. TokenAusgabe pro 1 Mio. TokenQuelle
GPT-5.6 TerraOpenAIDirekt beim EntwicklerBis 272.000 Kontext-Token2 $12 $Quelle22.09.2026
OpenAIDirekt beim EntwicklerÜber 272.000 Kontext-Token4 $18 $Quelle22.09.2026
Amazon BedrockÜber OpenRouteramazon-bedrock/us-east-12,2 $13,2 $Quelle02.10.2026
AzureÜber OpenRouterazure2 $12 $Quelle02.10.2026
AzureÜber OpenRouterazure/eu2,2 $13,2 $Quelle02.10.2026
AzureÜber OpenRouterazure/us2,2 $13,2 $Quelle02.10.2026
OpenAIÜber OpenRouteropenai2 $12 $Quelle02.10.2026
OpenAIÜber OpenRouteropenai/fast4 $24 $Quelle02.10.2026
OpenAIÜber OpenRouteropenai/flexGünstigster erfasster Preis: 1 $Günstigster erfasster Preis: 6 $Quelle02.10.2026
Kimi K3Moonshot AIDirekt beim EntwicklerStandard-API3 $15 $Quelle22.09.2026
AkashMLÜber OpenRouterakashml/fp43 $15 $Quelle02.10.2026
AlibabaÜber OpenRouteralibaba3,45 $17,25 $Quelle02.10.2026
BaseTenÜber OpenRouterbaseten/fp83 $15 $Quelle02.10.2026
ChutesÜber OpenRouterchutes/mxfp43 $15 $Quelle02.10.2026
DecartÜber OpenRouterdecart/mxfp43 $15 $Quelle02.10.2026
DeepInfraÜber OpenRouterdeepinfra/bf162,85 $14,25 $Quelle02.10.2026
DigitalOceanÜber OpenRouterdigitalocean2,55 $12,95 $Quelle02.10.2026
FireworksÜber OpenRouterfireworks3 $15 $Quelle02.10.2026
FireworksÜber OpenRouterfireworks/fast4,5 $22,5 $Quelle02.10.2026
FireworksÜber OpenRouterfireworks/us4,5 $22,5 $Quelle02.10.2026
InferenceNetÜber OpenRouterinference-net/fp4Günstigster erfasster Preis: 1,34 $13 $Quelle02.10.2026
MakoraÜber OpenRoutermakora2,04 $12,75 $Quelle02.10.2026
ModalÜber OpenRoutermodal/mxfp43 $15 $Quelle02.10.2026
Moonshot AIÜber OpenRoutermoonshotai/mxfp43 $15 $Quelle02.10.2026
MorphÜber OpenRoutermorph/fp81,35 $11,357 $Quelle02.10.2026
ParasailÜber OpenRouterparasail/fp43 $15 $Quelle02.10.2026
PhalaÜber OpenRouterphala2,25 $11,25 $Quelle02.10.2026
RelaceÜber OpenRouterrelace/fp41,8 $Günstigster erfasster Preis: 11,2 $Quelle02.10.2026
Sail ResearchÜber OpenRoutersail-research/fp42,8 $14 $Quelle02.10.2026
TogetherÜber OpenRoutertogether2,7 $13,5 $Quelle02.10.2026
WaferÜber OpenRouterwafer1,4417 $14 $Quelle02.10.2026
WaferÜber OpenRouterwafer/us2,8 $14 $Quelle02.10.2026

Leistung

Gemeinsame Benchmarks

Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.

Fähigkeitsprofil aus vergleichbaren Benchmarks

Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.

255075100CodingReasoningMathematikWissenFinanzenRechtAgenten-AufgabenMultimodal
GPT-5.6 Terra
Kimi K3
Coding: 86,6 / 79,4 (8 Benchmarkfamilien)
Reasoning: 97,8 / 100 (1 Benchmarkfamilie)
Mathematik: 85,1 / 100 (1 Benchmarkfamilie)
Wissen: 98,5 / 100 (1 Benchmarkfamilie)
Finanzen: 97,7 / 99,6 (6 Benchmarkfamilien)
Recht: 66,7 / 100 (3 Benchmarkfamilien)
Agenten-Aufgaben: 95,8 / 100 (1 Benchmarkfamilie)
Multimodal: 98,1 / 100 (1 Benchmarkfamilie)

32 passende Messreihen aus 29 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 14 vergleichbaren Kategorien.

GPT-5.6 TerraKimi K3
Code MigrationOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 TerraGewinner47,804 %
Kimi K316,099 %
CorpFin v2Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra65,307 %
Kimi K3Gewinner71,562 %
CyberBench v1.1Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra72,084 %
Kimi K3Gewinner75,238 %
EMBOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra66,205 %
Kimi K3Gewinner66,399 %
Finance Agent (v2)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 TerraGewinner54,436 %
Kimi K354,36 %
GPQA DiamondOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra90,909 %
Kimi K3Gewinner92,929 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra0,833 %
Kimi K3Gewinner10,833 %
IOIOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 TerraGewinner87,611 %
Kimi K348,944 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra41,346 %
Kimi K3Gewinner44,231 %
LegalBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra85,105 %
Kimi K3Gewinner86,016 %
LiveCodeBench v6Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.6 Terra85,93 %
Kimi K3Gewinner87,185 %
LMArena Text, Style ControlOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 Terra1.465,012
Kimi K3Höherer Messwert1.487,964

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Benchmarkwerte von GPT-5.6 Terra und Kimi K3
Benchmark und AufgabeGPT-5.6 TerraKimi K3Quelle
Code MigrationOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner47,804 %
16,099 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
CorpFin v2Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
65,307 %
Gewinner71,562 %
Vals AI
Quellendetails
Datenstand: 12.08.2026
CyberBench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
72,084 %
Gewinner75,238 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
EMBOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
66,205 %
Gewinner66,399 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Finance Agent (v2)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner54,436 %
54,36 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
GPQA DiamondOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
90,909 %
Gewinner92,929 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Harvey's Legal Agent BenchmarkOverall · Task fully resolved
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besser
0,833 %
Gewinner10,833 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
IOIOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner87,611 %
48,944 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Legal Research BenchOverall · All-pass
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besser
41,346 %
Gewinner44,231 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
LegalBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
85,105 %
Gewinner86,016 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
LiveCodeBench v6Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
85,93 %
Gewinner87,185 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
LMArena Text, Style ControlOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control
Kimi K3: Snapshot: kimi-k3-max, Reasoning: max, Harness: Arena text, style control
GPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 35.323 anonymen Paarvergleichen.Kimi K3: Stilbereinigte Arena-Bewertung aus 26.400 anonymen Paarvergleichen.
1.465,012
95-%-Konfidenzintervall: ±4,484Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Höherer Messwert1.487,964
95-%-Konfidenzintervall: ±4,866Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 25.09.2026
MedCodeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
43,414 %
Gewinner48,884 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MedScribeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
82,869 %
Gewinner87,958 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MMLU-ProOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
86,659 %
Gewinner87,973 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
MMMU-ProOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
86,474 %
Gewinner88,15 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
MortgageTaxOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner67,329 %
66,336 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
ProgramBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
0,5 %
Gewinner2 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
ProofBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
74 %
Gewinner87 %
Vals AI
Quellendetails
Datenstand: 28.09.2026
Public Benefits Bench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
62,382 %
Gewinner68,268 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
SAGEOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
47,003 %
Gewinner54,26 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
SWE-bench VerifiedOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner95,4 %
93,4 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Tax Agent BenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
65,199 %
Gewinner68,672 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
TaxEval v2Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
Gewinner76,166 %
75,716 %
Vals AI
Quellendetails
Datenstand: 01.09.2026
Terminal-Bench 2.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besser
77,528 %
Gewinner80,899 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Terminal-Bench 4.0Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besser
Gewinner26,263 %
12,626 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Terminal-Bench ScienceOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner10 %
2,857 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vals IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: weighted index scoreBewertung: Mehr ist besser
Gewinner59,588 %
57,813 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vals Multimodal IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.2Messgröße: weighted index scoreBewertung: Mehr ist besser
65,07 %
Gewinner73,42 %
Vals AI
Quellendetails
Datenstand: 11.08.2026
Vibe Code Bench 1-100Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands
14,822 %
Gewinner18,244 %
Vals AI
Quellendetails
Datenstand: 22.09.2026
Vibe Code Bench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands
74,594 %
Gewinner84,963 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
CorpFin v2Exact Pages
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
63,17 %
Höherer Messwert69,347 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
EMBComps
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
72,539 %
Höherer Messwert72,685 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
Finance Agent (v2)Adjustments
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
50,442 %
Höherer Messwert51,461 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
GPQA DiamondFew-Shot CoT
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
89,899 %
Höherer Messwert93,434 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passed
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
76,449 %
Höherer Messwert87,319 %
Vals AI
Quellendetails
Datenstand: 07.08.2026
Legal Research BenchAdministrative / Regulatory · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Höherer Messwert57,576 %
54,545 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
LegalBenchConclusion Tasks
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
90,327 %
Höherer Messwert90,733 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
LiveCodeBench v6Easy
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
97,205 %
Höherer Messwert98,758 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
LMArena Text, Style ControlBusiness, management and finance
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control
Kimi K3: Snapshot: kimi-k3-max, Reasoning: max, Harness: Arena text, style control
GPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 6.719 anonymen Paarvergleichen.Kimi K3: Stilbereinigte Arena-Bewertung aus 5.149 anonymen Paarvergleichen.
1.465,595
95-%-Konfidenzintervall: ±8,012Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Höherer Messwert1.489,173
95-%-Konfidenzintervall: ±8,766Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 25.09.2026
MMLU-ProBiology
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
93,026 %
Höherer Messwert93,863 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
MortgageTaxNumerical Extraction
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
74,324 %
Höherer Messwert78,855 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
ProgramBenchAlmost Resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
6,5 %
Höherer Messwert17,5 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
SAGEAutomata
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 30.000 tokens
38,889 %
Höherer Messwert44,048 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
SWE-bench Verified<15 min fix
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
77,835 %
Höherer Messwert92,268 %
Vals AI
Quellendetails
Datenstand: 08.08.2026
TaxEval v2Correctness
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Höherer Messwert65,822 %
65,331 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
Terminal-Bench 2.1Easy
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
83,333 %
Höherer Messwert91,667 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
Vals IndexCorpFin v2
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.2Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
66,434 %
Höherer Messwert72,611 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
Vals Multimodal IndexCorpFin v2
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.2Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
66,434 %
Höherer Messwert72,611 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
CorpFin v2Max Fitting Context
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
66,317 %
Höherer Messwert72,727 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
EMBDataroom
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
81,591 %
Höherer Messwert85,13 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
Finance Agent (v2)All-Pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
40,448 %
Höherer Messwert41,69 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
GPQA DiamondZero-Shot CoT
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
91,919 %
Höherer Messwert92,424 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Kein direkter Sieger0 %
Vals AI
Quellendetails
Datenstand: 07.08.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
86,696 %
Höherer Messwert90,731 %
Vals AI
Quellendetails
Datenstand: 06.08.2026
LegalBenchInterpretation Tasks
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Höherer Messwert83,178 %
82,612 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
LiveCodeBench v6Hard
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
72,857 %
Höherer Messwert74,286 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
LMArena Text, Style ControlChinese
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control
Kimi K3: Snapshot: kimi-k3-max, Reasoning: max, Harness: Arena text, style control
GPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 2.786 anonymen Paarvergleichen.Kimi K3: Stilbereinigte Arena-Bewertung aus 1.940 anonymen Paarvergleichen.
1.515,521
95-%-Konfidenzintervall: ±11,87Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Höherer Messwert1.539,78
95-%-Konfidenzintervall: ±13,819Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 25.09.2026
MMLU-ProBusiness
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
90,875 %
Höherer Messwert92,015 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
MortgageTaxSemantic Extraction
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Höherer Messwert60,334 %
53,816 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
ProgramBenchFully Resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
0,5 %
Höherer Messwert2 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
SAGECalculus
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 30.000 tokens
59,259 %
Höherer Messwert75,617 %
Vals AI
Quellendetails
Datenstand: 09.08.2026
SWE-bench Verified>4 hours
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
33,333 %
Höherer Messwert66,667 %
Vals AI
Quellendetails
Datenstand: 08.08.2026
TaxEval v2Stepwise Reasoning
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens
Kimi K3: Temperatur: 1, Ausgabegrenze: 262.144 tokens
Höherer Messwert86,509 %
86,1 %
Vals AI
Quellendetails
Datenstand: 09.08.2026

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Eigene Modelltests

Unsere Tests

Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.

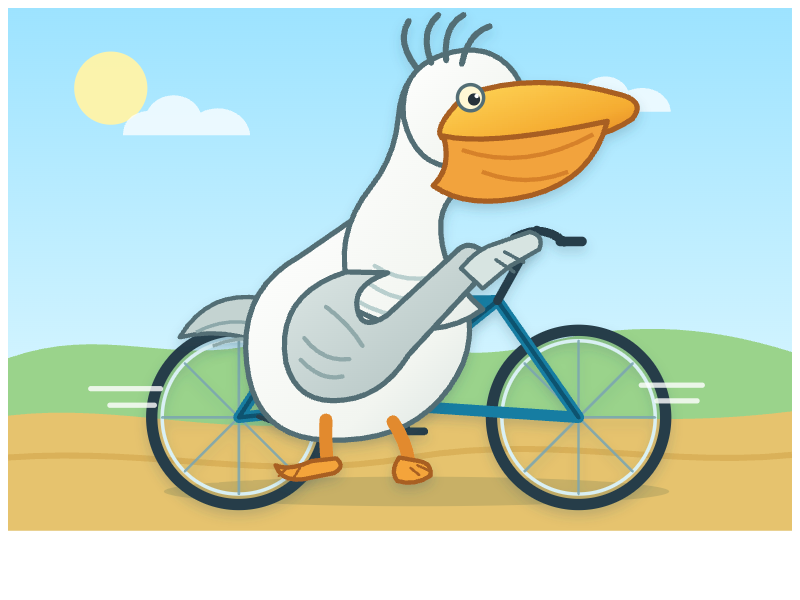
Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

GPT-5.6 Terra

GPT-5.6 Terra: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.6-terra
API-Modell laut Antwort
openai/gpt-5.6-terra
Reasoning-Einstellung
high
Festgelegter Endpunkt
OpenAI | openai/gpt-5.6-terra-20260709
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
64,6 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Kimi K3

In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.

Reasoning (angefragt): high

Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
moonshotai/kimi-k3
Reasoning-Einstellung
high
Festgelegter Endpunkt
Moonshot AI | moonshotai/kimi-k3-20260715
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)

So liest du den Vergleich

Ein Benchmark-Sieg ist kein Gesamturteil

Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.

Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.

Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.

Weitere Duelle

Vergleiche GPT-5.6 Terra und Kimi K3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.
Zum vollständigen LLM-Vergleich