Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
29
verschiedene Benchmarks
1
jüngster Abruf
04.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Allgemeine Daten von GPT-5.6 Terra und Mistral Large 3
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Anbieterpreise von GPT-5.6 Terra und Mistral Large 3
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
GPT-5.6 TerraMistral Large 3
LMArena Text, Style ControlOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.466,233
Mistral Large 31.413,556
LMArena Text, Style ControlBusiness, management and finance. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.467,133
Mistral Large 31.412,721
LMArena Text, Style ControlChinese. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.518,544
Mistral Large 31.431,759
LMArena Text, Style ControlCoding. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.518,601
Mistral Large 31.468,587
LMArena Text, Style ControlCreative writing. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.426,255
Mistral Large 31.375,017
LMArena Text, Style ControlEnglish. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.470,27
Mistral Large 31.426,818
LMArena Text, Style ControlEntertainment, sports and media. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.434,209
Mistral Large 31.373,228
LMArena Text, Style ControlExcluding ties. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.473,839
Mistral Large 31.400,876
LMArena Text, Style ControlExpert prompts. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.506,472
Mistral Large 31.423,349
LMArena Text, Style ControlFrench. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.505,538
Mistral Large 31.434,923
LMArena Text, Style ControlGerman. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.488,494
Mistral Large 31.404,512
LMArena Text, Style ControlHard prompts. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-5.6 TerraHöherer Messwert1.490,153
Mistral Large 31.431,026
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Benchmarkwerte von GPT-5.6 Terra und Mistral Large 3
Benchmark und Aufgabe
GPT-5.6 Terra
Mistral Large 3
Quelle
LMArena Text, Style ControlOverallTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 23.942 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 65.336 anonymen Paarvergleichen.
Höherer Messwert1.466,233
95-%-Konfidenzintervall: ±5,062Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.413,556
95-%-Konfidenzintervall: ±3,08Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 4.559 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 12.392 anonymen Paarvergleichen.
Höherer Messwert1.467,133
95-%-Konfidenzintervall: ±9,403Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.412,721
95-%-Konfidenzintervall: ±5,917Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 1.627 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 4.483 anonymen Paarvergleichen.
Höherer Messwert1.518,544
95-%-Konfidenzintervall: ±15,369Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.431,759
95-%-Konfidenzintervall: ±9,282Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 6.608 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 16.301 anonymen Paarvergleichen.
Höherer Messwert1.518,601
95-%-Konfidenzintervall: ±8,056Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.468,587
95-%-Konfidenzintervall: ±5,241Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 4.918 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 10.954 anonymen Paarvergleichen.
Höherer Messwert1.426,255
95-%-Konfidenzintervall: ±9,432Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.375,017
95-%-Konfidenzintervall: ±6,318Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 9.928 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 27.473 anonymen Paarvergleichen.
Höherer Messwert1.470,27
95-%-Konfidenzintervall: ±6,803Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.426,818
95-%-Konfidenzintervall: ±4,282Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlEntertainment, sports and mediaTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 6.035 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 13.723 anonymen Paarvergleichen.
Höherer Messwert1.434,209
95-%-Konfidenzintervall: ±8,525Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.373,228
95-%-Konfidenzintervall: ±5,71Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 17.956 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 47.430 anonymen Paarvergleichen.
Höherer Messwert1.473,839
95-%-Konfidenzintervall: ±6,594Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.400,876
95-%-Konfidenzintervall: ±4,294Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 2.711 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 5.705 anonymen Paarvergleichen.
Höherer Messwert1.506,472
95-%-Konfidenzintervall: ±11,876Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.423,349
95-%-Konfidenzintervall: ±8,346Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 778 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 1.858 anonymen Paarvergleichen.
Höherer Messwert1.505,538
95-%-Konfidenzintervall: ±22,869Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.434,923
95-%-Konfidenzintervall: ±15,523Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 382 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 1.080 anonymen Paarvergleichen.
Höherer Messwert1.488,494
95-%-Konfidenzintervall: ±30,154Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.404,512
95-%-Konfidenzintervall: ±19,03Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 15.816 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 39.237 anonymen Paarvergleichen.
Höherer Messwert1.490,153
95-%-Konfidenzintervall: ±5,922Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.431,026
95-%-Konfidenzintervall: ±3,848Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 6.463 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 16.526 anonymen Paarvergleichen.
Höherer Messwert1.488,472
95-%-Konfidenzintervall: ±8,092Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.438,338
95-%-Konfidenzintervall: ±5,247Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 8.484 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 20.253 anonymen Paarvergleichen.
Höherer Messwert1.462,94
95-%-Konfidenzintervall: ±7,323Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.399,916
95-%-Konfidenzintervall: ±4,811Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 345 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 661 anonymen Paarvergleichen.
Höherer Messwert1.473,022
95-%-Konfidenzintervall: ±33,642Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.382,813
95-%-Konfidenzintervall: ±24,568Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 507 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 1.118 anonymen Paarvergleichen.
Höherer Messwert1.416,233
95-%-Konfidenzintervall: ±26,862Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.355,204
95-%-Konfidenzintervall: ±19,178Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLegal and governmentTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 2.012 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 4.880 anonymen Paarvergleichen.
Höherer Messwert1.482,71
95-%-Konfidenzintervall: ±14,031Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.420,347
95-%-Konfidenzintervall: ±8,946Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLife, physical and social scienceTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 3.853 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 10.595 anonymen Paarvergleichen.
Höherer Messwert1.471,733
95-%-Konfidenzintervall: ±10,065Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.427,433
95-%-Konfidenzintervall: ±6,173Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 11.195 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 23.193 anonymen Paarvergleichen.
Höherer Messwert1.469,496
95-%-Konfidenzintervall: ±6,879Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.416,784
95-%-Konfidenzintervall: ±4,746Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 1.011 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 3.755 anonymen Paarvergleichen.
Höherer Messwert1.481,765
95-%-Konfidenzintervall: ±18,298Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.402,864
95-%-Konfidenzintervall: ±9,902Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 1.255 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 3.175 anonymen Paarvergleichen.
Höherer Messwert1.493,251
95-%-Konfidenzintervall: ±16,992Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.417,813
95-%-Konfidenzintervall: ±10,98Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlMedicine and healthcareTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 1.777 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 4.505 anonymen Paarvergleichen.
Höherer Messwert1.457,251
95-%-Konfidenzintervall: ±14,871Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.431,127
95-%-Konfidenzintervall: ±9,388Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 4.011 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 11.201 anonymen Paarvergleichen.
Höherer Messwert1.472,964
95-%-Konfidenzintervall: ±9,983Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.420,712
95-%-Konfidenzintervall: ±6,145Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 14.012 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 37.859 anonymen Paarvergleichen.
Höherer Messwert1.457,182
95-%-Konfidenzintervall: ±6,084Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.397,941
95-%-Konfidenzintervall: ±3,805Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 370 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 1.582 anonymen Paarvergleichen.
Höherer Messwert1.454,108
95-%-Konfidenzintervall: ±29,918Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.415,726
95-%-Konfidenzintervall: ±15,021Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 2.447 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 7.429 anonymen Paarvergleichen.
Höherer Messwert1.468,509
95-%-Konfidenzintervall: ±12,279Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.409,803
95-%-Konfidenzintervall: ±7,118Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlSoftware and IT servicesTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 9.456 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 24.350 anonymen Paarvergleichen.
Höherer Messwert1.504,665
95-%-Konfidenzintervall: ±6,999Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.456,163
95-%-Konfidenzintervall: ±4,498Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 668 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 1.998 anonymen Paarvergleichen.
Höherer Messwert1.466,207
95-%-Konfidenzintervall: ±23,702Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.406,852
95-%-Konfidenzintervall: ±14,343Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlWriting, literature and languageTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena text, style controlGPT-5.6 Terra: Stilbereinigte Arena-Bewertung aus 6.463 anonymen Paarvergleichen.Mistral Large 3: Stilbereinigte Arena-Bewertung aus 15.693 anonymen Paarvergleichen.
Höherer Messwert1.449,136
95-%-Konfidenzintervall: ±8,227Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.390,534
95-%-Konfidenzintervall: ±5,355Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Community-Tests zum Anschauen
Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
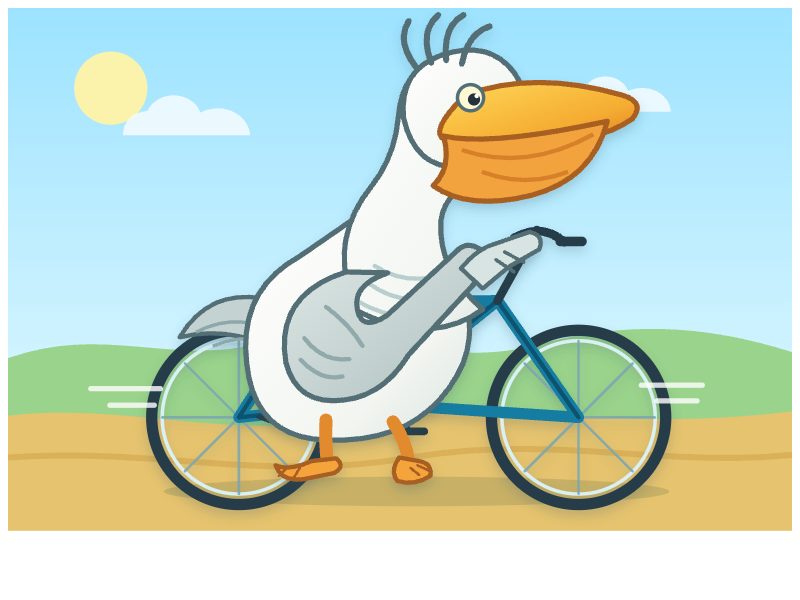
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-5.6 Terra
Community-Klassiker für eine freie SVG-Zeichnung.Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.6-terra
API-Modell laut Antwort
openai/gpt-5.6-terra
Festgelegter Endpunkt
OpenAI | openai/gpt-5.6-terra-20260709
Reasoning-Einstellung
high
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
64,6 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Mistral Large 3
In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.
Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
mistralai/mistral-large-2512
Festgelegter Endpunkt
Mistral | mistralai/mistral-large-2512
Reasoning-Einstellung
none
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche GPT-5.6 Terra und Mistral Large 3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.