GPT-6 Astra
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | GPT-6 Astra | Mistral Large 3 |
|---|---|---|
| Anbieter | OpenAI | Mistral AI |
| Erschienen | 3. Sept. 2026 | 2. Dez. 2025 |
| Verfügbarkeit | Eingeschränkter Zugang | Aktiv |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 675 Mrd., 41 Mrd. aktiv |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1.050.000 Token | 262.144 Token |
| Wissensstand | 30. April 2026 | Nicht veröffentlicht |
| Technische Quellen | Modell, Kontext | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | GPT-6 Astra | Mistral Large 3 |
|---|---|---|
| API-Eingabe | 10 $ ≤272K / 20 $ >272K | 0,5 $ |
| API-Ausgabe | 50 $ ≤272K / 75 $ >272K | 1,5 $ |
| Cache lesen | 1 $ ≤272K / 2 $ >272K | Nicht ausgewiesen |
| Cache schreiben (5 Min.) | 12,5 $ ≤272K / 25 $ >272K | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| GPT-6 Astra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 10 $ | 50 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 20 $ | 75 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-west-2 | 11 $ | 55 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure | 10 $ | 50 $ | Quelle19.10.2026 | |
| Azure | Über OpenRouterazure/us | 11 $ | 55 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai | 10 $ | 50 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 20 $ | 100 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle19.10.2026 | |
| OpenAI | Über OpenRouteropenai/ultrafast | 60 $ | 300 $ | Quelle19.10.2026 | |
| Mistral Large 3 | Mistral AI | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle22.09.2026 |
| Mistral | Über OpenRoutermistral/eu | 0,55 $ | 1,65 $ | Quelle19.10.2026 | |
| Mistral | Über OpenRoutermistral/zdr | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle19.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | GPT-6 Astra | Mistral Large 3 | Quelle |
|---|---|---|---|
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevGPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 11.674 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 83.498 veröffentlichten Paarvergleichen. | Höherer Messwert1.476,716 95-%-Konfidenzintervall: ±6,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.414,136 95-%-Konfidenzintervall: ±2,865Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 3.590 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 8.643 veröffentlichten Paarvergleichen. | Höherer Messwert1.285,988 95-%-Konfidenzintervall: ±10,782Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.199,757 95-%-Konfidenzintervall: ±7,981Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert46,367 % | 24,595 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevGPT-6 Astra: Arena-Bewertung aus 2.739 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.413 veröffentlichten Paarvergleichen. | Höherer Messwert1.731,395 95-%-Konfidenzintervall: ±13,296Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.361,78 95-%-Konfidenzintervall: ±17,387Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 2.061 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 15.540 veröffentlichten Paarvergleichen. | Höherer Messwert1.472,34 95-%-Konfidenzintervall: ±13,336Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.409,853 95-%-Konfidenzintervall: ±5,362Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 230 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 540 veröffentlichten Paarvergleichen. | Höherer Messwert1.357,126 95-%-Konfidenzintervall: ±39,572Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.211,728 95-%-Konfidenzintervall: ±27,072Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert37,302 % | 11,905 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevGPT-6 Astra: Arena-Bewertung aus 5.746 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.780,244 95-%-Konfidenzintervall: ±10,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 877 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 6.341 veröffentlichten Paarvergleichen. | Höherer Messwert1.514,537 95-%-Konfidenzintervall: ±19,541Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,609 95-%-Konfidenzintervall: ±7,919Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 367 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 807 veröffentlichten Paarvergleichen. | Höherer Messwert1.289,081 95-%-Konfidenzintervall: ±32,749Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.196,146 95-%-Konfidenzintervall: ±22,467Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
SAGECalculusTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert79,938 % | 0 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevGPT-6 Astra: Arena-Bewertung aus 1.129 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.780,13 95-%-Konfidenzintervall: ±22,887Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.238,427 95-%-Konfidenzintervall: ±26,132Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 2.659 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 21.009 veröffentlichten Paarvergleichen. | Höherer Messwert1.543,161 95-%-Konfidenzintervall: ±11,756Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.470,833 95-%-Konfidenzintervall: ±4,783Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 861 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.169 veröffentlichten Paarvergleichen. | Höherer Messwert1.310,509 95-%-Konfidenzintervall: ±20,739Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.235,106 95-%-Konfidenzintervall: ±13,517Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
SAGELinear AlgebraTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert62,117 % | 44,419 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 2.620 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 14.972 veröffentlichten Paarvergleichen. | Höherer Messwert1.449,578 95-%-Konfidenzintervall: ±12,436Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.373,958 95-%-Konfidenzintervall: ±5,611Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 1.205 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.983 veröffentlichten Paarvergleichen. | Höherer Messwert1.288,398 95-%-Konfidenzintervall: ±17,904Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.210,278 95-%-Konfidenzintervall: ±12,173Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
SAGEPartial Differential EquationsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Astra: Reasoning: max, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert39,683 % | 17,46 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 4.703 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 34.656 veröffentlichten Paarvergleichen. | Höherer Messwert1.485,113 95-%-Konfidenzintervall: ±9,08Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.426,99 95-%-Konfidenzintervall: ±3,961Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 480 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 891 veröffentlichten Paarvergleichen. | Höherer Messwert1.346,15 95-%-Konfidenzintervall: ±26,584Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.211,931 95-%-Konfidenzintervall: ±20,61Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 2.996 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 18.448 veröffentlichten Paarvergleichen. | Höherer Messwert1.458,633 95-%-Konfidenzintervall: ±11,598Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.372,089 95-%-Konfidenzintervall: ±5,132Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlGPT-6 Astra: Arena-Bewertung aus 2.449 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 5.778 veröffentlichten Paarvergleichen. | Höherer Messwert1.301,633 95-%-Konfidenzintervall: ±12,448Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.215,499 95-%-Konfidenzintervall: ±8,709Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 8.636 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 61.071 veröffentlichten Paarvergleichen. | Höherer Messwert1.488,868 95-%-Konfidenzintervall: ±8,374Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.401,523 95-%-Konfidenzintervall: ±3,976Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 1.132 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 7.976 veröffentlichten Paarvergleichen. | Höherer Messwert1.509,902 95-%-Konfidenzintervall: ±17,672Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.427,286 95-%-Konfidenzintervall: ±7,215Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 333 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.379 veröffentlichten Paarvergleichen. | Höherer Messwert1.489,442 95-%-Konfidenzintervall: ±32,984Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,543 95-%-Konfidenzintervall: ±13,786Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 176 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.359 veröffentlichten Paarvergleichen. | Höherer Messwert1.480,596 95-%-Konfidenzintervall: ±44,81Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.407,953 95-%-Konfidenzintervall: ±17,201Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 7.117 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 50.980 veröffentlichten Paarvergleichen. | Höherer Messwert1.502,017 95-%-Konfidenzintervall: ±7,647Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,155 95-%-Konfidenzintervall: ±3,56Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 2.847 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 21.186 veröffentlichten Paarvergleichen. | Höherer Messwert1.505,128 95-%-Konfidenzintervall: ±11,467Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.439,589 95-%-Konfidenzintervall: ±4,785Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 3.666 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 26.939 veröffentlichten Paarvergleichen. | Höherer Messwert1.471,988 95-%-Konfidenzintervall: ±10,084Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.401,72 95-%-Konfidenzintervall: ±4,374Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlJapaneseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 220 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 929 veröffentlichten Paarvergleichen. | Höherer Messwert1.429,026 95-%-Konfidenzintervall: ±42,875Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.379,052 95-%-Konfidenzintervall: ±21,069Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlKoreanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 210 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.428 veröffentlichten Paarvergleichen. | Höherer Messwert1.450,643 95-%-Konfidenzintervall: ±41,535Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.358,651 95-%-Konfidenzintervall: ±17,119Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLegal and governmentTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 1.000 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 6.347 veröffentlichten Paarvergleichen. | Höherer Messwert1.486,122 95-%-Konfidenzintervall: ±18,889Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.420,684 95-%-Konfidenzintervall: ±7,935Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLife, physical and social scienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 1.987 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 13.640 veröffentlichten Paarvergleichen. | Höherer Messwert1.489,3 95-%-Konfidenzintervall: ±13,614Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.428,444 95-%-Konfidenzintervall: ±5,571Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLonger queriesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 4.917 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 31.737 veröffentlichten Paarvergleichen. | Höherer Messwert1.488,357 95-%-Konfidenzintervall: ±9,148Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.417,413 95-%-Konfidenzintervall: ±4,313Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 587 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 4.742 veröffentlichten Paarvergleichen. | Höherer Messwert1.481,638 95-%-Konfidenzintervall: ±23,784Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.400,815 95-%-Konfidenzintervall: ±8,893Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathematical professionsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 664 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 4.407 veröffentlichten Paarvergleichen. | Höherer Messwert1.495,728 95-%-Konfidenzintervall: ±22,879Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.413,768 95-%-Konfidenzintervall: ±9,421Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMedicine and healthcareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 841 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 5.848 veröffentlichten Paarvergleichen. | Höherer Messwert1.469,187 95-%-Konfidenzintervall: ±20,767Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.431,33 95-%-Konfidenzintervall: ±8,313Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMulti-turnTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 1.593 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 14.021 veröffentlichten Paarvergleichen. | Höherer Messwert1.485,974 95-%-Konfidenzintervall: ±15,121Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.420,254 95-%-Konfidenzintervall: ±5,589Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlNon-EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 6.968 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 48.836 veröffentlichten Paarvergleichen. | Höherer Messwert1.463,829 95-%-Konfidenzintervall: ±7,687Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.398,12 95-%-Konfidenzintervall: ±3,514Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlPolishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 159 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.852 veröffentlichten Paarvergleichen. | Höherer Messwert1.454,351 95-%-Konfidenzintervall: ±45,691Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.415,637 95-%-Konfidenzintervall: ±13,929Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlRussianTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 1.542 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 10.065 veröffentlichten Paarvergleichen. | Höherer Messwert1.469,089 95-%-Konfidenzintervall: ±15,197Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.408,261 95-%-Konfidenzintervall: ±6,27Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlSoftware and IT servicesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 4.224 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 31.163 veröffentlichten Paarvergleichen. | Höherer Messwert1.522,269 95-%-Konfidenzintervall: ±9,455Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.456,413 95-%-Konfidenzintervall: ±4,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlSpanishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 345 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.503 veröffentlichten Paarvergleichen. | Höherer Messwert1.443,13 95-%-Konfidenzintervall: ±31,667Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.406,692 95-%-Konfidenzintervall: ±12,904Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlWriting, literature and languageTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Astra: Snapshot: gpt-6-astra-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlGPT-6 Astra: Arena-Bewertung aus 3.276 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 20.857 veröffentlichten Paarvergleichen. | Höherer Messwert1.464,251 95-%-Konfidenzintervall: ±11,022Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.389,216 95-%-Konfidenzintervall: ±4,844Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-6 Astra
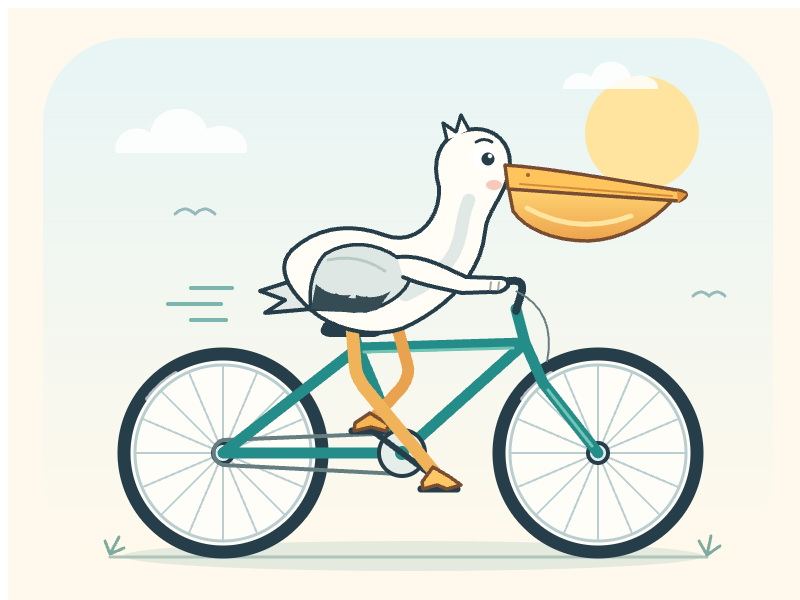
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Mistral Large 3
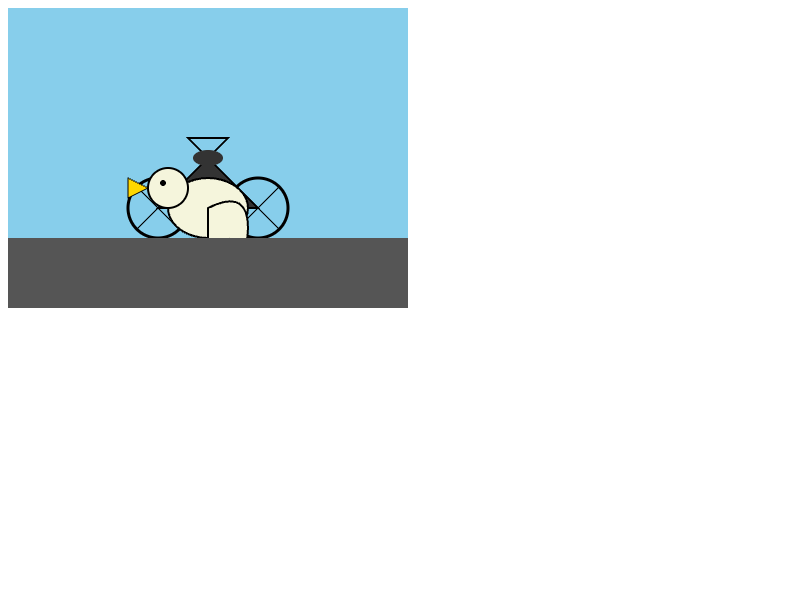
Reasoning (Modellstandard): kein Reasoning-Modus Quelle
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche GPT-6 Astra und Mistral Large 3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.