Qwen 3.8 Max 0902
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Qwen 3.8 Max 0902 | Mistral Large 3 |
|---|---|---|
| Anbieter | Alibaba | Mistral AI |
| Erschienen | 2. Sept. 2026 | 2. Dez. 2025 |
| Verfügbarkeit | API-only | Aktiv |
| Modelltyp | Proprietär | Open Weights |
| Parameter | 2,4 Billionen | 675 Mrd., 41 Mrd. aktiv |
| Architektur | Mixture of Experts | Mixture of Experts |
| Kontextfenster | 1.000.000 Token | 262.144 Token |
| Wissensstand | Nicht veröffentlicht | Nicht veröffentlicht |
| Technische Quellen | Modell | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Qwen 3.8 Max 0902 | Mistral Large 3 |
|---|---|---|
| API-Eingabe | 1,65 $ | 0,5 $ |
| API-Ausgabe | 4,951 $ | 1,5 $ |
| Cache lesen | 0,137 $ | Nicht ausgewiesen |
| Cache schreiben (5 Min.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Qwen 3.8 Max 0902 | Alibaba | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 1,65 $ | Günstigster erfasster Preis: 4,951 $ | Quelle22.09.2026 |
| Alibaba | Über OpenRouteralibaba | 2 $ | 6 $ | Quelle18.10.2026 | |
| Alibaba | Über OpenRouteralibaba/us-east-1 | 2 $ | 6 $ | Quelle18.10.2026 | |
| Mistral Large 3 | Mistral AI | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle22.09.2026 |
| Mistral | Über OpenRoutermistral/eu | 0,55 $ | 1,65 $ | Quelle18.10.2026 | |
| Mistral | Über OpenRoutermistral/zdr | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle18.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 2 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Qwen 3.8 Max 0902 | Mistral Large 3 | Quelle |
|---|---|---|---|
CorpFin v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert65,851 % | 61,033 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
GPQA DiamondOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,686 % | 68,434 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert83,609 % | 79,138 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert87,852 % | 55,337 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserQwen 3.8 Max 0902: Snapshot: qwen3.8-max-0902, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevQwen 3.8 Max 0902: Arena-Bewertung aus 13.081 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Gewinner1.673,151 95-%-Konfidenzintervall: ±7,241Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,602 % | 79,823 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMMU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,035 % | 66,185 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert63,99 % | 52,106 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Gewinner51,254 % | 24,595 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SWE-bench VerifiedOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert85,6 % | 41,4 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
TaxEval v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert75,552 % | 73,058 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
CorpFin v2Exact PagesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert64,569 % | 59,79 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
GPQA DiamondFew-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,424 % | 64,141 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchConclusion TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,23 % | 81,032 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert99,068 % | 95,342 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserQwen 3.8 Max 0902: Snapshot: qwen3.8-max-0902, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevQwen 3.8 Max 0902: Arena-Bewertung aus 1.164 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.413 veröffentlichten Paarvergleichen. | Gewinner1.637,891 95-%-Konfidenzintervall: ±18,343Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.361,78 95-%-Konfidenzintervall: ±17,387Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBiologyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert94,142 % | 88,563 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxNumerical ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert72,258 % | 50 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEAutomataTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Gewinner39,682 % | 11,905 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SWE-bench Verified<15 min fixTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,299 % | 56,186 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
TaxEval v2CorrectnessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert64,105 % | 61,57 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
CorpFin v2Max Fitting ContextTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert65,618 % | 63,753 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
GPQA DiamondZero-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert94,949 % | 72,727 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchInterpretation TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert84,061 % | 76,594 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6HardTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert75,714 % | 17,143 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevWebdevTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserQwen 3.8 Max 0902: Snapshot: qwen3.8-max-0902, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevQwen 3.8 Max 0902: Arena-Bewertung aus 13.081 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Gewinner1.673,151 95-%-Konfidenzintervall: ±7,241Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProBusinessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,902 % | 84,664 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxSemantic ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert55,723 % | 54,213 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGECalculusTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Gewinner71,914 % | 0 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SWE-bench Verified>4 hoursTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert66,667 % | 33,333 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
TaxEval v2Stepwise ReasoningTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert86,999 % | 84,546 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
CorpFin v2Shared Max ContextTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert67,366 % | 59,557 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
LegalBenchIssue TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,635 % | 81,006 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6MediumTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,773 % | 53,525 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserQwen 3.8 Max 0902: Snapshot: qwen3.8-max-0902, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevQwen 3.8 Max 0902: Arena-Bewertung aus 2.257 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Gewinner1.651,307 95-%-Konfidenzintervall: ±14,717Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.238,427 95-%-Konfidenzintervall: ±26,132Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProChemistryTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,491 % | 84,982 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGELinear AlgebraTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Gewinner69,636 % | 44,419 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SWE-bench Verified1-4 hoursTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert64,286 % | 4,762 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchRhetoric TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert79,047 % | 77,926 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProComputer ScienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,976 % | 83,171 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEPartial Differential EquationsTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Gewinner44,444 % | 17,46 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SWE-bench Verified15 min - 1 hourTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert83,525 % | 36,398 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchRule TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | 76,071 % | Höherer Messwert79,13 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProEconomicsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert89,929 % | 85,782 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProEngineeringTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert86,687 % | 74,923 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProHealthTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert83,985 % | 77,262 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProHistoryTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert81,102 % | 70,866 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProLawTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert77,293 % | 56,403 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert95,485 % | 88,379 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProOthersTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert85,281 % | 79,221 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProPhilosophyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,377 % | 76,353 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProPhysicsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,303 % | 86,374 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMLU-ProPsychologyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserQwen 3.8 Max 0902: Temperatur: 0.7, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,471 % | 80,576 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.
Community-Klassiker für eine freie SVG-Zeichnung.
Qwen 3.8 Max 0902
Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Mistral Large 3
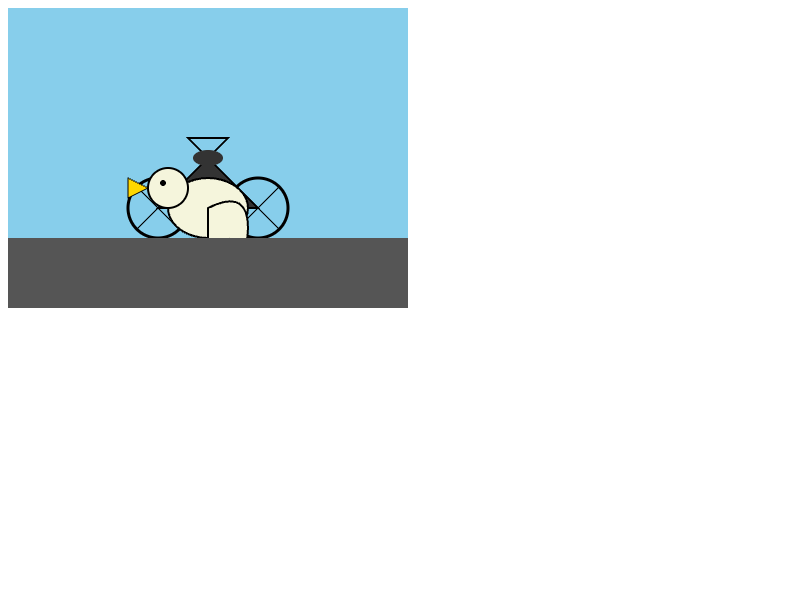
Reasoning (Modellstandard): kein Reasoning-Modus Quelle
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Qwen 3.8 Max 0902 und Mistral Large 3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.