Zum Hauptinhalt springen

OpenAIBildmodellVeraltet

GPT Image 1.5

GPT Image 1.5 liegt in der Arena-Wertung auf Platz 13 von 21, in unserem Test GraduallyBench auf Platz 29 von 108.

Arena-WertungPlatz 13 von 21

1.236Stimmen von Nutzernhöher ist besser

GraduallyBenchPlatz 29 von 108

68eigene Bewertung0 bis 100

PreisPlatz 24 von 28

0,13 $je Bildniedriger ist besser

BeliebtheitPlatz 575 von 875

22von 100wie im Vormonat

Zusammenfassung

Mit 0,13 $ je Bild ist es teuer, ein typisches Bildmodell kostet 0,06 $.

GPT Image 1.5 war OpenAIs separater API-Checkpoint von Dezember 2025 mit bis zu 1.536 × 1.024 Pixeln und einer High-Konfiguration. Als eigenes Generatorprofil bleibt es von GPT Image 2 getrennt.

OpenAI hat das Modell als veraltet markiert und die API-Abschaltung für den 1. Dezember 2026 angekündigt. In der aktuellen Deprecations-Dokumentation nennt OpenAI GPT Image 2.5 Sunburst oder GPT Image 2.5 Flare als Migrationsziele.

Bildbeispiele aus unseren Tests

Diese Bilder stammen aus dokumentierten Einzelanfragen mit archiviertem Prompt. Sie ergänzen die Messwerte, ersetzen aber keinen kontrollierten Labortest.

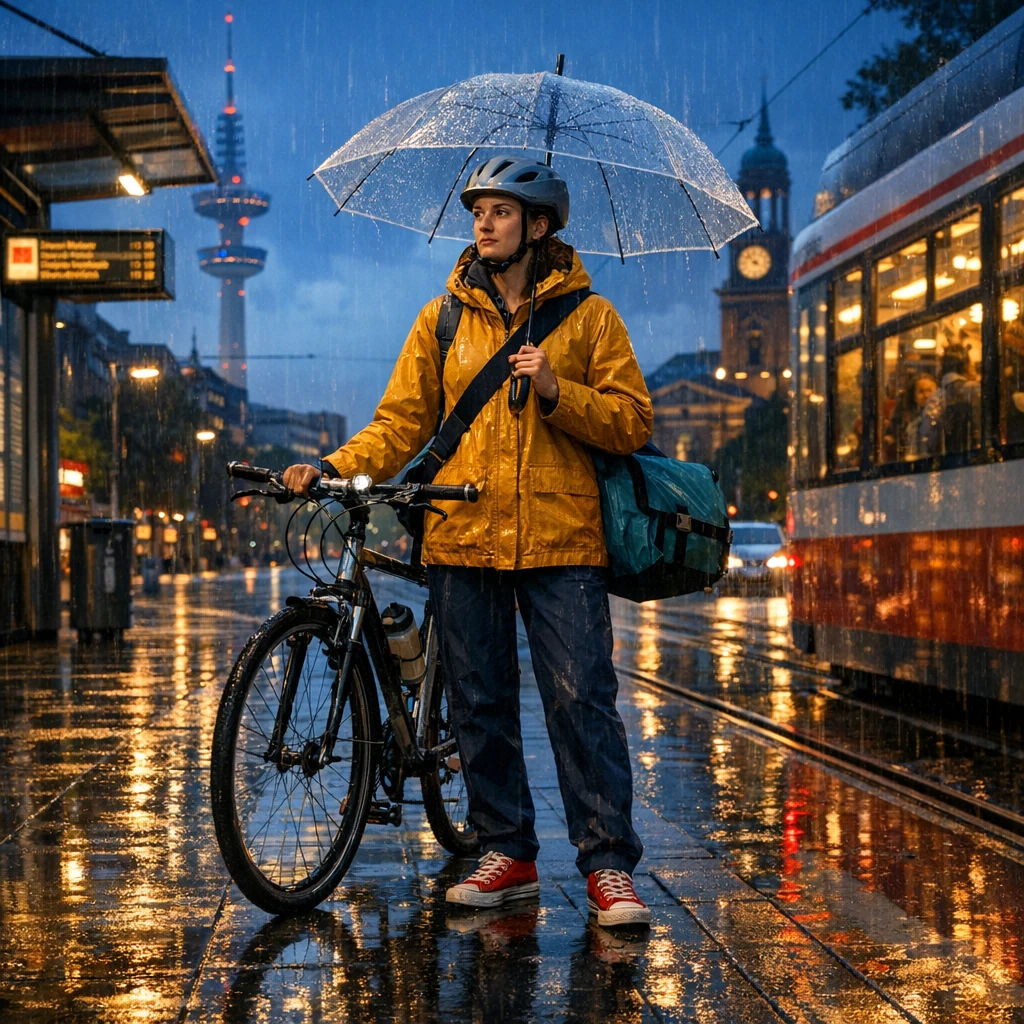
Figur und DetailsFigur und Details in Originalgröße öffnen

Figur und Details

Das Beispiel prüft Anatomie, Kleidung und räumliche Konsistenz.

Prompt und Einstellungen

Create a square cinematic full-body portrait of a fictional bicycle courier waiting under a transparent umbrella at a rainy tram stop in Hamburg at blue hour. She wears a mustard raincoat, navy trousers, red sneakers, a silver helmet, and carries a teal messenger bag. Keep both hands visible, render the bicycle correctly, use realistic wet-street reflections, and include no readable brand names.

Erzeugt über together mit der Modellkennung openai/gpt-image-1.5. Archivierte Einstellungen waren 1024x1024, n=1, seed=provider random, provider default steps.

Quelle öffnen
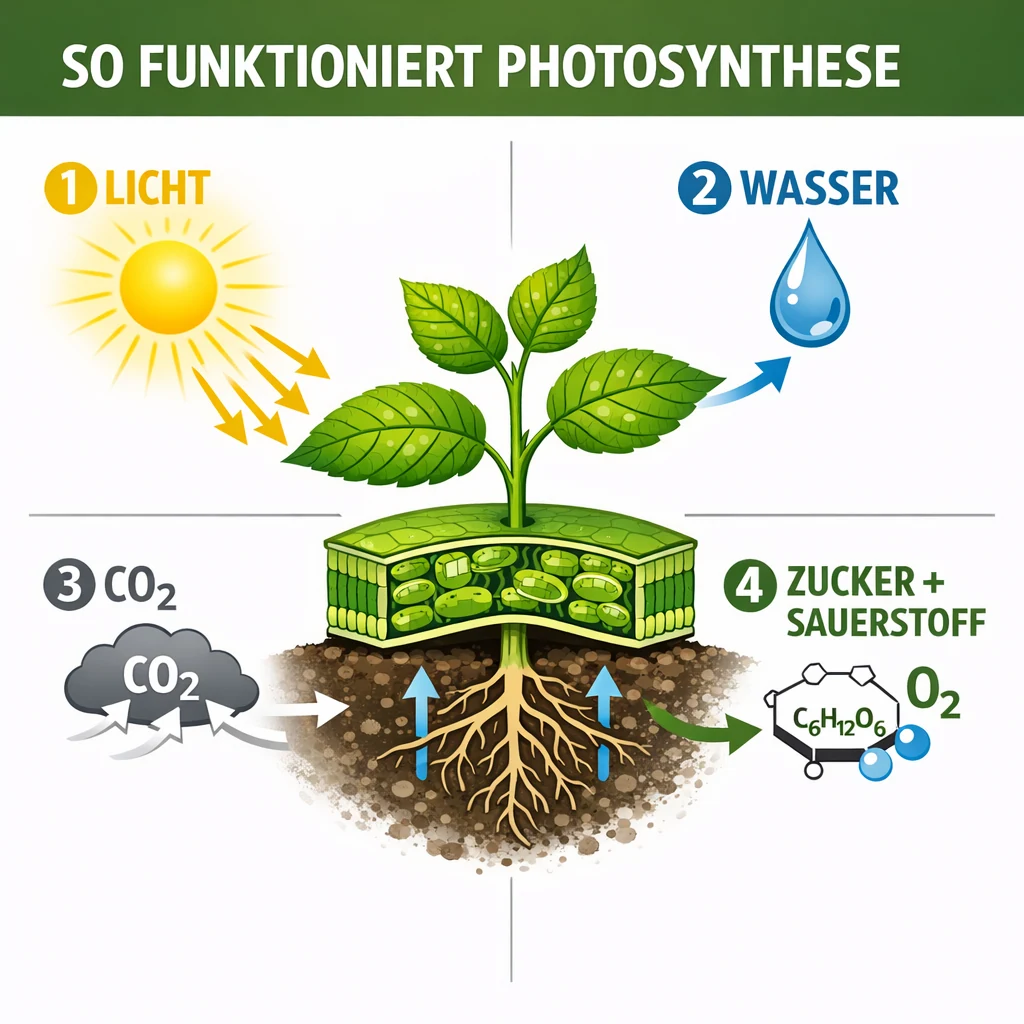
InfografikInfografik in Originalgröße öffnen

Infografik

Das Beispiel prüft Zahlen, Beschriftungen und visuelle Ordnung.

Prompt und Einstellungen

Create a square German infographic titled SO FUNKTIONIERT PHOTOSYNTHESE. Show exactly four numbered steps in this order: 1 LICHT, 2 WASSER, 3 CO₂, 4 ZUCKER + SAUERSTOFF. Use a clean editorial science style with one plant cross-section, simple arrows, high contrast, legible labels, and no other text.

Erzeugt über together mit der Modellkennung openai/gpt-image-1.5. Archivierte Einstellungen waren 1024x1024, n=1, seed=provider random, provider default steps.

Quelle öffnen
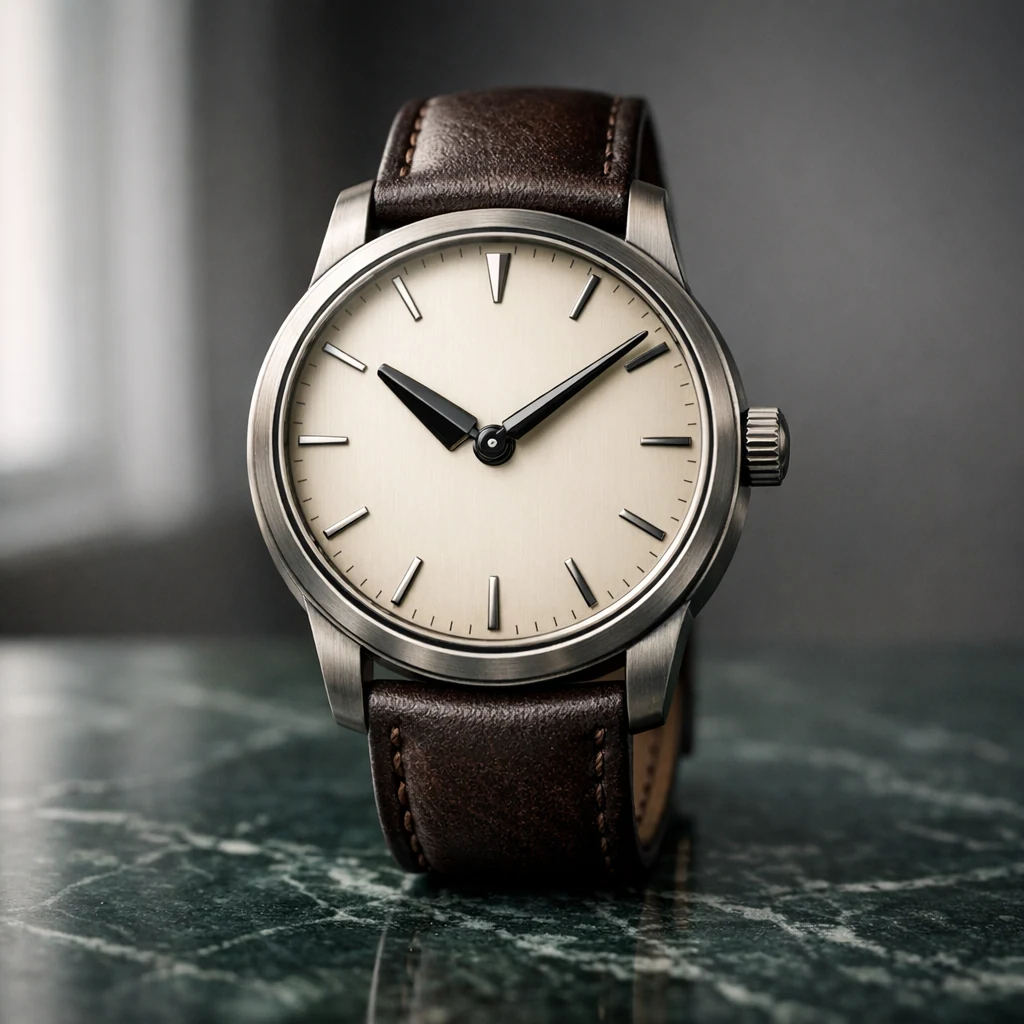
ProduktfotografieProduktfotografie in Originalgröße öffnen

Produktfotografie

Das Beispiel prüft Materialien, Reflexionen und kleine Details.

Prompt und Einstellungen

Create a square premium product photograph of a brushed titanium wristwatch standing upright on dark green marble. The watch has a cream dial, thin black hands set to 10:10, twelve distinct hour markers, a realistic crown, and a dark brown leather strap. Soft window light from the left, controlled reflections, shallow depth of field, no text, no logo, no extra objects.

Erzeugt über together mit der Modellkennung openai/gpt-image-1.5. Archivierte Einstellungen waren 1024x1024, n=1, seed=provider random, provider default steps.

Quelle öffnen
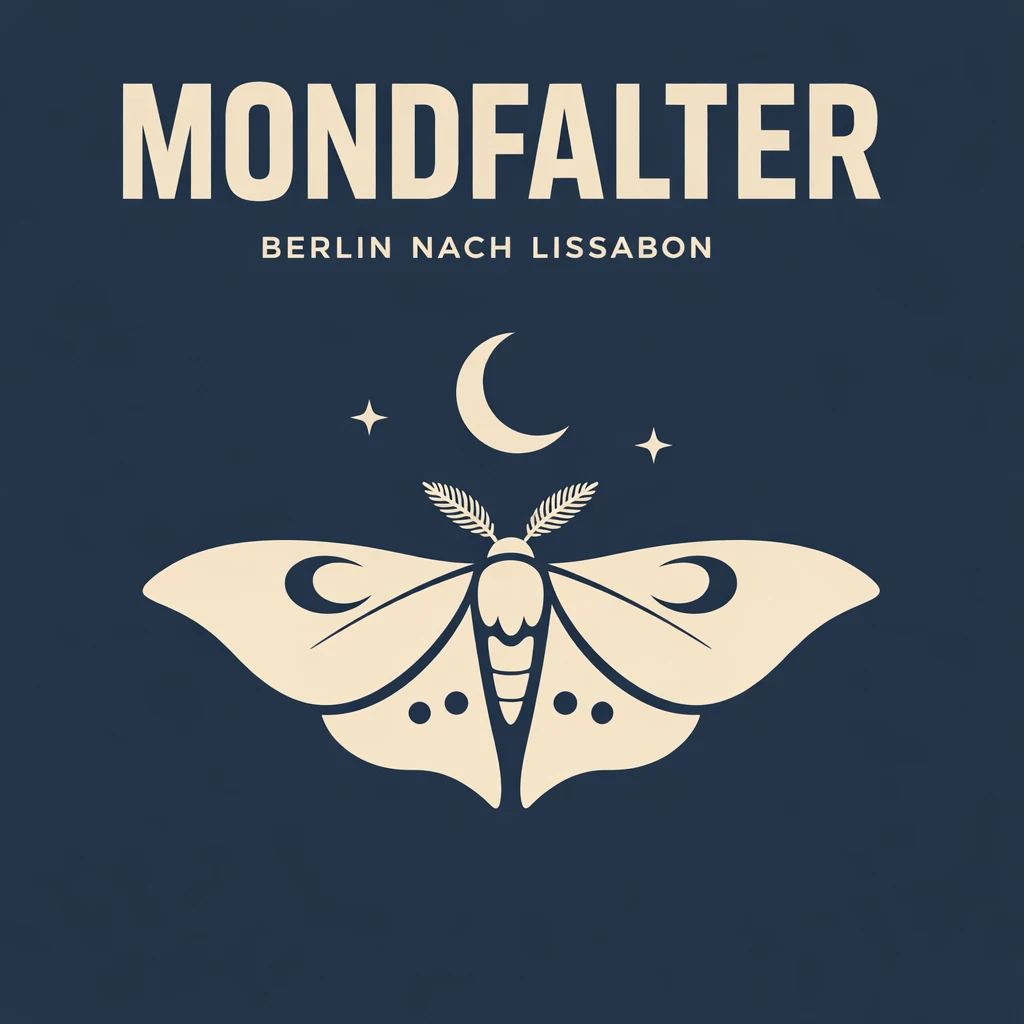
Typografie und LayoutTypografie und Layout in Originalgröße öffnen

Typografie und Layout

Das Beispiel prüft Lesbarer Text, Hierarchie und Komposition.

Prompt und Einstellungen

Create a square editorial poster for an imaginary night train called MONDFALTER. Show the exact German headline MONDFALTER and the exact subline BERLIN NACH LISSABON. Use a restrained midnight-blue and warm-cream palette, one stylized moth, strong Swiss-grid typography, generous negative space, and no additional words or logos.

Erzeugt über together mit der Modellkennung openai/gpt-image-1.5. Archivierte Einstellungen waren 1024x1024, n=1, seed=provider random, provider default steps.

Quelle öffnen

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 204 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 17

Veröffentlichte Benchmarks

Text zu Bild

Text to Image Arena

Elo-Werte fassen Paarvergleiche innerhalb dieser Vergleichstabelle zusammen. Sie sind keine Prozentwerte. Die Skala erlaubt keine Aussage über absolute Qualität oder lineare Abstände zwischen Modellen.

GPT Image 21.187,61 Elo
MAI-Image-2.61.168,32 Elo
Nano Banana 21.141,6 Elo
Muse Image1.127,86 Elo
GPT Image 1.51.123,86 Elo
MAI-Image-2.51.120,06 Elo
Nano Banana Pro1.118,67 Elo
Nano Banana 2 Lite1.109,07 Elo
Seedream 5.0 Pro1.101,17 Elo
Qwen-Image-2.11.045,48 Elo
Krea 2 Large1.035,45 Elo
Qwen Image 2.0 Pro1.031,23 Elo
FLUX.2 Flex1.027,68 Elo
FLUX.2 Max1.020,57 Elo
Ideogram 4.51.015,99 Elo
FLUX.2 Pro1.003,17 Elo
Ideogram 4.01.002,93 Elo
FLUX.2 Klein 9B932,08 Elo

höhere Werte sind besserStand 6. November 2026Skala: 0 Elo - 1.227,25 Elo

Quelle: Artificial Analysis
gradually.ai
Methodik und Einordnung
Messgröße
elo-rating
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
30
Methodik und Einordnung
AA-Auftritte: 13104. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 8. Oberer Rang: 14. Kennung des Quellmodells: a1ee4d6f-d136-434b-bb1d-066fe5f9bf6f. Kennung der Evidenzaufnahme: aa-image-text-to-image-v2.1-2026-11-06-e430d57b5d0b. Prüfsumme der Quelldaten: e430d57b5d0bf260d6feb60bb7d8fa32da8d7961ec2bd9a9cae58fb015613cf0
Quelle: Artificial Analysis

LMArena Text to Image: 3D modeling

GPT Image 2.5 Sunburst1.412,39 Punkte
GPT Image 2.5 Flare1.381,8 Punkte
GPT Image 21.365,33 Punkte
MAI-Image-2.61.323,82 Punkte
Grok Imagine Image 2.01.291,41 Punkte
Reve 2.11.281,14 Punkte
Nano Banana 21.255,68 Punkte
MAI-Image-2.51.251,47 Punkte
Seedream 5.0 Pro1.246,55 Punkte
Muse Image1.238,45 Punkte
Nano Banana Pro1.232,1 Punkte
Nano Banana 2 Lite1.225,65 Punkte
GPT Image 1.51.217,68 Punkte
Qwen-Image-2.11.213,88 Punkte
FLUX.2 Flex1.173,15 Punkte
FLUX.2 Max1.160,58 Punkte
FLUX.2 Pro1.145,47 Punkte
HiDream-O1-Image1.120,68 Punkte
Krea 2 Large1.115,65 Punkte
FLUX.2 Klein 9B1.078,61 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.412,39 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
17.591
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Agentic image generation

GPT Image 2.5 Sunburst1.393,27 Punkte
GPT Image 2.5 Flare1.362,55 Punkte
GPT Image 21.337,71 Punkte
MAI-Image-2.61.316,28 Punkte
Grok Imagine Image 2.01.287,47 Punkte
Nano Banana 21.257,08 Punkte
Seedream 5.0 Pro1.240,85 Punkte
GPT Image 1.51.237,12 Punkte
Nano Banana Pro1.236,88 Punkte
Muse Image1.234,77 Punkte
Qwen-Image-2.11.231,48 Punkte
Krea 2 Large1.140,86 Punkte
FLUX.2 Pro1.137,07 Punkte
HiDream-O1-Image1.110,87 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.393,27 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
14
Stichprobe
1.213
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Art

GPT Image 2.5 Sunburst1.410,08 Punkte
GPT Image 2.5 Flare1.387,35 Punkte
GPT Image 21.370,68 Punkte
MAI-Image-2.61.337,7 Punkte
Grok Imagine Image 2.01.328,25 Punkte
Reve 2.11.290,77 Punkte
MAI-Image-2.51.276,76 Punkte
Seedream 5.0 Pro1.258,85 Punkte
Muse Image1.258,79 Punkte
Nano Banana 2 Lite1.255,8 Punkte
Nano Banana 21.239,62 Punkte
Qwen-Image-2.11.234,74 Punkte
GPT Image 1.51.224,81 Punkte
Nano Banana Pro1.224,23 Punkte
FLUX.2 Max1.168,74 Punkte
FLUX.2 Pro1.159,34 Punkte
FLUX.2 Flex1.155,3 Punkte
Krea 2 Large1.122,19 Punkte
HiDream-O1-Image1.116,78 Punkte
FLUX.2 Klein 9B1.078,63 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.410,08 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
24.647
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Cartoon

GPT Image 2.5 Sunburst1.456,88 Punkte
GPT Image 2.5 Flare1.427,12 Punkte
GPT Image 21.402,93 Punkte
Grok Imagine Image 2.01.352,36 Punkte
MAI-Image-2.61.348,71 Punkte
Reve 2.11.309,78 Punkte
Muse Image1.274,79 Punkte
MAI-Image-2.51.268,65 Punkte
Seedream 5.0 Pro1.263,52 Punkte
Nano Banana 21.260,23 Punkte
Nano Banana 2 Lite1.256,09 Punkte
GPT Image 1.51.243,95 Punkte
Nano Banana Pro1.243,91 Punkte
Qwen-Image-2.11.234,48 Punkte
FLUX.2 Max1.167,57 Punkte
FLUX.2 Flex1.163,29 Punkte
FLUX.2 Pro1.158,62 Punkte
Krea 2 Large1.118,81 Punkte
HiDream-O1-Image1.118,12 Punkte
FLUX.2 Klein 9B1.063,58 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.456,88 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
67.289
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Commercial design

GPT Image 2.5 Sunburst1.415,51 Punkte
GPT Image 21.385,8 Punkte
GPT Image 2.5 Flare1.384,8 Punkte
MAI-Image-2.61.332,9 Punkte
Grok Imagine Image 2.01.324,96 Punkte
Reve 2.11.315,65 Punkte
Nano Banana 21.267,93 Punkte
MAI-Image-2.51.259,36 Punkte
Muse Image1.258,15 Punkte
Nano Banana 2 Lite1.248,4 Punkte
Nano Banana Pro1.245,44 Punkte
GPT Image 1.51.237,88 Punkte
Qwen-Image-2.11.237,36 Punkte
Seedream 5.0 Pro1.236,31 Punkte
FLUX.2 Flex1.172,44 Punkte
FLUX.2 Max1.163,75 Punkte
FLUX.2 Pro1.154,5 Punkte
HiDream-O1-Image1.129,54 Punkte
Krea 2 Large1.110,71 Punkte
FLUX.2 Klein 9B1.070,2 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.415,51 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
66.218
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Overall

GPT Image 2.5 Sunburst1.427,13 Punkte
GPT Image 2.5 Flare1.399,44 Punkte
GPT Image 21.382,1 Punkte
MAI-Image-2.61.330,58 Punkte
Grok Imagine Image 2.01.317,31 Punkte
Reve 2.11.300,4 Punkte
Muse Image1.268,12 Punkte
Nano Banana 21.257,49 Punkte
MAI-Image-2.51.253 Punkte
Seedream 5.0 Pro1.250,8 Punkte
Nano Banana 2 Lite1.249,44 Punkte
Nano Banana Pro1.246,31 Punkte
GPT Image 1.51.236,39 Punkte
Qwen-Image-2.11.226,55 Punkte
FLUX.2 Max1.161,46 Punkte
FLUX.2 Flex1.156,26 Punkte
FLUX.2 Pro1.152,68 Punkte
Krea 2 Large1.115,37 Punkte
HiDream-O1-Image1.114,71 Punkte
FLUX.2 Klein 9B1.069,84 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.427,13 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
173.798
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Photorealism

GPT Image 2.5 Flare1.415,95 Punkte
GPT Image 21.379,13 Punkte
MAI-Image-2.61.330,88 Punkte
Grok Imagine Image 2.01.312,19 Punkte
Reve 2.11.302,1 Punkte
Muse Image1.278,09 Punkte
Seedream 5.0 Pro1.274,42 Punkte
Nano Banana 21.261,31 Punkte
Nano Banana Pro1.260,39 Punkte
Nano Banana 2 Lite1.258,64 Punkte
MAI-Image-2.51.250,67 Punkte
GPT Image 1.51.246,79 Punkte
Qwen-Image-2.11.229,66 Punkte
FLUX.2 Max1.160,87 Punkte
FLUX.2 Pro1.151,76 Punkte
FLUX.2 Flex1.145,47 Punkte
Krea 2 Large1.128,88 Punkte
HiDream-O1-Image1.109,06 Punkte
FLUX.2 Klein 9B1.091,05 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.434,4 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
68.908
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Portraits

GPT Image 2.5 Sunburst1.461,22 Punkte
GPT Image 2.5 Flare1.439,29 Punkte
GPT Image 21.426,27 Punkte
MAI-Image-2.61.341,91 Punkte
Grok Imagine Image 2.01.332,04 Punkte
Reve 2.11.316,59 Punkte
Muse Image1.289,88 Punkte
Seedream 5.0 Pro1.286,94 Punkte
GPT Image 1.51.258,96 Punkte
Qwen-Image-2.11.256,2 Punkte
Nano Banana Pro1.255,64 Punkte
Nano Banana 21.254,9 Punkte
MAI-Image-2.51.254,78 Punkte
Nano Banana 2 Lite1.244,1 Punkte
FLUX.2 Max1.156,6 Punkte
FLUX.2 Pro1.144,32 Punkte
FLUX.2 Flex1.143,85 Punkte
Krea 2 Large1.123,58 Punkte
HiDream-O1-Image1.105,31 Punkte
FLUX.2 Klein 9B1.091,81 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.461,22 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
33.613
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

LMArena Text to Image: Text rendering

GPT Image 2.5 Sunburst1.461,65 Punkte
GPT Image 2.5 Flare1.431,87 Punkte
GPT Image 21.424,21 Punkte
MAI-Image-2.61.365,86 Punkte
Grok Imagine Image 2.01.349,22 Punkte
Reve 2.11.339,46 Punkte
Nano Banana 21.294,44 Punkte
Muse Image1.293,25 Punkte
MAI-Image-2.51.280,73 Punkte
Nano Banana 2 Lite1.273,63 Punkte
Nano Banana Pro1.270,33 Punkte
Seedream 5.0 Pro1.254,93 Punkte
GPT Image 1.51.251,47 Punkte
Qwen-Image-2.11.250,12 Punkte
FLUX.2 Flex1.171,57 Punkte
FLUX.2 Max1.165,6 Punkte
FLUX.2 Pro1.154,35 Punkte
HiDream-O1-Image1.134,31 Punkte
Krea 2 Large1.116,42 Punkte
FLUX.2 Klein 9B1.057,76 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.461,65 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
21
Stichprobe
61.628
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle: LMArena

Bildbearbeitung

Image Editing Arena

Elo-Werte fassen Paarvergleiche innerhalb dieser Vergleichstabelle zusammen. Sie sind keine Prozentwerte. Die Skala erlaubt keine Aussage über absolute Qualität oder lineare Abstände zwischen Modellen.

MAI-Image-2.61.149,25 Elo
GPT Image 21.135,9 Elo
Seedream 5.0 Pro1.129,43 Elo
Muse Image1.128,02 Elo
Nano Banana 21.125,1 Elo
MAI-Image-2.51.124,35 Elo
GPT Image 1.51.116,41 Elo
Nano Banana Pro1.108,99 Elo
Qwen-Image-2.11.080,38 Elo
Ideogram 4.51.066,78 Elo
Qwen Image 2.0 Pro1.056,78 Elo
Nano Banana 2 Lite1.053,63 Elo
FLUX.2 Klein 9B1.012,79 Elo
FLUX.2 Pro1.011,07 Elo
FLUX.2 Max998,84 Elo
FLUX.2 Flex995,52 Elo

höhere Werte sind besserStand 6. November 2026Skala: 0 Elo - 1.199,46 Elo

Quelle: Artificial Analysis
gradually.ai
Methodik und Einordnung
Messgröße
elo-rating
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
24
Methodik und Einordnung
AA-Auftritte: 13822. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 12. Oberer Rang: 18. Kennung des Quellmodells: a1ee4d6f-d136-434b-bb1d-066fe5f9bf6f. Kennung der Evidenzaufnahme: aa-image-image-editing-v2.1-2026-11-06-0a4f79bb0933. Prüfsumme der Quelldaten: 0a4f79bb0933c8ef52ce1327ef382eb3442dab864e254d37ecd3176d39727555
Quelle: Artificial Analysis

LMArena Image Editing: Agentic image generation

GPT Image 2.5 Sunburst1.536,61 Punkte
GPT Image 2.5 Flare1.491,71 Punkte
GPT Image 21.459,51 Punkte
Grok Imagine Image 2.01.426,01 Punkte
MAI-Image-2.61.417,96 Punkte
Seedream 5.0 Pro1.409,2 Punkte
Nano Banana Pro1.404,88 Punkte
Muse Image1.382,3 Punkte
Nano Banana 21.376,8 Punkte
Qwen-Image-2.11.362,02 Punkte
GPT Image 1.51.360,14 Punkte
Ideogram 4.51.298,95 Punkte
FLUX.2 Pro1.212,35 Punkte

höhere Werte sind besserStand 6. November 2026Skala: 0 Punkte - 1.536,61 Punkte

Quelle: LMArena
gradually.ai
Methodik und Einordnung
Messgröße
arena-score
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
13
Stichprobe
4.876
Methodik und Einordnung
Kennung der Evidenzaufnahme: lmarena-image_edit-5a7e6bb84a93f55df56b198be8e56e53755a216a-4db53937a0d3. Prüfsumme der Quelldaten: 4db53937a0d39e716e49e4c3fb1b88c68578a094c4339bb7c714dbedfd0a85d0
Quelle: LMArena

Dokumentierte Messdetails

Text to Image Arena (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1123.86
Bewertung
1123.86
Messgröße
elo-rating
Einheit
Elo
Benchmark-Version
v2.1
Richtung
Mehr ist besser
Quellenrang
9
Konfidenzintervall
11
Untere Konfidenzgrenze
1112.86
Obere Konfidenzgrenze
1134.86
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Abrufdatum
2026-11-06
Methodik
AA-Auftritte: 13104. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 8. Oberer Rang: 14. Kennung des Quellmodells: a1ee4d6f-d136-434b-bb1d-066fe5f9bf6f. Kennung der Evidenzaufnahme: aa-image-text-to-image-v2.1-2026-11-06-e430d57b5d0b. Prüfsumme der Quelldaten: e430d57b5d0bf260d6feb60bb7d8fa32da8d7961ec2bd9a9cae58fb015613cf0
Preis pro 1.000 Token in USD
133
Quelle Artificial Analysis
Image Editing Arena (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1116.41
Bewertung
1116.41
Messgröße
elo-rating
Einheit
Elo
Benchmark-Version
v2.1
Richtung
Mehr ist besser
Quellenrang
16
Konfidenzintervall
12
Untere Konfidenzgrenze
1104.41
Obere Konfidenzgrenze
1128.41
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Abrufdatum
2026-11-06
Methodik
AA-Auftritte: 13822. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 12. Oberer Rang: 18. Kennung des Quellmodells: a1ee4d6f-d136-434b-bb1d-066fe5f9bf6f. Kennung der Evidenzaufnahme: aa-image-image-editing-v2.1-2026-11-06-0a4f79bb0933. Prüfsumme der Quelldaten: 0a4f79bb0933c8ef52ce1327ef382eb3442dab864e254d37ecd3176d39727555
Preis pro 1.000 Token in USD
133
Quelle Artificial Analysis
LMArena Text to Image: 3D modeling (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1217.6797267364418
Bewertung
1217.6797267364418
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
19
Stichprobe
17591
Konfidenzintervall
6.296062
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Agentic image generation (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1237.123664434062
Bewertung
1237.123664434062
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
10
Stichprobe
1213
Konfidenzintervall
20.108002
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Art (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1224.8148823318024
Bewertung
1224.8148823318024
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
19
Stichprobe
24647
Konfidenzintervall
5.629238
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Cartoon (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1243.9490650323892
Bewertung
1243.9490650323892
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
18
Stichprobe
67289
Konfidenzintervall
4.470831
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Commercial design (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1237.8758507374232
Bewertung
1237.8758507374232
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
18
Stichprobe
66218
Konfidenzintervall
4.374012
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1236.3922626694784
Bewertung
1236.3922626694784
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
19
Stichprobe
173798
Konfidenzintervall
3.015001
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Photorealism (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1246.7893933767884
Bewertung
1246.7893933767884
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
19
Stichprobe
68908
Konfidenzintervall
4.426955
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Portraits (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1258.9601001657136
Bewertung
1258.9601001657136
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
15
Stichprobe
33613
Konfidenzintervall
5.510292
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Text to Image: Text rendering (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1251.474552203854
Bewertung
1251.474552203854
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
20
Stichprobe
61628
Konfidenzintervall
4.591292
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-text_to_image-5a7e6bb84a93f55df56b198be8e56e53755a216a-43df833a690f. Prüfsumme der Quelldaten: 43df833a690f9454a344fb4d803c0c2ec845d592681e7f95e9ac50f1c0b25d4a
Quelle LMArena
LMArena Image Editing: Agentic image generation (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1360.1413476865862
Bewertung
1360.1413476865862
Messgröße
arena-score
Einheit
score
Richtung
Mehr ist besser
Quellenrang
14
Stichprobe
4876
Konfidenzintervall
11.905772
Quellentyp
official-leaderboard
Auswertung
LMArena
Abrufdatum
2026-11-06
Methodik
Kennung der Evidenzaufnahme: lmarena-image_edit-5a7e6bb84a93f55df56b198be8e56e53755a216a-4db53937a0d3. Prüfsumme der Quelldaten: 4db53937a0d39e716e49e4c3fb1b88c68578a094c4339bb7c714dbedfd0a85d0
Quelle LMArena

Seite 1 von 17

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 100 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 5. November 2026

GPT Image 1.5Midjourney V8.2Luma Uni-1.1 MaxRecraft V4.1 UtilityGrok Imagine Image 2.0

GPT Image 1.5 im Vergleich

Mit anderem Modell vergleichen

Die beliebtesten Vergleiche

  1. 1GPT Image 1.5 vs. FLUX.2 Flex
  2. 2GPT Image 2.5 Sunburst vs. GPT Image 1.5
  3. 3Reve 2.1 vs. GPT Image 1.5
  4. 4Nano Banana 2 vs. GPT Image 1.5
  5. 5Midjourney V8.2 vs. GPT Image 1.5
  6. 6GPT Image 1.5 vs. MAI-Image-2.5
  7. 7GPT Image 1.5 vs. Nano Banana Pro
  8. 8GPT Image 1.5 vs. Nano Banana 2 Lite
  9. 9GPT Image 1.5 vs. Seedream 5.0 Pro
Alle 107 Vergleiche zeigen
  1. 10GPT Image 1.5 vs. Grok Imagine Image Quality
  2. 11GPT Image 1.5 vs. FLUX.2 Max
  3. 12GPT Image 1.5 vs. Qwen Image 2.0 Pro
  4. 13GPT Image 1.5 vs. MAI-Image-2.5 Flash
  5. 14GPT Image 1.5 vs. HiDream-O1-Image-1.5
  6. 15GPT Image 1.5 vs. Krea 2 Medium Turbo
  7. 16GPT Image 1.5 vs. Seedream 4.0
  8. 17GPT Image 1.5 vs. Krea 2 Large
  9. 18GPT Image 1.5 vs. Luma Uni-1.1 Max
  10. 19GPT Image 1.5 vs. Recraft V4.1 Utility
  11. 20GPT Image 1.5 vs. Ideogram 4.0
  12. 21GPT Image 1.5 vs. Wan 2.6 Text to Image
  13. 22GPT Image 1.5 vs. FLUX.2 Pro
  14. 23GPT Image 1.5 vs. HunyuanImage 3.0 Instruct
  15. 24GPT Image 1.5 vs. FLUX.2 Klein 9B
  16. 25GPT Image 1.5 vs. HiDream-O1-Image
  17. 26GPT Image 1.5 vs. Firefly Image Model 5
  18. 27GPT Image 1.5 vs. Midjourney V8.1
  19. 28GPT Image 1.5 vs. Stable Diffusion 3.5 Large
  20. 29GPT Image 1.5 vs. GPT Image 2.5 Flare
  21. 30GPT Image 1.5 vs. Qwen-Image-2.1
  22. 31GPT Image 1.5 vs. MAI-Image-2.6
  23. 32GPT Image 1.5 vs. MAI-Image-2.6 Flash
  24. 33GPT Image 1.5 vs. Muse Image
  25. 34GPT Image 1.5 vs. Grok Imagine Image 2.0
  26. 35GPT Image 1.5 vs. FLUX 3 Image
  27. 36GPT Image 1.5 vs. FLUX 3 Image Klein
  28. 37GPT Image 1.5 vs. Nano Banana 2.1
  29. 38GPT Image 1.5 vs. Ideogram 4.5
  30. 39GPT Image 1.5 vs. Hy Image 3.5 Preview
  31. 40GPT Image 1.5 vs. Recraft V4.1
  32. 41GPT Image 1.5 vs. Recraft V4.1 Flash
  33. 42GPT Image 1.5 vs. Bria FIBO 2
  34. 43GPT Image 1.5 vs. Krea 3
  35. 44GPT Image 1.5 vs. Qwen Image 3.0 Pro
  36. 45GPT Image 1.5 vs. Qwen Image 3.0
  37. 46GPT Image 1.5 vs. Qwen Image 2.1 Pro
  38. 47GPT Image 1.5 vs. Qwen Image 2.1 Turbo
  39. 48GPT Image 1.5 vs. Wan 2.7 Image Pro
  40. 49GPT Image 1.5 vs. Wan 2.7 Image
  41. 50GPT Image 1.5 vs. Seedream 5.0 Flash
  42. 51GPT Image 1.5 vs. SenseNova U1.5 Lite
  43. 52GPT Image 1.5 vs. Kling Image 3.0
  44. 53GPT Image 1.5 vs. Kling Image 3.0 Omni
  45. 54GPT Image 1.5 vs. Vidu Q2 Image
  46. 55GPT Image 1.5 vs. GLM-Image
  47. 56GPT Image 1.5 vs. MiniMax Image-01
  48. 57GPT Image 1.5 vs. Z-Image Turbo
  49. 58GPT Image 1.5 vs. Luma Uni-1.1
  50. 59GPT Image 1.5 vs. Runway Gen-4 Image
  51. 60GPT Image 1.5 vs. Adobe Firefly Image 3
  52. 61GPT Image 1.5 vs. Adobe Firefly Image 4
  53. 62GPT Image 1.5 vs. Adobe Firefly Image 4 Ultra
  54. 63GPT Image 1.5 vs. Stable Diffusion 3.5 Medium
  55. 64GPT Image 1.5 vs. Stable Diffusion 3.5 Large Turbo
  56. 65GPT Image 1.5 vs. Bria FIBO Lite
  57. 66GPT Image 1.5 vs. Recraft V4.1 Utility Pro
  58. 67GPT Image 1.5 vs. Seedream 4.5
  59. 68GPT Image 1.5 vs. Seedream 5.0 Lite
  60. 69GPT Image 1.5 vs. FLUX.2 Klein 9B Preview
  61. 70GPT Image 1.5 vs. GPT Image 1 Mini
  62. 71GPT Image 1.5 vs. ChatGPT Image Latest (API-Alias)
  63. 72GPT Image 1.5 vs. Nano Banana (Gemini 2.5 Flash Image)
  64. 73GPT Image 1.5 vs. FLUX.2 Klein 4B
  65. 74GPT Image 1.5 vs. FLUX.2 Dev
  66. 75GPT Image 1.5 vs. FLUX1.1 [pro]
  67. 76GPT Image 1.5 vs. FLUX1.1 [pro] Ultra
  68. 77GPT Image 1.5 vs. FLUX.1 [dev]
  69. 78GPT Image 1.5 vs. FLUX.1 Kontext [pro]
  70. 79GPT Image 1.5 vs. FLUX.1 Kontext [max]
  71. 80GPT Image 1.5 vs. Stable Diffusion XL 1.0
  72. 81GPT Image 1.5 vs. Stable Diffusion 3 Medium
  73. 82GPT Image 1.5 vs. SDXL Turbo
  74. 83GPT Image 1.5 vs. Stable Diffusion Turbo
  75. 84GPT Image 1.5 vs. Grok Imagine Image 1.0
  76. 85GPT Image 1.5 vs. MOSS-Image-Base
  77. 86GPT Image 1.5 vs. MOSS-Image-SFT
  78. 87GPT Image 1.5 vs. LLaDA-Image
  79. 88GPT Image 1.5 vs. LLaDA-Image-Turbo
  80. 89GPT Image 1.5 vs. Nucleus-Image
  81. 90GPT Image 1.5 vs. LongCat-Image
  82. 91GPT Image 1.5 vs. BAGEL-7B-MoT
  83. 92GPT Image 1.5 vs. OmniGen2
  84. 93GPT Image 1.5 vs. Kandinsky-5.0-T2I-Lite-SFT
  85. 94GPT Image 1.5 vs. Kandinsky-5.0-T2I-Lite-Pretrain
  86. 95GPT Image 1.5 vs. Boogu-Image-0.1-Base
  87. 96GPT Image 1.5 vs. Boogu-Image-0.1-Turbo
  88. 97GPT Image 1.5 vs. SANA-1.5 1.6B 1024px
  89. 98GPT Image 1.5 vs. SANA-1.5 4.8B 1024px
  90. 99GPT Image 1.5 vs. Sana-Sprint 0.6B 1024px
  91. 100GPT Image 1.5 vs. Sana-Sprint 1.6B 1024px
  92. 101GPT Image 1.5 vs. Chroma1-HD
  93. 102GPT Image 1.5 vs. Chroma1-Flash
  94. 103GPT Image 1.5 vs. AuraFlow v0.3
  95. 104GPT Image 1.5 vs. PixArt-Sigma-XL-2-1024-MS
  96. 105GPT Image 1.5 vs. Lumina-Image 2.0
  97. 106GPT Image 1.5 vs. HunyuanImage 3.0
  98. 107GPT Image 1.5 vs. Z-Image Base

Alle technischen Daten

Ein- und Ausgabe

Maximale Ausgabe
1.536 × 1.024 Pixel
Quelle: Maximale Ausgabe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Proprietär
Quelle: Gewichte
Zugang
API, Web
Quelle: Zugang
Lebenszyklus
Von OpenAI als veraltet markiert; Abschaltung aus der API am 1. Dezember 2026
Quelle: Lebenszyklus

Weitere Angaben

Generator
gpt-image-1.5
Quelle: Generator

Preise

Preisansicht wählen
Repräsentativer Preis
0,133 $ pro BildQuelle
Together AI (openai/gpt-image-1.5)
0,034 $ pro MegapixelQuelle

Kein Abo von OpenAI mit diesem Modell. Über andere Anbieter ab ≈ 6,36 € im Monat (ElevenLabs Starter, mit begrenztem Guthaben). 42 Tarife in Deutschland.

Tarife filtern
TarifPreis im MonatHinweis
ElevenLabs Freekostenlosmit begrenztem Guthaben
Hailuo AI FreeMiniMaxkostenlosmit begrenztem Guthaben
ElevenLabs Starter≈ 6,36 €mit begrenztem Guthaben
Poe Basic6,83 €mit begrenztem Guthaben
Adobe Firefly Standard10,98 €mit begrenztem Guthaben
Hailuo AI StandardMiniMax≈ 11,13 €mit begrenztem Guthaben
Leonardo.Ai Essential≈ 12,72 €
Runway Standard≈ 15,90 €mit begrenztem Guthaben
Adobe Firefly Pro21,99 €mit begrenztem Guthaben
ElevenLabs Creator≈ 23,33 €mit begrenztem Guthaben
Leonardo.Ai Team Starter≈ 25,45 €für Teams, je Nutzer
Poe Plus27,36 €mit begrenztem Guthaben
Leonardo.Ai Premium≈ 31,81 €
Luma Plus≈ 31,81 €mit begrenztem Guthaben
Runway Pro≈ 37,11 €mit begrenztem Guthaben
Hailuo AI ProMiniMax≈ 40,29 €mit begrenztem Guthaben
Leonardo.Ai Team Growth≈ 50,89 €für Teams, je Nutzer
Adobe Firefly Pro Plus54,99 €mit begrenztem Guthaben
Mindverse Studio Team58,31 €für Teams, je Nutzer
Leonardo.Ai Ultimate≈ 63,61 €
Poe Pro68,41 €mit begrenztem Guthaben
Mindverse Studio Pro70,21 €je Nutzer
Runway Team≈ 73,16 €mit begrenztem Guthaben, für Teams, je Nutzer
Hailuo AI MasterMiniMax≈ 94,36 €mit begrenztem Guthaben
Luma Pro≈ 95,42 €mit begrenztem Guthaben
Runway Max≈ 100,72 €mit begrenztem Guthaben
ElevenLabs Pro≈ 104,96 €mit begrenztem Guthaben
Poe Advanced136,84 €mit begrenztem Guthaben
Adobe Firefly Premium219,98 €mit begrenztem Guthaben
Hailuo AI MaxMiniMax≈ 229,01 €mit begrenztem Guthaben
ElevenLabs Scale≈ 317,01 €mit begrenztem Guthaben, für Teams
Luma Ultra≈ 318,07 €mit begrenztem Guthaben
Poe Max342,11 €mit begrenztem Guthaben
ElevenLabs Business≈ 1.049,63 €mit begrenztem Guthaben, für Teams
Adobe Firefly Premium für Teamsk. A.mit begrenztem Guthaben, für Teams, je Nutzer
Adobe Firefly Pro für Teamsk. A.mit begrenztem Guthaben, für Teams, je Nutzer
Adobe Firefly Pro Plus für Teamsk. A.mit begrenztem Guthaben, für Teams, je Nutzer
ElevenLabs Enterprisek. A.für Unternehmen
Leonardo.Ai Customk. A.für Unternehmen
Luma Enterprisek. A.für Unternehmen
Luma Teamk. A.für Teams
Runway Enterprisek. A.für Unternehmen

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu GPT Image 1.5

Wie gut ist GPT Image 1.5?

In der Arena-Wertung Platz 13 von 21. In unserem eigenen Test Platz 29 von 108.

Arena-Wertung vom 06.11.2026 · GraduallyBench vom 03.11.2026

Arena-Wertungaus Stimmen von Nutzerinnen und Nutzern · höher ist besser
Seedream 5.0 Pro1.251
Nano Banana 2 Lite1.249
Nano Banana Pro1.246
GPT Image 1.5Platz 13 von 211.236
Qwen-Image-2.11.227
FLUX.2 Max1.161
FLUX.2 Flex1.156
GraduallyBenchunsere eigene Bewertung, 0 bis 100 · höher ist besser
MAI-Image-2.569
FLUX.2 Max69
MAI-Image-2.668
GPT Image 1.5Platz 29 von 10868
Qwen Image 3.068
MAI-Image-2.6 Flash67
Seedream 5.0 Lite67

Wofür eignet sich GPT Image 1.5?

Am besten für Figur und Details (89 von 100), am schwächsten bei Produktfotografie (52).

GraduallyBench, je Aufgabe ein Bild

  1. GPT Image 1.5: Typografie und LayoutTypografie und LayoutLesbarer Text, Hierarchie und Komposition60von 100Platz 47 von 108 in dieser Aufgabe
  2. GPT Image 1.5: ProduktfotografieProduktfotografieMaterialien, Reflexionen und kleine Details52von 100Platz 53 von 108 in dieser Aufgabe
  3. GPT Image 1.5: Figur und DetailsFigur und DetailsAnatomie, Kleidung und räumliche Konsistenz89von 100Platz 1 von 108 in dieser Aufgabe
  4. GPT Image 1.5: InfografikInfografikZahlen, Beschriftungen und visuelle Ordnung72von 100Platz 35 von 108 in dieser Aufgabe

Was kostet ein Bild mit GPT Image 1.5?

Rund 0,13 $ je Bild. Das ist teuer: Ein typisches Bildmodell kostet 0,06 $.

Konfiguration: High

Preis je BildDollar je Bild · niedriger ist besser
HiDream-O1-Image-1.50,08 $
Seedream 5.0 Pro0,09 $
Ideogram 4.50,10 $
GPT Image 1.5Platz 24 von 280,13 $
Nano Banana Pro0,13 $
GPT Image 2.5 Sunburst0,21 $
GPT Image 2.5 Flare0,21 $

Wo kann ich GPT Image 1.5 nutzen?

Nicht im Abo von OpenAI. Zusammen mit anderen Anbietern sind es 42 Tarife in Deutschland.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei OpenAI

Kein Abo von OpenAI mit diesem Modell.

Über andere Anbieter

42 Tarife bei 8 Anbietern, ab ≈ 6,36 € im Monat (ElevenLabs Starter), mit begrenztem Guthaben.

Quellen und Datenstand

Alle 41 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
RecherchestandRecherchestand 16. Oktober 2026. 24 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

immutable-serving-weights

Hinweis

IMG.LY nennt die Route fal:fal-ai/gpt-image-1.5, veröffentlicht auf der Modellseite aber keine inhaltsadressierte Gewichtsrevision. Die Routenbezeichnung allein belegt keine unveränderliche Backend-Identität.

Nicht veröffentlicht

model-run-date

Hinweis

Die Methodik nennt das letzte Datum der Suite und die Berechnung der Scores, nicht das tatsächliche Ausführungsdatum dieser Modellzeile.

Nicht veröffentlicht

category-sample-counts

Hinweis

Für die 15 Kategorienmittelwerte wird kein Nenner angegeben. Stichprobengrößen stehen nur an Kriterien, für die die Modellseite ausdrücklich Scores über Läufe nennt. Die Gesamtzahl von 111 Bildern wird nicht als Kategorien-N verwendet.

Nicht veröffentlicht

exact-serving-configuration

Originalwortlaut

The evaluator's model label matches High generation, but it does not publish resolution, seed, generation controls, or serving revision.

Nicht veröffentlicht

model-specific-successful-image-denominator

Originalwortlaut

The paper and release documentation do not publish the per-model successful-image or prompt denominators for these means. The 432-prompt corpus, 216 prompts per language, and planned four samples per prompt are not used to infer N or confidence intervals.

Nicht veröffentlicht

exact-serving-and-generation-configuration

Originalwortlaut

Serving revision, image resolution, seed, endpoint details, and generation controls are not reported for the GPT Image 1.5 [High] row.

Nicht veröffentlicht

exact-serving-revision

Hinweis

Der Evaluator zeigt die exakte Produktzeile, veröffentlicht aber weder API-Route noch Serving-Checkpointrevision.

Weitere QuelleOpenAI (abgerufen 17. Oktober 2026) · OpenAI GPT Image 1.5 model documentation · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleBildmodell-Preise (abgerufen 17. Oktober 2026; 28. Oktober 2026; 3. November 2026; 5. November 2026; 6. November 2026)
Weitere QuelleLebenszyklusdaten · OpenAI API deprecations · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleTogether AI
Weitere QuelleArtificial Analysis (abgerufen 17. Oktober 2026; 28. Oktober 2026; 3. November 2026; 5. November 2026; 6. November 2026)
Weitere QuelleLMArena (abgerufen 6. November 2026)12
Weitere QuelleGenExam (abgerufen 26. August 2026)
Weitere QuelleQwen Image Bench (abgerufen 26. August 2026)
Weitere QuelleWISE Verified (abgerufen 26. August 2026)
Weitere QuelleGRADE (abgerufen 26. August 2026)
Weitere QuelleGEBench (abgerufen 26. August 2026)
Weitere QuelleGemini 3.1 Flash Image model card (abgerufen 26. August 2026)
Weitere QuelleGradually-Bildtest (abgerufen 3. November 2026)
Weitere QuelleIMG.LY GenAI Benchmark (abgerufen 16. Oktober 2026; 20. Oktober 2026)
Weitere QuelleRapidata benchmark.ai (abgerufen 17. Oktober 2026)
Weitere QuelleUltraText Bench: Evaluating Dense Text Rendering in Generated Images (abgerufen 17. Oktober 2026)
Weitere QuelleRISEBench++ evaluation (arXiv:2610.12343) (abgerufen 17. Oktober 2026)
Weitere QuelleSpecV authors, pinned evaluation README (abgerufen 17. Oktober 2026)
Weitere QuelleMultiBind authors, arXiv v1 (abgerufen 17. Oktober 2026)
Weitere QuelleGEditBench v2 authors (abgerufen 17. Oktober 2026)
Weitere QuelleGRADE authors, arXiv:2603.12264v2 (abgerufen 18. Oktober 2026)
Weitere QuellePhyEditBench authors, arXiv:2606.26551v1 (abgerufen 18. Oktober 2026)
Weitere QuelleWiro AI Image Models benchmark (abgerufen 18. Oktober 2026)
Weitere QuelleRISEBench++ evaluation (arXiv:2610.12343) (abgerufen 18. Oktober 2026)
Weitere QuelleQMU (株式会社くむ), LLM Foundation Research (abgerufen 19. Oktober 2026)
Weitere QuelleRapidata text-to-image human feedback benchmark (abgerufen 22. Oktober 2026)
Weitere QuelleRapidata text-to-image human feedback benchmark (abgerufen 23. Oktober 2026)
Weitere QuelleBizGenEval paper authors (abgerufen 23. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 16. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)12
Weitere QuelleModellmetadaten (abgerufen 18. Oktober 2026)123
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0