Zum Hauptinhalt springen

AlibabaBildmodell

Wan 2.6 Text to Image

Wan 2.6 Text to Image liegt in unserem Test GraduallyBench auf Platz 44 von 108.

Arena-Wertungnicht bewertet

k. A.Stimmen von Nutzernhöher ist besser

GraduallyBenchPlatz 44 von 108

63eigene Bewertung0 bis 100

PreisPlatz 6 von 28

0,03 $je Bildniedriger ist besser

BeliebtheitPlatz 630 von 875

13von 100wie im Vormonat

Zusammenfassung

Mit 0,03 $ je Bild ist es günstig, ein typisches Bildmodell kostet 0,06 $.

Wan 2.6 Text to Image verbindet Alibabas textbasierte Generierung bis 2K mit Bildbearbeitung in derselben API. Im Bearbeitungsmodus lassen sich ein bis vier Referenzbilder, Stilübertragung und konsistente Personen- oder Produktvarianten kombinieren.

Die API verwendet standardmäßig 1K und bietet 2K als separate Ausgabeoption. Bei Bearbeitungen ist mindestens ein Referenzbild nötig. Prompt-Erweiterung kann den positiven Prompt automatisch ausbauen, während der negative Prompt unverändert bleibt. Die Gewichte sind proprietär und der katalogisierte Zugang läuft über die API, nicht über eine lokale Installation.

Bildbeispiele aus unseren Tests

Diese Bilder stammen aus dokumentierten Einzelanfragen mit archiviertem Prompt. Sie ergänzen die Messwerte, ersetzen aber keinen kontrollierten Labortest.

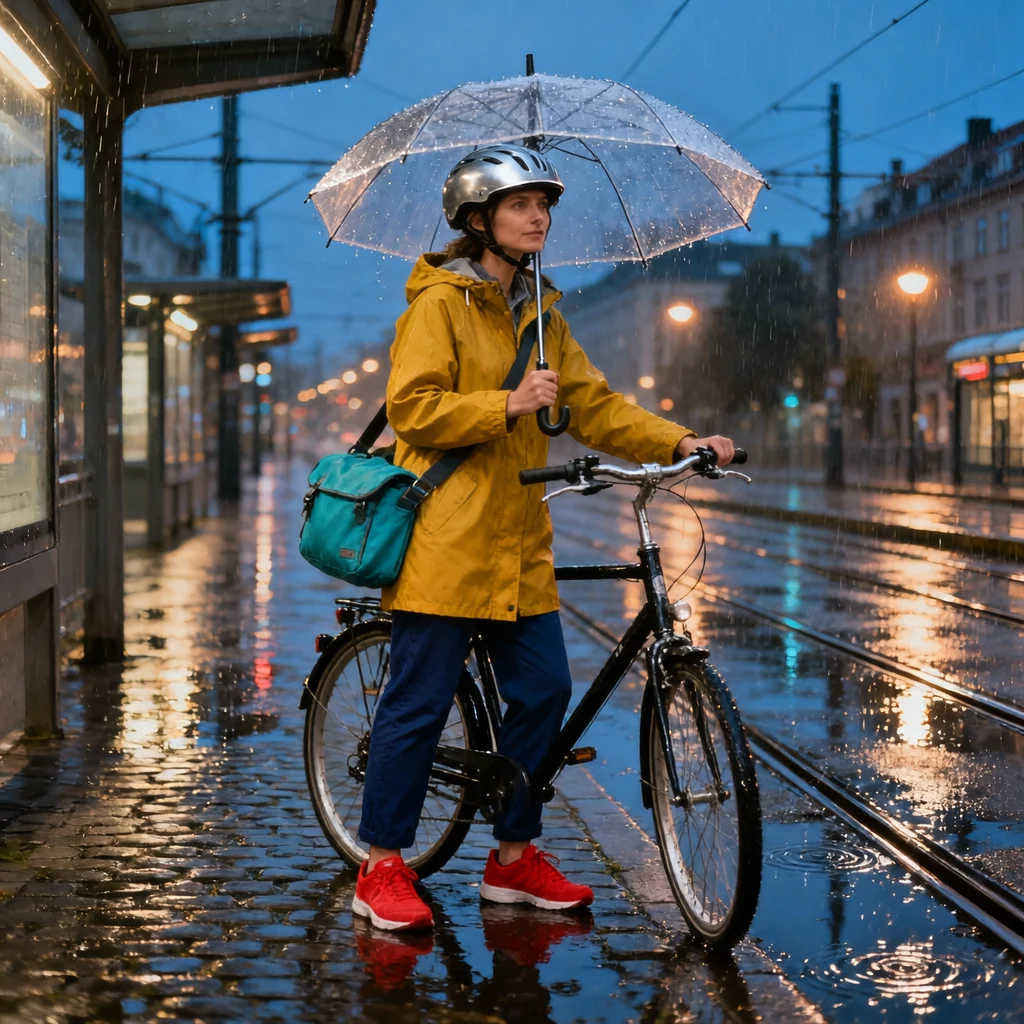
Figur und DetailsFigur und Details in Originalgröße öffnen

Figur und Details

Das Beispiel prüft Anatomie, Kleidung und räumliche Konsistenz.

Prompt und Einstellungen

Create a square cinematic full-body portrait of a fictional bicycle courier waiting under a transparent umbrella at a rainy tram stop in Hamburg at blue hour. She wears a mustard raincoat, navy trousers, red sneakers, a silver helmet, and carries a teal messenger bag. Keep both hands visible, render the bicycle correctly, use realistic wet-street reflections, and include no readable brand names.

Erzeugt über together mit der Modellkennung Wan-AI/Wan2.6-image. Archivierte Einstellungen waren requested 1280x1280, stored 1024x1024 (Lanczos3 downscale), n=1, seed=provider random, provider default steps.

Quelle öffnen
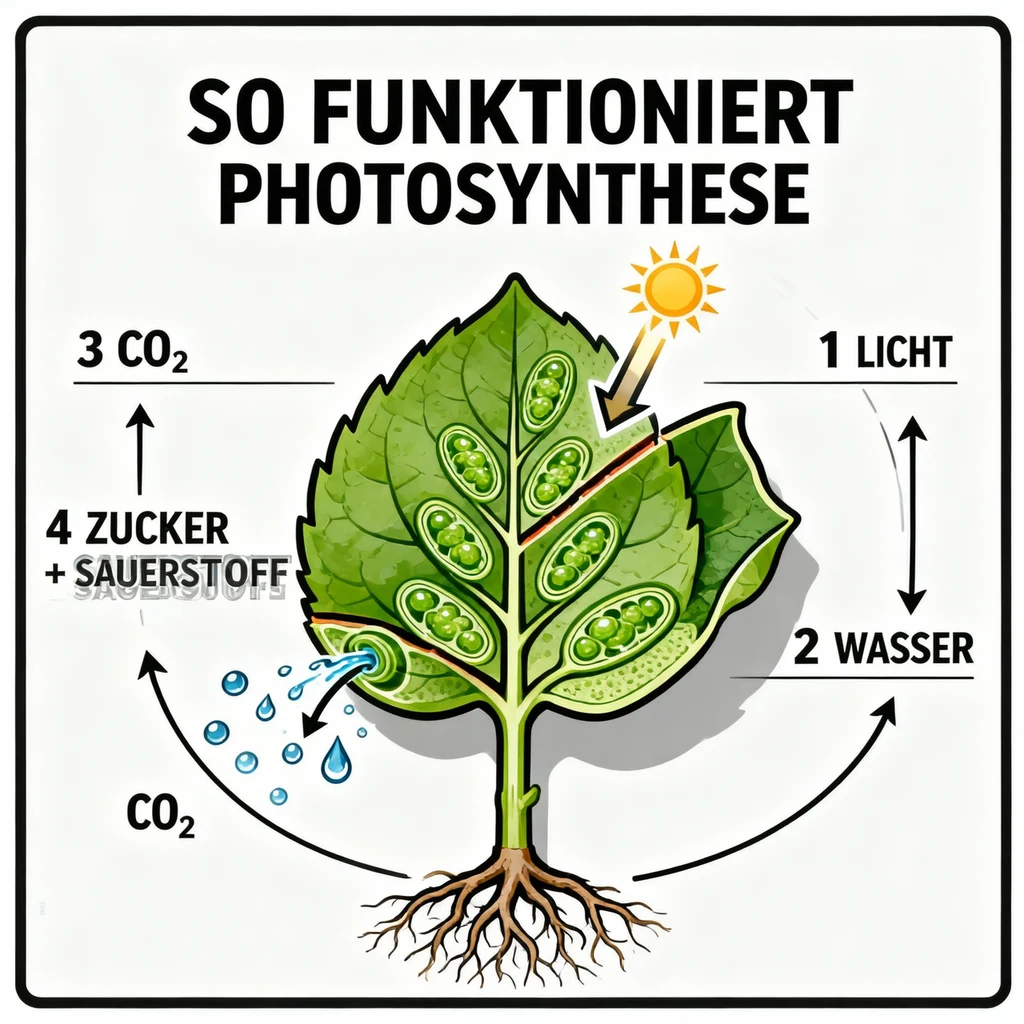
InfografikInfografik in Originalgröße öffnen

Infografik

Das Beispiel prüft Zahlen, Beschriftungen und visuelle Ordnung.

Prompt und Einstellungen

Create a square German infographic titled SO FUNKTIONIERT PHOTOSYNTHESE. Show exactly four numbered steps in this order: 1 LICHT, 2 WASSER, 3 CO₂, 4 ZUCKER + SAUERSTOFF. Use a clean editorial science style with one plant cross-section, simple arrows, high contrast, legible labels, and no other text.

Erzeugt über together mit der Modellkennung Wan-AI/Wan2.6-image. Archivierte Einstellungen waren requested 1280x1280, stored 1024x1024 (Lanczos3 downscale), n=1, seed=provider random, provider default steps.

Quelle öffnen
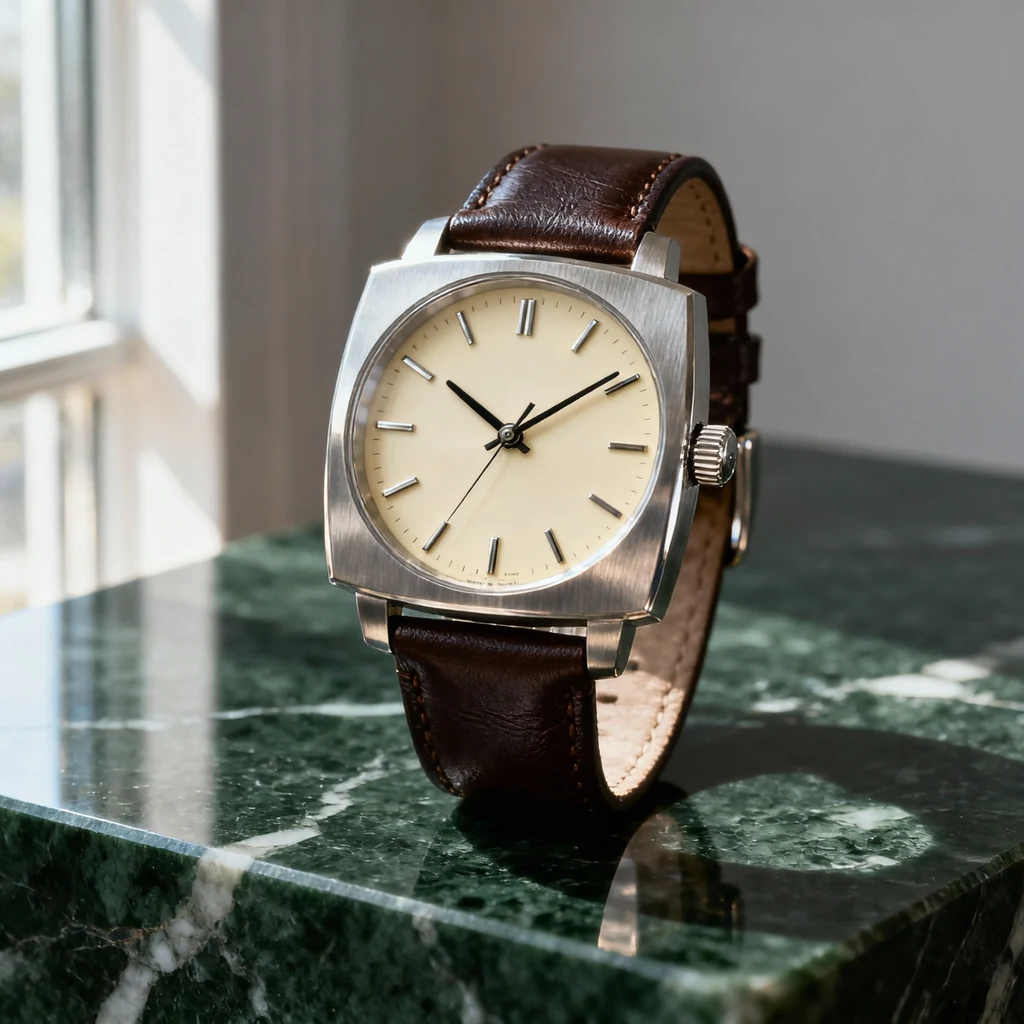
ProduktfotografieProduktfotografie in Originalgröße öffnen

Produktfotografie

Das Beispiel prüft Materialien, Reflexionen und kleine Details.

Prompt und Einstellungen

Create a square premium product photograph of a brushed titanium wristwatch standing upright on dark green marble. The watch has a cream dial, thin black hands set to 10:10, twelve distinct hour markers, a realistic crown, and a dark brown leather strap. Soft window light from the left, controlled reflections, shallow depth of field, no text, no logo, no extra objects.

Erzeugt über together mit der Modellkennung Wan-AI/Wan2.6-image. Archivierte Einstellungen waren requested 1280x1280, stored 1024x1024 (Lanczos3 downscale), n=1, seed=provider random, provider default steps.

Quelle öffnen
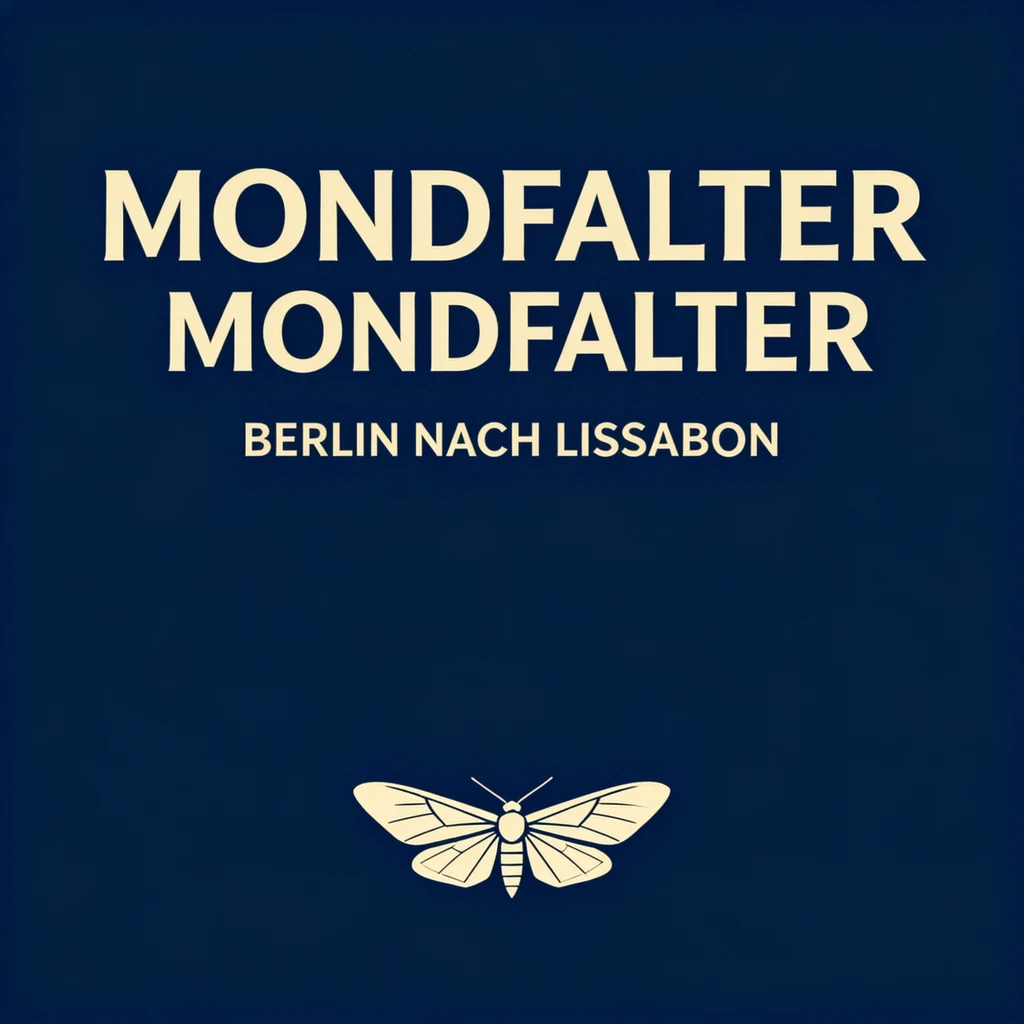
Typografie und LayoutTypografie und Layout in Originalgröße öffnen

Typografie und Layout

Das Beispiel prüft Lesbarer Text, Hierarchie und Komposition.

Prompt und Einstellungen

Create a square editorial poster for an imaginary night train called MONDFALTER. Show the exact German headline MONDFALTER and the exact subline BERLIN NACH LISSABON. Use a restrained midnight-blue and warm-cream palette, one stylized moth, strong Swiss-grid typography, generous negative space, and no additional words or logos.

Erzeugt über together mit der Modellkennung Wan-AI/Wan2.6-image. Archivierte Einstellungen waren requested 1280x1280, stored 1024x1024 (Lanczos3 downscale), n=1, seed=provider random, provider default steps.

Quelle öffnen

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 23 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 2

Veröffentlichte Benchmarks

Text to Image Arena

Elo-Werte fassen Paarvergleiche innerhalb dieser Vergleichstabelle zusammen. Sie sind keine Prozentwerte. Die Skala erlaubt keine Aussage über absolute Qualität oder lineare Abstände zwischen Modellen.

GPT Image 21.187,61 Elo
MAI-Image-2.61.168,32 Elo
Nano Banana 21.141,6 Elo
Muse Image1.127,86 Elo
GPT Image 1.51.123,86 Elo
MAI-Image-2.51.120,06 Elo
Nano Banana Pro1.118,67 Elo
Nano Banana 2 Lite1.109,07 Elo
Seedream 5.0 Pro1.101,17 Elo
Qwen-Image-2.11.045,48 Elo
Krea 2 Large1.035,45 Elo
Qwen Image 2.0 Pro1.031,23 Elo
FLUX.2 Flex1.027,68 Elo
FLUX.2 Max1.020,57 Elo
Wan 2.6 Text to Image1.017,69 Elo
Ideogram 4.51.015,99 Elo
FLUX.2 Pro1.003,17 Elo
Ideogram 4.01.002,93 Elo
FLUX.2 Klein 9B932,08 Elo

höhere Werte sind besserStand 6. November 2026Skala: 0 Elo - 1.227,25 Elo

Quelle: Artificial Analysis
gradually.ai
Methodik und Einordnung
Messgröße
elo-rating
Skala
Keine obere Grenze dokumentiert. Die Darstellung umfasst die erfassten Werte und den Nullpunkt.
Teilnehmer
30
Methodik und Einordnung
AA-Auftritte: 5817. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 29. Oberer Rang: 44. Kennung des Quellmodells: caa670a4-e827-4a4b-84fb-2dd240205fe2. Kennung der Evidenzaufnahme: aa-image-text-to-image-v2.1-2026-11-06-e430d57b5d0b. Prüfsumme der Quelldaten: e430d57b5d0bf260d6feb60bb7d8fa32da8d7961ec2bd9a9cae58fb015613cf0
Quelle: Artificial Analysis

GEBench

GEBench Chinesisch, Einzelschritt

Nano Banana Pro84,5 Punkte
GPT Image 1.583,79 Punkte
FLUX.2 Pro68,83 Punkte
Wan 2.6 Text to Image64,2 Punkte
Seedream 4.062,04 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Chinesisch, Mehrschritt

Nano Banana Pro68,65 Punkte
GPT Image 1.556,97 Punkte
FLUX.2 Pro55,07 Punkte
Wan 2.6 Text to Image50,11 Punkte
Seedream 4.048,64 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Chinesisch, fiktive App

Nano Banana Pro65,75 Punkte
GPT Image 1.560,11 Punkte
FLUX.2 Pro58,13 Punkte
Wan 2.6 Text to Image52,72 Punkte
Seedream 4.049,28 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Chinesisch, reale App

Nano Banana Pro64,35 Punkte
GPT Image 1.555,65 Punkte
FLUX.2 Pro55,41 Punkte
Seedream 4.050,93 Punkte
Wan 2.6 Text to Image50,4 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Chinesisch, Verankerung

Nano Banana Pro64,83 Punkte
Wan 2.6 Text to Image59,58 Punkte
Seedream 4.053,53 Punkte
GPT Image 1.553,33 Punkte
FLUX.2 Pro50,24 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Chinesisch, Gesamtwert

Nano Banana Pro69,62 Punkte
GPT Image 1.563,22 Punkte
FLUX.2 Pro57,54 Punkte
Wan 2.6 Text to Image55,4 Punkte
Seedream 4.052,88 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Englisch, Einzelschritt

Nano Banana Pro84,32 Punkte
GPT Image 1.580,8 Punkte
FLUX.2 Pro61 Punkte
Wan 2.6 Text to Image60,17 Punkte
Seedream 4.053,28 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Englisch, Mehrschritt

Nano Banana Pro69,51 Punkte
GPT Image 1.558,87 Punkte
FLUX.2 Pro52,17 Punkte
Wan 2.6 Text to Image44,36 Punkte
Seedream 4.037,57 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Englisch, fiktive App

GPT Image 1.563,68 Punkte
FLUX.2 Pro49,92 Punkte
Wan 2.6 Text to Image49,55 Punkte
Seedream 4.047,92 Punkte
Nano Banana Pro46,33 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Englisch, reale App

GPT Image 1.558,93 Punkte
Seedream 4.049,36 Punkte
Nano Banana Pro47,2 Punkte
FLUX.2 Pro47,16 Punkte
Wan 2.6 Text to Image44,8 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

GEBench Englisch, Verankerung

Nano Banana Pro58,64 Punkte
Wan 2.6 Text to Image53,36 Punkte
GPT Image 1.549,23 Punkte
FLUX.2 Pro45,67 Punkte
Seedream 4.044,17 Punkte

höhere Werte sind besserStand 26. August 2026Skala: 0 Punkte - 100 Punkte

Quelle: GEBench
gradually.ai
Methodik und Einordnung
Messgröße
points-100
Skala
0-100
Teilnehmer
5
Methodik und Einordnung
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle: GEBench

Dokumentierte Messdetails

Text to Image Arena (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1017.69
Bewertung
1017.69
Messgröße
elo-rating
Einheit
Elo
Benchmark-Version
v2.1
Richtung
Mehr ist besser
Quellenrang
39
Konfidenzintervall
12
Untere Konfidenzgrenze
1005.69
Obere Konfidenzgrenze
1029.69
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Abrufdatum
2026-11-06
Methodik
AA-Auftritte: 5817. Die Anzahl belegt keine unabhängige Stichprobe. Unterer Rang: 29. Oberer Rang: 44. Kennung des Quellmodells: caa670a4-e827-4a4b-84fb-2dd240205fe2. Kennung der Evidenzaufnahme: aa-image-text-to-image-v2.1-2026-11-06-e430d57b5d0b. Prüfsumme der Quelldaten: e430d57b5d0bf260d6feb60bb7d8fa32da8d7961ec2bd9a9cae58fb015613cf0
Preis pro 1.000 Token in USD
30
Quelle Artificial Analysis
GEBench Chinesisch, Einzelschritt (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
64.2
Bewertung
64.2
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Chinesisch, Mehrschritt (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
50.11
Bewertung
50.11
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Chinesisch, fiktive App (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
52.72
Bewertung
52.72
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Chinesisch, reale App (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
50.4
Bewertung
50.4
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
5
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Chinesisch, Verankerung (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
59.58
Bewertung
59.58
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
2
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Chinesisch, Gesamtwert (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
55.4
Bewertung
55.4
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Englisch, Einzelschritt (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
60.17
Bewertung
60.17
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Englisch, Mehrschritt (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
44.36
Bewertung
44.36
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
4
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Englisch, fiktive App (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
49.55
Bewertung
49.55
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
3
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Englisch, reale App (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
44.8
Bewertung
44.8
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
5
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench
GEBench Englisch, Verankerung (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
53.36
Bewertung
53.36
Messgröße
points-100
Einheit
points
Richtung
Mehr ist besser
Quellenrang
2
Quellentyp
research-benchmark
Auswertung
GEBench evaluation pipeline
Abrufdatum
2026-08-26
Methodik
Zweisprachiger Test für grafische Benutzeroberflächen. Chinesische und englische Aufgaben sowie Einzelschritt, Mehrschritt, fiktive App, reale App und räumliche Verankerung bleiben getrennt.
Quelle GEBench

Seite 1 von 2

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 100 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 5. November 2026

Wan 2.6 Text to ImageFirefly Image Model 5Nano Banana 2.1Grok Imagine Image 2.0Recraft V4.1 Utility

Wan 2.6 Text to Image im Vergleich

Mit anderem Modell vergleichen

Die beliebtesten Vergleiche

  1. 1GPT Image 2.5 Sunburst vs. Wan 2.6 Text to Image
  2. 2GPT Image 2 vs. Wan 2.6 Text to Image
  3. 3Reve 2.1 vs. Wan 2.6 Text to Image
  4. 4Nano Banana 2 vs. Wan 2.6 Text to Image
  5. 5Midjourney V8.2 vs. Wan 2.6 Text to Image
  6. 6GPT Image 1.5 vs. Wan 2.6 Text to Image
  7. 7MAI-Image-2.5 vs. Wan 2.6 Text to Image
  8. 8Nano Banana Pro vs. Wan 2.6 Text to Image
  9. 9Nano Banana 2 Lite vs. Wan 2.6 Text to Image
Alle 108 Vergleiche zeigen
  1. 10Seedream 5.0 Pro vs. Wan 2.6 Text to Image
  2. 11Grok Imagine Image Quality vs. Wan 2.6 Text to Image
  3. 12FLUX.2 Max vs. Wan 2.6 Text to Image
  4. 13Qwen Image 2.0 Pro vs. Wan 2.6 Text to Image
  5. 14MAI-Image-2.5 Flash vs. Wan 2.6 Text to Image
  6. 15HiDream-O1-Image-1.5 vs. Wan 2.6 Text to Image
  7. 16Krea 2 Medium Turbo vs. Wan 2.6 Text to Image
  8. 17Seedream 4.0 vs. Wan 2.6 Text to Image
  9. 18Krea 2 Large vs. Wan 2.6 Text to Image
  10. 19Luma Uni-1.1 Max vs. Wan 2.6 Text to Image
  11. 20FLUX.2 Flex vs. Wan 2.6 Text to Image
  12. 21Recraft V4.1 Utility vs. Wan 2.6 Text to Image
  13. 22Ideogram 4.0 vs. Wan 2.6 Text to Image
  14. 23Wan 2.6 Text to Image vs. FLUX.2 Pro
  15. 24Wan 2.6 Text to Image vs. HunyuanImage 3.0 Instruct
  16. 25Wan 2.6 Text to Image vs. FLUX.2 Klein 9B
  17. 26Wan 2.6 Text to Image vs. HiDream-O1-Image
  18. 27Wan 2.6 Text to Image vs. Firefly Image Model 5
  19. 28Wan 2.6 Text to Image vs. Midjourney V8.1
  20. 29Wan 2.6 Text to Image vs. Stable Diffusion 3.5 Large
  21. 30Wan 2.6 Text to Image vs. GPT Image 2.5 Flare
  22. 31Wan 2.6 Text to Image vs. Qwen-Image-2.1
  23. 32Wan 2.6 Text to Image vs. MAI-Image-2.6
  24. 33Wan 2.6 Text to Image vs. MAI-Image-2.6 Flash
  25. 34Wan 2.6 Text to Image vs. Muse Image
  26. 35Wan 2.6 Text to Image vs. Grok Imagine Image 2.0
  27. 36Wan 2.6 Text to Image vs. FLUX 3 Image
  28. 37Wan 2.6 Text to Image vs. FLUX 3 Image Klein
  29. 38Wan 2.6 Text to Image vs. Nano Banana 2.1
  30. 39Wan 2.6 Text to Image vs. Ideogram 4.5
  31. 40Wan 2.6 Text to Image vs. Hy Image 3.5 Preview
  32. 41Wan 2.6 Text to Image vs. Recraft V4.1
  33. 42Wan 2.6 Text to Image vs. Recraft V4.1 Flash
  34. 43Wan 2.6 Text to Image vs. Bria FIBO 2
  35. 44Wan 2.6 Text to Image vs. Krea 3
  36. 45Wan 2.6 Text to Image vs. Qwen Image 3.0 Pro
  37. 46Wan 2.6 Text to Image vs. Qwen Image 3.0
  38. 47Wan 2.6 Text to Image vs. Qwen Image 2.1 Pro
  39. 48Wan 2.6 Text to Image vs. Qwen Image 2.1 Turbo
  40. 49Wan 2.6 Text to Image vs. Wan 2.7 Image Pro
  41. 50Wan 2.6 Text to Image vs. Wan 2.7 Image
  42. 51Wan 2.6 Text to Image vs. Seedream 5.0 Flash
  43. 52Wan 2.6 Text to Image vs. SenseNova U1.5 Lite
  44. 53Wan 2.6 Text to Image vs. Kling Image 3.0
  45. 54Wan 2.6 Text to Image vs. Kling Image 3.0 Omni
  46. 55Wan 2.6 Text to Image vs. Vidu Q2 Image
  47. 56Wan 2.6 Text to Image vs. GLM-Image
  48. 57Wan 2.6 Text to Image vs. MiniMax Image-01
  49. 58Wan 2.6 Text to Image vs. Z-Image Turbo
  50. 59Wan 2.6 Text to Image vs. Luma Uni-1.1
  51. 60Wan 2.6 Text to Image vs. Runway Gen-4 Image
  52. 61Wan 2.6 Text to Image vs. Adobe Firefly Image 3
  53. 62Wan 2.6 Text to Image vs. Adobe Firefly Image 4
  54. 63Wan 2.6 Text to Image vs. Adobe Firefly Image 4 Ultra
  55. 64Wan 2.6 Text to Image vs. Stable Diffusion 3.5 Medium
  56. 65Wan 2.6 Text to Image vs. Stable Diffusion 3.5 Large Turbo
  57. 66Wan 2.6 Text to Image vs. Bria FIBO Lite
  58. 67Wan 2.6 Text to Image vs. Recraft V4.1 Utility Pro
  59. 68Wan 2.6 Text to Image vs. Seedream 4.5
  60. 69Wan 2.6 Text to Image vs. Seedream 5.0 Lite
  61. 70Wan 2.6 Text to Image vs. FLUX.2 Klein 9B Preview
  62. 71Wan 2.6 Text to Image vs. GPT Image 1 Mini
  63. 72Wan 2.6 Text to Image vs. ChatGPT Image Latest (API-Alias)
  64. 73Wan 2.6 Text to Image vs. Nano Banana (Gemini 2.5 Flash Image)
  65. 74Wan 2.6 Text to Image vs. FLUX.2 Klein 4B
  66. 75Wan 2.6 Text to Image vs. FLUX.2 Dev
  67. 76Wan 2.6 Text to Image vs. FLUX1.1 [pro]
  68. 77Wan 2.6 Text to Image vs. FLUX1.1 [pro] Ultra
  69. 78Wan 2.6 Text to Image vs. FLUX.1 [dev]
  70. 79Wan 2.6 Text to Image vs. FLUX.1 Kontext [pro]
  71. 80Wan 2.6 Text to Image vs. FLUX.1 Kontext [max]
  72. 81Wan 2.6 Text to Image vs. Stable Diffusion XL 1.0
  73. 82Wan 2.6 Text to Image vs. Stable Diffusion 3 Medium
  74. 83Wan 2.6 Text to Image vs. SDXL Turbo
  75. 84Wan 2.6 Text to Image vs. Stable Diffusion Turbo
  76. 85Wan 2.6 Text to Image vs. Grok Imagine Image 1.0
  77. 86Wan 2.6 Text to Image vs. MOSS-Image-Base
  78. 87Wan 2.6 Text to Image vs. MOSS-Image-SFT
  79. 88Wan 2.6 Text to Image vs. LLaDA-Image
  80. 89Wan 2.6 Text to Image vs. LLaDA-Image-Turbo
  81. 90Wan 2.6 Text to Image vs. Nucleus-Image
  82. 91Wan 2.6 Text to Image vs. LongCat-Image
  83. 92Wan 2.6 Text to Image vs. BAGEL-7B-MoT
  84. 93Wan 2.6 Text to Image vs. OmniGen2
  85. 94Wan 2.6 Text to Image vs. Kandinsky-5.0-T2I-Lite-SFT
  86. 95Wan 2.6 Text to Image vs. Kandinsky-5.0-T2I-Lite-Pretrain
  87. 96Wan 2.6 Text to Image vs. Boogu-Image-0.1-Base
  88. 97Wan 2.6 Text to Image vs. Boogu-Image-0.1-Turbo
  89. 98Wan 2.6 Text to Image vs. SANA-1.5 1.6B 1024px
  90. 99Wan 2.6 Text to Image vs. SANA-1.5 4.8B 1024px
  91. 100Wan 2.6 Text to Image vs. Sana-Sprint 0.6B 1024px
  92. 101Wan 2.6 Text to Image vs. Sana-Sprint 1.6B 1024px
  93. 102Wan 2.6 Text to Image vs. Chroma1-HD
  94. 103Wan 2.6 Text to Image vs. Chroma1-Flash
  95. 104Wan 2.6 Text to Image vs. AuraFlow v0.3
  96. 105Wan 2.6 Text to Image vs. PixArt-Sigma-XL-2-1024-MS
  97. 106Wan 2.6 Text to Image vs. Lumina-Image 2.0
  98. 107Wan 2.6 Text to Image vs. HunyuanImage 3.0
  99. 108Wan 2.6 Text to Image vs. Z-Image Base

Alle technischen Daten

Ein- und Ausgabe

Maximale Ausgabe
2K
Quelle: Maximale Ausgabe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Proprietär
Quelle: Gewichte

Preise

Repräsentativer Preis
0,03 $ pro BildQuelle
Together AI (Wan-AI/Wan2.6-image)
0,03 $ pro MegapixelQuelle

Häufige Fragen zu Wan 2.6 Text to Image

Wie gut ist Wan 2.6 Text to Image?

In unserem eigenen Test Platz 44 von 108.

GraduallyBench vom 03.11.2026

GraduallyBenchunsere eigene Bewertung, 0 bis 100 · höher ist besser
Recraft V4.1 Utility65
FLUX.2 Pro65
MOSS-Image-SFT64
Wan 2.6 Text to ImagePlatz 44 von 10863
Ideogram 4.563
FLUX.2 Dev62
Seedream 4.062

Wofür eignet sich Wan 2.6 Text to Image?

Am besten für Figur und Details (79 von 100), am schwächsten bei Typografie und Layout (41).

GraduallyBench, je Aufgabe ein Bild

  1. Wan 2.6 Text to Image: Typografie und LayoutTypografie und LayoutLesbarer Text, Hierarchie und Komposition41von 100Platz 63 von 108 in dieser Aufgabe
  2. Wan 2.6 Text to Image: ProduktfotografieProduktfotografieMaterialien, Reflexionen und kleine Details54von 100Platz 52 von 108 in dieser Aufgabe
  3. Wan 2.6 Text to Image: Figur und DetailsFigur und DetailsAnatomie, Kleidung und räumliche Konsistenz79von 100Platz 9 von 108 in dieser Aufgabe
  4. Wan 2.6 Text to Image: InfografikInfografikZahlen, Beschriftungen und visuelle Ordnung77von 100Platz 20 von 108 in dieser Aufgabe

Was kostet ein Bild mit Wan 2.6 Text to Image?

Rund 0,03 $ je Bild. Das ist günstig: Ein typisches Bildmodell kostet 0,06 $.

Konfiguration: Text to Image

Preis je BildDollar je Bild · niedriger ist besser
FLUX.2 Klein 9B0,015 $
MAI-Image-2.6 Flash0,019 $
MAI-Image-2.5 Flash0,02 $
Wan 2.6 Text to ImagePlatz 6 von 280,03 $
FLUX.2 Pro0,03 $
Nano Banana 2 Lite0,034 $
Recraft V4.1 Utility0,035 $

Quellen und Datenstand

Alle 13 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.