Muse Wonder Full
Noch nicht getestet
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Muse Wonder Full | GLM-5.3-Flash |
|---|---|---|
| Anbieter | Meta | Z.ai |
| Erschienen | 12. Okt. 2026 | 26. Aug. 2026 |
| Verfügbarkeit | Nur im Abo | Open Source |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 320 Mrd., 18 Mrd. aktiv |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1 Mio. Token | 1.000.000 Token |
| Wissensstand | Nicht veröffentlicht | Nicht veröffentlicht |
| Technische Quellen | Modell, Kontext | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Muse Wonder Full | GLM-5.3-Flash |
|---|---|---|
| API-Eingabe | — | 0,15 $ |
| API-Ausgabe | — | 0,5 $ |
| Cache lesen | Nicht ausgewiesen | 0,03 $ |
| Cache schreiben (5 Min.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 15.10.2026 | 22.09.2026 Quelle |
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Für Muse Wonder Full ist im gespeicherten OpenRouter-Stand kein Anbietertarif verfügbar. Der offizielle Direktpreis wird trotzdem angezeigt.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| GLM-5.3-Flash | Z.ai | Direkt beim EntwicklerStandard-API | 0,15 $ | 0,5 $ | Quelle22.09.2026 |
| AtlasCloud | Über OpenRouteratlas-cloud/fp8 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp8 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp8/us | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| CoreWeave | Über OpenRoutercoreweave/nvfp4 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Crusoe | Über OpenRoutercrusoe/fp4 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Decart | Über OpenRouterdecart/fp4 | 0,093 $ | 0,31 $ | Quelle16.10.2026 | |
| DeepInfra | Über OpenRouterdeepinfra/fp4 | 0,075 $ | 0,25 $ | Quelle16.10.2026 | |
| DigitalOcean | Über OpenRouterdigitalocean | 0,1312 $ | 0,4375 $ | Quelle16.10.2026 | |
| Fireworks | Über OpenRouterfireworks | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Fireworks | Über OpenRouterfireworks/us | 0,225 $ | 0,75 $ | Quelle16.10.2026 | |
| Friendli | Über OpenRouterfriendli | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Inceptron | Über OpenRouterinceptron/fp8 | 0,0675 $ | 0,55 $ | Quelle16.10.2026 | |
| InferenceNet | Über OpenRouterinference-net/fp4 | 0,083 $ | 0,28 $ | Quelle16.10.2026 | |
| Makora | Über OpenRoutermakora | 0,14 $ | 0,47 $ | Quelle16.10.2026 | |
| Modal | Über OpenRoutermodal/nvfp4 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Morph | Über OpenRoutermorph/fp8 | 0,032 $ | 1 $ | Quelle16.10.2026 | |
| Near AI | Über OpenRouternear-ai/fp8 | 0,08 $ | 0,5 $ | Quelle16.10.2026 | |
| NextBit | Über OpenRouternextbit/fp4 | 0,25 $ | 0,7 $ | Quelle16.10.2026 | |
| Novita | Über OpenRouternovita/fp8 | 0,084 $ | 0,28 $ | Quelle16.10.2026 | |
| OpenInference | Über OpenRouteropen-inference/fp4 | 0,0225 $ | 0,9 $ | Quelle16.10.2026 | |
| Parasail | Über OpenRouterparasail/fast | 0,1875 $ | 0,625 $ | Quelle16.10.2026 | |
| Parasail | Über OpenRouterparasail/fp4 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Phala | Über OpenRouterphala/nvfp4 | 0,1125 $ | 0,375 $ | Quelle16.10.2026 | |
| Reka | Über OpenRouterreka | 0,07 $ | 1,8 $ | Quelle16.10.2026 | |
| Relace | Über OpenRouterrelace | Günstigster erfasster Preis: 0,0223 $ | 0,7124 $ | Quelle16.10.2026 | |
| Sail Research | Über OpenRoutersail-research/fp4 | 0,045 $ | 0,6 $ | Quelle16.10.2026 | |
| Sail Research | Über OpenRoutersail-research/us | 0,045 $ | 0,6 $ | Quelle16.10.2026 | |
| SiliconFlow | Über OpenRoutersiliconflow/fp8 | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| StreamLake | Über OpenRouterstreamlake/fp8 | 0,0435 $ | Günstigster erfasster Preis: 0,145 $ | Quelle16.10.2026 | |
| Together | Über OpenRoutertogether | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Venice | Über OpenRoutervenice | 0,15 $ | 0,5 $ | Quelle16.10.2026 | |
| Wafer | Über OpenRouterwafer | 0,12 $ | 0,5 $ | Quelle16.10.2026 | |
| Z.AI | Über OpenRouterz-ai/fp8 | 0,15 $ | 0,5 $ | Quelle16.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Muse Wonder Full | GLM-5.3-Flash | Quelle |
|---|---|---|---|
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert61,033 % | 20,515 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert73,631 % | 67,857 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert71,917 % | 55,932 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert59,061 % | 57,85 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert21,667 % | 6,667 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert79,833 % | 52,5 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert53,365 % | 45,192 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert87,418 % | 83,928 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 30.000 tokens | Höherer Messwert89,335 % | 88,936 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert0,5 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
ProofBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert94 % | 21 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SRE BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert11,832 % | 0,763 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Tax Agent BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert42,997 % | 31,55 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 4.0OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert58,081 % | 37,374 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert37,143 % | 2,857 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert64,566 % | 44,581 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vibe Code Bench 1-100OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.0Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: OpenHands, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert33,978 % | 16,033 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: OpenHands, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert85,996 % | 30,759 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert58,044 % | 7,354 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PatchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | 83,929 % | Höherer Messwert85,714 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBCompsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert80,89 % | 44,602 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert56,668 % | 53,193 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert94,928 % | 86,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2024TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert75,333 % | 53,167 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert63,636 % | 57,576 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchConclusion TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert90,323 % | 89,573 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert8 % | 7 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SRE BenchCapability ScoreTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: capability scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert17,748 % | 6,489 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert26,667 % | 10 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 4.0HardwareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert46,667 % | 20 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceEarth SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert62,5 % | 0 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexCode MigrationTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert60,256 % | 20,185 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Code MigrationCOBOLTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert70 % | 60 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PoCTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert63,333 % | 50 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBDataroomTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert85,257 % | 65,712 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)All-PassTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert49,037 % | 46,259 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert20 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2025TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert85,5 % | 56,667 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert92,809 % | 90,822 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchInterpretation TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert84,991 % | 79,508 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchFully ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert0,5 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SRE BenchFully SolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully solved rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert11,832 % | 0,763 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert76,097 % | 52,416 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 4.0MediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert58,333 % | 25 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceEngineering SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert11,111 % | 0 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexEMBTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert71,917 % | 55,932 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Code MigrationCode QualityTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: mean reviewer code-quality ratingBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | 4,244 / 5 | Höherer Messwert4,355 / 5 | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBDCFTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert66,579 % | 59,852 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)ComparablesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert46,809 % | 45,936 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert95,699 % | 89,606 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2026TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert78,667 % | 47,667 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchBusiness & Commercial · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert58,14 % | 44,186 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchIssue TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert91,014 % | 90,138 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
ProgramBenchRaw Pass RateTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: raw test pass rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | 24,187 % | Höherer Messwert48,609 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Tax Agent BenchCurrent & Temporal AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert56,614 % | 43,197 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Terminal-Bench 4.0MLTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert66,667 % | 51,515 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceLife SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert36,842 % | 5,263 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexFinance Agent v2TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert59,061 % | 57,85 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
EMBLBOTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert59,586 % | 48,015 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)Disclosure AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert71,553 % | 71,543 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert20 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchBusiness & Commercial · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | 89,811 % | Höherer Messwert91,27 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchRhetoric TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 128.000 tokens | Höherer Messwert83,625 % | 81,046 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Tax Agent BenchCurrent & Temporal AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserMuse Wonder Full: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens GLM-5.3-Flash: Reasoning: max, Temperatur: 1, Top P: 0.95, Ausgabegrenze: 131.072 tokens | Höherer Messwert78,312 % | 61,439 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.
Community-Klassiker für eine freie SVG-Zeichnung.
Muse Wonder Full
Noch nicht getestet
GLM-5.3-Flash
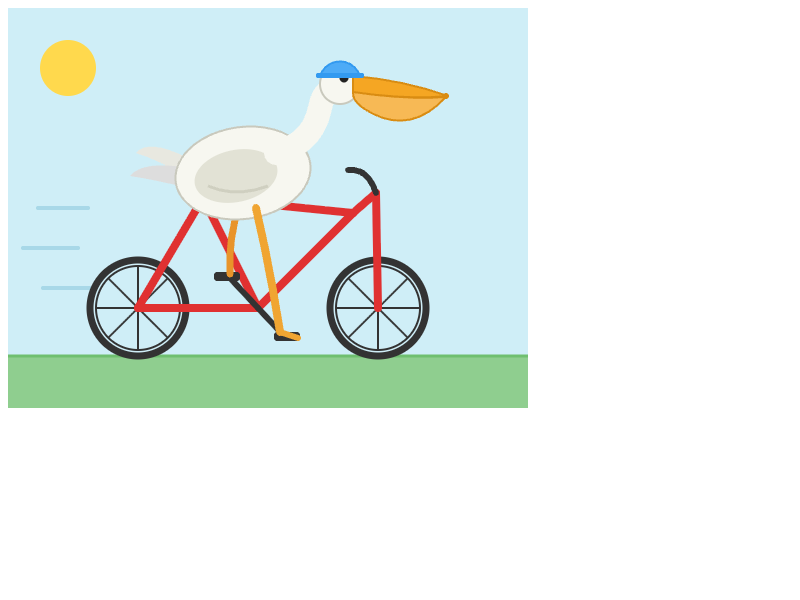
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Muse Wonder Full und GLM-5.3-Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.