Zum Hauptinhalt springen

xAIMistral AILLM-Duell

Grok 4.7vs.Mistral Large 3

Wer ist besser?

Grok 4.7 schneidet besser als Mistral Large 3 ab, aber kostet 4-mal so viel.

Grok 4.7 vorn
LeistungGesamtindex, 100 Punkte = Durchschnitt
103,4

Grok 4.7

Platz 21

38,8

Mistral Large 3

Platz 92

etwa gleich schnell
TempoToken pro Sekunde
71

Grok 4.7

78

Mistral Large 3

Mistral Large 3 günstiger
Preis$ je 1 Mio. Token
3 $

Grok 4.7

0,75 $

Mistral Large 3

Grok 4.7 beliebter
Beliebtheit0 bis 100
61

Grok 4.7

Platz 37 von 876

32

Mistral Large 3

Platz 420 von 876

Ab 200.000 Token im Kontext kostet Grok 4.7 mehr: 4 $ Eingabe und 12 $ Ausgabe je 1 Mio. Token.

Nimm Grok 4.7 für

GesundheitAgentenRechtProgrammierenMathematikWissenSchlussfolgernFinanzenAllgemeinMultimodal

Nimm Mistral Large 3 für

Kein klarer Vorteil

Wo liegt der Unterschied?

Stärken im Überblick

Grok 4.7Mistral Large 3Median aller Modelle mit Platz

507510012525ProgrammierenGrok 4.7SchlussfolgernGrok 4.7MathematikGrok 4.7WissenGrok 4.7AgentenGrok 4.7AllgemeinGrok 4.7MultimodalGrok 4.7FinanzenGrok 4.7RechtGrok 4.7GesundheitGrok 4.7
ProgrammierenGrok 4.7 vorn
Grok 4.7103,2Platz 22
Mistral Large 338,3Platz 104
Median aller Modelle mit Platz84,1

95-%-Bereich: Grok 4.7 100,2 bis 106,1, Mistral Large 3 29,0 bis 47,6.

BereichGrok 4.7Mistral Large 3

Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 25 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100.

Grok 4.7 liegt in 10 von 10 Bereichen vorn, Mistral Large 3 in keinem.

Grok 4.7 vorn: 10

Bereiche im Gesamtindex
AgentenGrok 4.7 +66107,4 zu 41,7
ProgrammierenGrok 4.7 +65103,2 zu 38,3
MathematikGrok 4.7 +6294,8 zu 32,9
WissenGrok 4.7 +62105,5 zu 43,7
SchlussfolgernGrok 4.7 +61102,2 zu 41,3
AllgemeinGrok 4.7 +59101,6 zu 42,8
MultimodalGrok 4.7 +5696,0 zu 40,0
Fachgebiete
GesundheitGrok 4.7 +67106,2 zu 39,3
RechtGrok 4.7 +65109,9 zu 44,5
FinanzenGrok 4.7 +60105,3 zu 45,7

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

3 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Cybersicherheitnur Grok 4.7 mit Wertung
Produktivitätnur Grok 4.7 mit Wertung
Bildungnur Grok 4.7 mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

Welches Modell für welche Aufgabe?

Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.

Code schreiben und Fehler findenGrok 4.7Programmieren 103,2 zu 38,3
Mathe und DatenanalyseGrok 4.7Mathematik 94,8 zu 32,9, Schlussfolgern 102,2 zu 41,3
Fakten und RechercheGrok 4.7Wissen 105,5 zu 43,7
Agenten und WorkflowsGrok 4.7Agenten 107,4 zu 41,7
Schnelle Antworten im Chatetwa gleich71 zu 78 Token pro Sekunde
SicherheitsanalysenoffenCybersicherheit ohne Wertung für Mistral Large 3
Viele Anfragen, kleines BudgetMistral Large 33 $ zu 0,75 $ je 1 Mio. Token
Finanz-, Rechts- und MedizintexteGrok 4.7Finanzen 105,3 zu 45,7, Recht 109,9 zu 44,5, Gesundheit 106,2 zu 39,3
Bilder, Screenshots und PDFsGrok 4.7Multimodal 96,0 zu 40,0

Selbst ansehen: gleicher Auftrag, ein Versuch

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

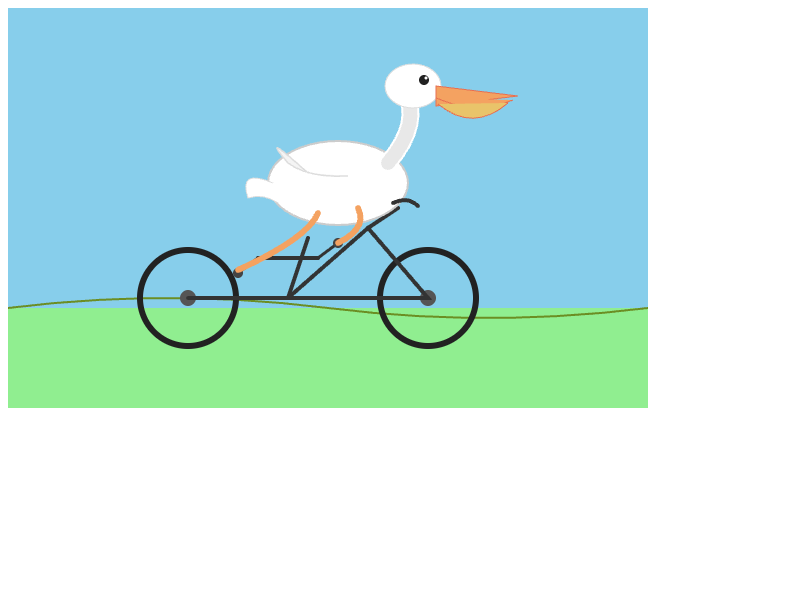
Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

Ursprung der Aufgabe: Simon Willison

Grok 4.7

Grok 4.7: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

01.10.2026 · 13 s · 0,0072 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
x-ai/grok-4.7
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
1.069 Token
Kosten des Versuchs
0,0072 $
Antwortzeit
13,4 s
API-Modell laut Antwort
x-ai/grok-4.7
Festgelegter Endpunkt
xAI | x-ai/grok-4.7-20260916
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)

  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high

Mistral Large 3
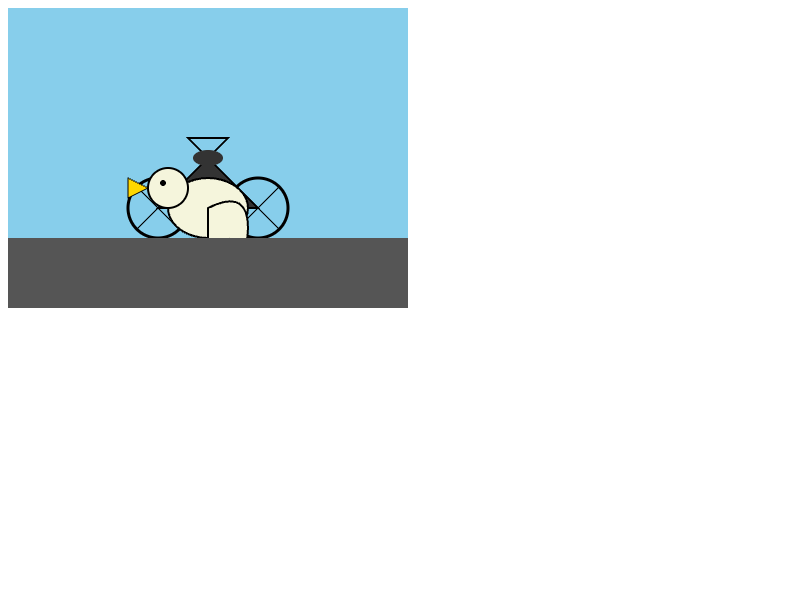
Mistral Large 3: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

01.10.2026 · 14 s · 0,0022 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
mistralai/mistral-large-2512
Reasoning-Einstellung
nicht vorgegeben
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
1.451 Token
Kosten des Versuchs
0,0022 $
Antwortzeit
14,2 s
API-Modell laut Antwort
mistralai/mistral-large-2512
Festgelegter Endpunkt
Mistral | mistralai/mistral-large-2512
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Reasoning (Modellstandard)
kein Reasoning-Modus Quelle

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)

  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: nicht vorgegeben
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

Grok 4.7

In dieser Runde nicht verfügbar

Mistral Large 3

API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.

Grok 4.7 und Mistral Large 3 im Gesamtindex

Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.

Gesamtindex (Gradually Meta-Score v4)

20 von 92 Modellen

6 Modelle dieser Auswahl sind im Gesamtindex mit einer niedrigeren Reasoning-Stufe als max gemessen. Gestrichelte Säule: niedrigere Reasoning-Stufe als die Spitze.

Claude Opus 5.5max126,1
Gemini 4 Carbonhigh125,8
Claude Fable 5.1max123,8
Claude Sonnet 5.5max122,8
Gemini 4 Argonhigh122,3
GPT-6 Astramax121,3
GPT-6.1 Solmax119,2
Muse Wonder Fullmax118,3
Claude Opus 5max117,2
Muse Wondermax113,4
Kimi K3.1 Promax112,9
Claude Fable 5max112,5
GPT-6 Solmax110,5
GPT-5.6 Solmax108,7
Muse Spark 1.3max107,4
Gemini 3.7 Flashhigh107,1
DeepSeek V4.1 Flash 1017max106,6
Gemini 3.8 Flashhigh106,5
Grok 4.7xhigh103,4
Mistral Large 3ohne38,8

Beliebtheit im Vergleich

Wie oft die Modelle gesucht, genutzt und erwähnt werden, auf einer Skala von 0 bis 100.

Grok 4.7 ist beliebter als Mistral Large 3: 61 zu 32 von 100.

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 6. November 2026

Grok 4.7Mistral Large 3

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlGrok 4.7Mistral Large 3
Leistung
GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser103,438,8
PlatzPlatz 21 von 92Platz 92 von 92
Preis je 1 Mio. Token
Eingabewas du schickst2 $über 200.000 Token: 4 $0,50 $
Ausgabewas das Modell schreibt6 $über 200.000 Token: 12 $1,50 $
Kosten je Aufgabe (eigene Tests)Durchschnitt aus 1 Aufgabe des ursprünglichen Testprotokolls, die beide Modelle bestanden haben (ohne SVG-Kurztest)0,007 $0,002 $
Tempo
Token pro Sekunde7178
Beliebtheit
BeliebtheitSuche, Nutzung und Erwähnungen, 0 bis 10061Platz 37 von 87632Platz 420 von 876
Technik
Kontextfensterwie viel Text das Modell auf einmal liest500.000 Token≈ 750 A4-Seiten262.144 Token≈ 390 A4-Seiten
WissensstandMai 2026k. A.
Veröffentlicht21.09.202602.12.2025
VerfügbarkeitAktivAktiv
Offene Gewichteneinja

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gibt es eine bessere Wahl?

Günstiger als Mistral Large 3DeepSeek V4.1 Flash 1017

Gesamtindex 106,6, Platz 170,15 $ Eingabe und 0,60 $ Ausgabe je 1 Mio. Token

Grok 4.7 vs. DeepSeek V4.1 Flash 1017
Bestes Modell im GesamtindexClaude Opus 5.5

Gesamtindex 126,1, Platz 14 $ Eingabe und 20 $ Ausgabe je 1 Mio. Token

Grok 4.7 vs. Claude Opus 5.5

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: Grok 4.7B: Mistral Large 3

LegalBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 84,4 %Mistral Large 3: 79,1 %Vals AIStand 13.10.2026
LMArena Code Arena WebDevOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.637Mistral Large 3: 1.233LMArenaStand 28.10.2026
LMArena Text, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.441Mistral Large 3: 1.414LMArenaStand 28.10.2026
LMArena Vision, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.250Mistral Large 3: 1.199LMArenaStand 19.10.2026
LegalBenchConclusion Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 88,6 %Mistral Large 3: 81,0 %Vals AIStand 13.10.2026
LMArena Code Arena WebDevHTML development · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.629Mistral Large 3: 1.241LMArenaStand 28.10.2026
LMArena Text, Style ControlBusiness, management and finance · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.437Mistral Large 3: 1.410LMArenaStand 28.10.2026
LMArena Vision, Style ControlChinese · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.267Mistral Large 3: 1.218LMArenaStand 19.10.2026
LegalBenchInterpretation Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 81,3 %Mistral Large 3: 76,6 %Vals AIStand 13.10.2026
LMArena Code Arena WebDevImage to WebDev · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.586Mistral Large 3: 1.361LMArenaStand 19.10.2026
36 weitere Benchmarks anzeigen
LMArena Text, Style ControlChinese · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.495Mistral Large 3: 1.432LMArenaStand 28.10.2026
LMArena Vision, Style ControlCreative writing with images · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.231Mistral Large 3: 1.197LMArenaStand 19.10.2026
LegalBenchIssue Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 89,5 %Mistral Large 3: 81,0 %Vals AIStand 13.10.2026
LMArena Code Arena WebDevWeb development · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.637Mistral Large 3: 1.233LMArenaStand 28.10.2026
LMArena Text, Style ControlCoding · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.494Mistral Large 3: 1.471LMArenaStand 28.10.2026
LMArena Vision, Style ControlDiagram understanding · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.280Mistral Large 3: 1.233LMArenaStand 19.10.2026
LegalBenchRhetoric Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 81,5 %Mistral Large 3: 77,9 %Vals AIStand 13.10.2026
LMArena Text, Style ControlCreative writing · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.418Mistral Large 3: 1.375LMArenaStand 28.10.2026
LMArena Vision, Style ControlEnglish · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.245Mistral Large 3: 1.209LMArenaStand 19.10.2026
LegalBenchRule Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 81,0 %Mistral Large 3: 79,1 %Vals AIStand 13.10.2026
LMArena Text, Style ControlEnglish · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.454Mistral Large 3: 1.427LMArenaStand 28.10.2026
LMArena Vision, Style ControlHomework · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.324Mistral Large 3: 1.206LMArenaStand 19.10.2026
LMArena Text, Style ControlEntertainment, sports and media · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.416Mistral Large 3: 1.373LMArenaStand 28.10.2026
LMArena Vision, Style ControlOptical character recognition · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.261Mistral Large 3: 1.214LMArenaStand 19.10.2026
LMArena Text, Style ControlExcluding ties · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.439Mistral Large 3: 1.402LMArenaStand 28.10.2026
LMArena Text, Style ControlExpert prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.480Mistral Large 3: 1.428LMArenaStand 28.10.2026
LMArena Text, Style ControlFrench prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.479Mistral Large 3: 1.432LMArenaStand 28.10.2026
LMArena Text, Style ControlGerman prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.431Mistral Large 3: 1.411LMArenaStand 28.10.2026
LMArena Text, Style ControlHard prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.463Mistral Large 3: 1.433LMArenaStand 28.10.2026
LMArena Text, Style ControlHard prompts, English · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.473Mistral Large 3: 1.440LMArenaStand 28.10.2026
LMArena Text, Style ControlInstruction following · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.438Mistral Large 3: 1.403LMArenaStand 28.10.2026
LMArena Text, Style ControlJapanese prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.408Mistral Large 3: 1.379LMArenaStand 28.10.2026
LMArena Text, Style ControlKorean prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.425Mistral Large 3: 1.358LMArenaStand 28.10.2026
LMArena Text, Style ControlLegal and government · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.464Mistral Large 3: 1.422LMArenaStand 28.10.2026
LMArena Text, Style ControlLife, physical and social science · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.469Mistral Large 3: 1.429LMArenaStand 28.10.2026
LMArena Text, Style ControlLonger queries · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.452Mistral Large 3: 1.418LMArenaStand 28.10.2026
LMArena Text, Style ControlMath · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.443Mistral Large 3: 1.401LMArenaStand 28.10.2026
LMArena Text, Style ControlMathematical professions · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.467Mistral Large 3: 1.414LMArenaStand 28.10.2026
LMArena Text, Style ControlMedicine and healthcare · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.459Mistral Large 3: 1.431LMArenaStand 28.10.2026
LMArena Text, Style ControlMulti-turn · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.432Mistral Large 3: 1.420LMArenaStand 28.10.2026
LMArena Text, Style ControlNon-English · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.428Mistral Large 3: 1.398LMArenaStand 28.10.2026
LMArena Text, Style ControlPolish prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.478Mistral Large 3: 1.415LMArenaStand 28.10.2026
LMArena Text, Style ControlRussian prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.435Mistral Large 3: 1.407LMArenaStand 28.10.2026
LMArena Text, Style ControlSoftware and IT services · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.478Mistral Large 3: 1.456LMArenaStand 28.10.2026
LMArena Text, Style ControlSpanish prompts · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.445Mistral Large 3: 1.408LMArenaStand 28.10.2026
LMArena Text, Style ControlWriting, literature and language · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 1.427Mistral Large 3: 1.390LMArenaStand 28.10.2026

Weitere Vergleiche

Vergleiche Grok 4.7 und Mistral Large 3 mit den Modellen, die am häufigsten mit ihnen verglichen werden.

Anderes Duell vergleichen

Die beliebtesten Vergleiche

  1. 1Gemini 3.8 Flash vs. Grok 4.7
  2. 2Grok 4.7 vs. GLM-5.3-Flash
  3. 3Claude Sonnet 5.5 vs. Grok 4.7
  4. 4Grok 4.7 vs. DeepSeek-V4.1-Flash
  5. 5Claude Haiku 5.5 vs. Grok 4.7
  6. 6Grok 4.7 vs. Kimi K3
  7. 7Gemini 4 Argon vs. Grok 4.7
  8. 8Grok 4.7 vs. DeepSeek V4.1 Flash 1017
  9. 9GPT-6 Luna vs. Grok 4.7
Alle 40 Vergleiche zeigen
  1. 10Claude Opus 4.8 vs. Grok 4.7
  2. 11Claude Opus 5.5 vs. Grok 4.7
  3. 12Claude Opus 5.5 vs. Mistral Large 3
  4. 13Grok 4.7 vs. DeepSeek-V4-Pro
  5. 14Claude Fable 5.1 vs. Grok 4.7
  6. 15Grok 4.7 vs. Grok 4.5
  7. 16GPT-5.6 Terra vs. Grok 4.7
  8. 17GLM-5.3 vs. Mistral Large 3
  9. 18GPT-6 Sol vs. Grok 4.7
  10. 19Claude Sonnet 4.6 vs. Grok 4.7
  11. 20Grok 4.7 vs. GLM-5.3
  12. 21GPT-5.6 Luna vs. Grok 4.7
  13. 22Grok 4.7 vs. Qwen 3.8 Max 0902
  14. 23Grok 4.7 vs. DeepSeek-V4-Flash
  15. 24Claude Opus 5 vs. Grok 4.7
  16. 25GPT-5.6 Sol vs. Grok 4.7
  17. 26Grok 4.7 vs. GLM-5.2
  18. 27Mistral Large 4 vs. Mistral Large 3
  19. 28Claude Sonnet 4.5 vs. Grok 4.7
  20. 29Gemini 3.1 Pro Preview vs. Grok 4.7
  21. 30Claude Haiku 5.5 vs. Mistral Large 3
  22. 31DeepSeek-V4-Flash vs. Mistral Large 3
  23. 32Claude Opus 4.7 vs. Grok 4.7
  24. 33DeepSeek V4.1 Flash 1017 vs. Mistral Large 3
  25. 34GPT-6.1 Sol vs. Grok 4.7
  26. 35Muse Wonder Full vs. Grok 4.7
  27. 36Claude Haiku 4.5 vs. Grok 4.7
  28. 37DeepSeek-V4.1-Flash vs. Mistral Large 3
  29. 38GPT-6.1 Terra vs. Grok 4.7
  30. 39Grok 4.7 vs. Kimi K3.1 Pro
  31. 40Gemini 4 Carbon vs. Grok 4.7