Zum Hauptinhalt springen

Direktvergleich

Grok 4.7 vs. GLM-5.3

Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.

gemeinsame Messreihen
20
verschiedene Benchmarks
20
jüngster Abruf
29.09.2026

Modellauswahl ändern

Steckbrief

Allgemeine Daten

Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.

Allgemeine Daten von Grok 4.7 und GLM-5.3
MerkmalGrok 4.7GLM-5.3
AnbieterxAIZ.ai
Erschienen21. Sept. 202618. Aug. 2026
VerfügbarkeitAktivAktiv
ModelltypProprietärOpen Weights
ParameterNicht veröffentlicht744 Mrd., 40 Mrd. aktiv
ArchitekturNicht veröffentlichtMixture of Experts
Kontextfenster500.000 Token1.000.000 Token
WissensstandMai 2026Nicht veröffentlicht
Technische QuellenModell, KontextModell, Kontext

Kosten

API-Preise im Vergleich

Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.

API-Preise von Grok 4.7 und GLM-5.3
PreisartGrok 4.7GLM-5.3
API-Eingabe2 $ ≤200K / 4 $ >200K1,4 $
API-Ausgabe6 $ ≤200K / 12 $ >200K4,4 $
Cache lesen0,5 $ ≤200K / 1 $ >200K0,26 $
Cache schreiben (5 Min.)Nicht ausgewiesenNicht ausgewiesen
Cache schreiben (1 Std.)Nicht ausgewiesenNicht ausgewiesen
Preis geprüft23.09.2026 Quelle22.09.2026 Quelle
Grok 4.7GLM-5.3
API-EingabeUSD pro 1 Mio. Token, Basistarif
Grok 4.72 $
GLM-5.3Günstiger1,4 $
API-AusgabeUSD pro 1 Mio. Token, Basistarif
Grok 4.76 $
GLM-5.3Günstiger4,4 $
Cache lesenUSD pro 1 Mio. Token, Basistarif
Grok 4.70,5 $
GLM-5.3Günstiger0,26 $

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Preise nach Anbieter

Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.

Anbieterpreise von Grok 4.7 und GLM-5.3
ModellAnbieterBezugsweg und TarifEingabe pro 1 Mio. TokenAusgabe pro 1 Mio. TokenQuelle
Grok 4.7xAIDirekt beim EntwicklerBis 200.000 Kontext-TokenGünstigster erfasster Preis: 2 $Günstigster erfasster Preis: 6 $Quelle23.09.2026
xAIDirekt beim EntwicklerÜber 200.000 Kontext-Token4 $12 $Quelle23.09.2026
xAIÜber OpenRouterxaiGünstigster erfasster Preis: 2 $Günstigster erfasster Preis: 6 $Quelle07.10.2026
xAIÜber OpenRouterxai/priority4 $12 $Quelle07.10.2026
xAIÜber OpenRouterxai/zdrGünstigster erfasster Preis: 2 $Günstigster erfasster Preis: 6 $Quelle07.10.2026
xAIÜber OpenRouterxai/zdr/priority4 $12 $Quelle07.10.2026
xAIÜber OpenRouterxai/zdr/us2,2 $6,6 $Quelle07.10.2026
GLM-5.3Z.aiDirekt beim EntwicklerStandard-API1,4 $4,4 $Quelle22.09.2026
AkashMLÜber OpenRouterakashml/fp80,19 $4,4 $Quelle07.10.2026
AlibabaÜber OpenRouteralibaba1,19 $3,74 $Quelle07.10.2026
AlibabaÜber OpenRouteralibaba/fast2,8 $8,8 $Quelle07.10.2026
AtlasCloudÜber OpenRouteratlas-cloud/fp81,4 $4,4 $Quelle07.10.2026
BaiduÜber OpenRouterbaidu/fp81,4 $4,4 $Quelle07.10.2026
BaseTenÜber OpenRouterbaseten/fast#12,1 $6,6 $Quelle07.10.2026
BaseTenÜber OpenRouterbaseten/fast#22,1 $6,6 $Quelle07.10.2026
BaseTenÜber OpenRouterbaseten/fp4#11,4 $4,4 $Quelle07.10.2026
BaseTenÜber OpenRouterbaseten/fp4#21,4 $4,4 $Quelle07.10.2026
CloudflareÜber OpenRoutercloudflare1,4 $4,4 $Quelle07.10.2026
CrusoeÜber OpenRoutercrusoe/fp41,4 $4,4 $Quelle07.10.2026
DecartÜber OpenRouterdecart/fp41,19 $3,74 $Quelle07.10.2026
DigitalOceanÜber OpenRouterdigitalocean0,91 $2,86 $Quelle07.10.2026
FireworksÜber OpenRouterfireworks1,4 $4,4 $Quelle07.10.2026
FireworksÜber OpenRouterfireworks/fast2,1 $6,6 $Quelle07.10.2026
FriendliÜber OpenRouterfriendli1,26 $3,96 $Quelle07.10.2026
GMICloudÜber OpenRoutergmicloud/fp80,98 $3,08 $Quelle07.10.2026
InceptronÜber OpenRouterinceptron/fp40,6 $3,39 $Quelle07.10.2026
InferenceNetÜber OpenRouterinference-net/fp40,18 $4,4 $Quelle07.10.2026
MistralÜber OpenRoutermistral/nvfp4#11,4 $4,4 $Quelle07.10.2026
MistralÜber OpenRoutermistral/nvfp4#21,54 $4,84 $Quelle07.10.2026
MistralÜber OpenRoutermistral/zdr1,4 $4,4 $Quelle07.10.2026
ModalÜber OpenRoutermodal1,4 $4,4 $Quelle07.10.2026
MorphÜber OpenRoutermorph/fp80,179 $3,553 $Quelle07.10.2026
NebiusÜber OpenRouternebius/fp41,4 $4,4 $Quelle07.10.2026
NovitaÜber OpenRouternovita/fp80,42 $Günstigster erfasster Preis: 1,32 $Quelle07.10.2026
ParasailÜber OpenRouterparasail/fp81,4 $4,4 $Quelle07.10.2026
PhalaÜber OpenRouterphala0,84 $2,64 $Quelle07.10.2026
PrimeIntellectÜber OpenRouterprimeintellect1,4 $4,4 $Quelle07.10.2026
RekaÜber OpenRouterreka0,17 $3 $Quelle07.10.2026
RelaceÜber OpenRouterrelaceGünstigster erfasster Preis: 0,06 $4,4 $Quelle07.10.2026
Sail ResearchÜber OpenRoutersail-research/fp80,2 $3,4 $Quelle07.10.2026
Sail ResearchÜber OpenRoutersail-research/us0,2 $3,4 $Quelle07.10.2026
SiliconFlowÜber OpenRoutersiliconflow/fp80,7 $2,2 $Quelle07.10.2026
TogetherÜber OpenRoutertogether1,4 $4,4 $Quelle07.10.2026
VeniceÜber OpenRoutervenice1,4 $4,4 $Quelle07.10.2026
WaferÜber OpenRouterwafer0,17 $7 $Quelle07.10.2026
WaferÜber OpenRouterwafer/us0,07 $7 $Quelle07.10.2026
Z.AIÜber OpenRouterz-ai/fp81,4 $4,4 $Quelle07.10.2026

Leistung

Gemeinsame Benchmarks

Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.

Fähigkeitsprofil aus vergleichbaren Benchmarks

Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.

255075100CodingMathematikFinanzenRechtAgenten-AufgabenProduktivitätCybersecurityGesundheit
Grok 4.7
GLM-5.3
Coding: 83,5 / 95,7 (5 Benchmarkfamilien)
Mathematik: 53,1 / 100 (1 Benchmarkfamilie)
Finanzen: 94,4 / 94,7 (3 Benchmarkfamilien)
Recht: 98,5 / 88,9 (3 Benchmarkfamilien)
Agenten-Aufgaben: 100 / 97,4 (1 Benchmarkfamilie)
Produktivität: 95,8 / 100 (1 Benchmarkfamilie)
Cybersecurity: 96,4 / 100 (1 Benchmarkfamilie)
Gesundheit: 100 / 92,9 (2 Benchmarkfamilien)

20 passende Messreihen aus 19 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 10 vergleichbaren Kategorien.

Grok 4.7GLM-5.3
Code MigrationOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner44,816 %
GLM-5.344,222 %
CyberBench v1.1Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.769,464 %
GLM-5.3Gewinner72,084 %
EMBOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner66,991 %
GLM-5.356,344 %
Finance Agent (v2)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.752,251 %
GLM-5.3Gewinner55,84 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner12,5 %
GLM-5.38,333 %
IOIOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.757,722 %
GLM-5.3Gewinner68,444 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.747,115 %
GLM-5.3Gewinner49,038 %
LegalBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.784,389 %
GLM-5.3Gewinner84,837 %
MedCodeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner49,553 %
GLM-5.342,864 %
MedScribeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner89,377 %
GLM-5.388,81 %
MysteryMechanismOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.7Gewinner25,225 %
GLM-5.322,973 %
ProgramBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.70,5 %
GLM-5.3Gewinner1,5 %

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Benchmarkwerte von Grok 4.7 und GLM-5.3
Benchmark und AufgabeGrok 4.7GLM-5.3Quelle
Code MigrationOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner44,816 %
44,222 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
CyberBench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
69,464 %
Gewinner72,084 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
EMBOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner66,991 %
56,344 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Finance Agent (v2)Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
52,251 %
Gewinner55,84 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Harvey's Legal Agent BenchmarkOverall · Task fully resolved
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besser
Gewinner12,5 %
8,333 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
IOIOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besser
57,722 %
Gewinner68,444 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Legal Research BenchOverall · All-pass
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besser
47,115 %
Gewinner49,038 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
LegalBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
84,389 %
Gewinner84,837 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
MedCodeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner49,553 %
42,864 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MedScribeOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner89,377 %
88,81 %
Vals AI
Quellendetails
Datenstand: 26.09.2026
MysteryMechanismOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner25,225 %
22,973 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
ProgramBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
0,5 %
Gewinner1,5 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
ProofBenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
26 %
Gewinner49 %
Vals AI
Quellendetails
Datenstand: 28.09.2026
Public Benefits Bench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besser
65,629 %
Gewinner68,539 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Tax Agent BenchOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
65,596 %
Gewinner73,089 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Terminal-Bench 2.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner73,408 %
71,536 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Terminal-Bench 4.0Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besser
Gewinner28,283 %
25,253 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Terminal-Bench ScienceOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besser
Gewinner11,429 %
4,286 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vals IndexOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: weighted index scoreBewertung: Mehr ist besser
Gewinner60,215 %
56,97 %
Vals AI
Quellendetails
Datenstand: 27.09.2026
Vibe Code Bench v1.1Overall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserEinstellungen: Harness: OpenHands
Gewinner86,175 %
78,125 %
Vals AI
Quellendetails
Datenstand: 27.09.2026

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Eigene Modelltests

Unsere Tests

Vergleiche, wie die Modelle denselben Prompt umsetzen. Angezeigt wird jeweils der aktuellste Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Frühere Läufe bleiben in den Testdetails erreichbar. Die Ergebnisse fließen nicht in einen Gesamtscore ein.

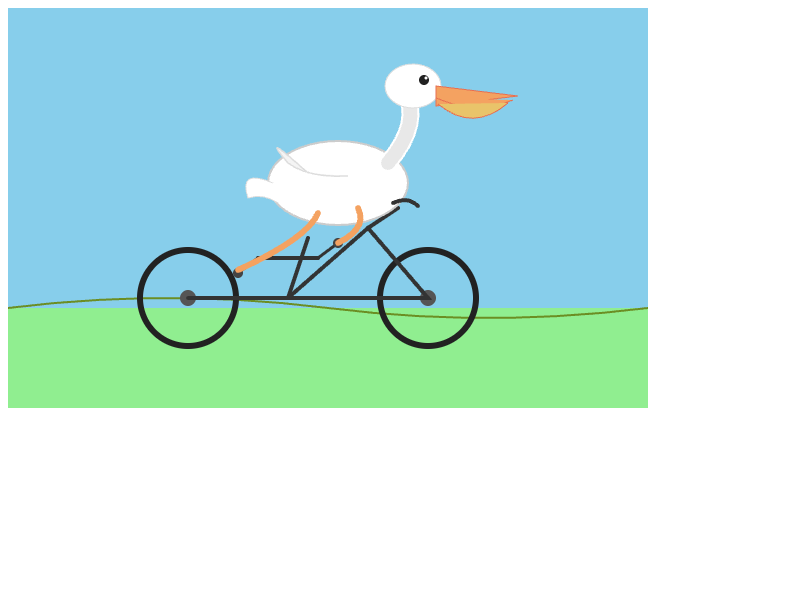
Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

Grok 4.7

Grok 4.7: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
x-ai/grok-4.7
API-Modell laut Antwort
x-ai/grok-4.7
Reasoning-Einstellung
high
Festgelegter Endpunkt
xAI | x-ai/grok-4.7-20260916
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
13,4 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
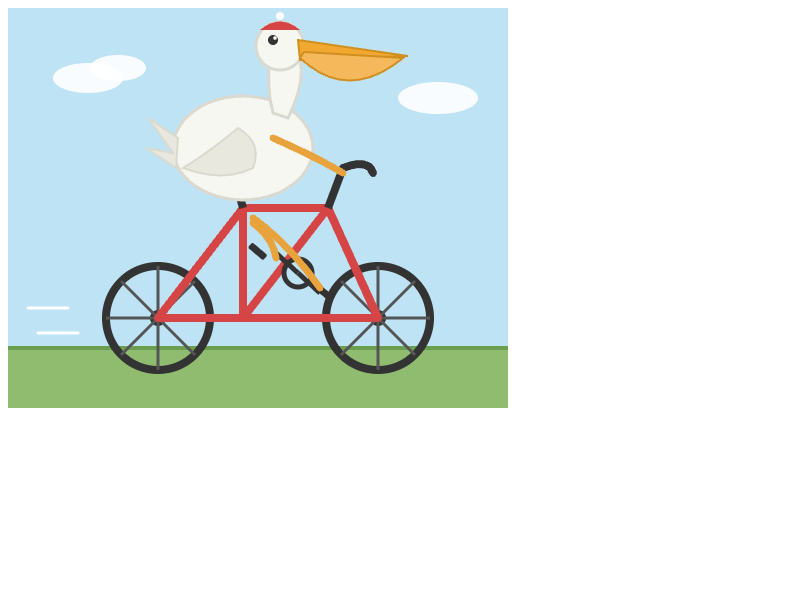
GLM-5.3

GLM-5.3: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
z-ai/glm-5.3
API-Modell laut Antwort
z-ai/glm-5.3
Reasoning-Einstellung
high
Festgelegter Endpunkt
Z.AI | z-ai/glm-5.3-20260816
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
20,4 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (2)
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)

So liest du den Vergleich

Ein Benchmark-Sieg ist kein Gesamturteil

Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.

Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.

Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.

Weitere Duelle

Vergleiche Grok 4.7 und GLM-5.3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.

Zum vollständigen LLM-Vergleich