Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
60
verschiedene Benchmarks
2
jüngster Abruf
29.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Allgemeine Daten von GPT-5.4 und DeepSeek-V4-Flash
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
GPT-5.4
DeepSeek-V4-Flash
Coding: 100 / 97,8 (1 Benchmarkfamilie)
Reasoning: 100 / 97,7 (1 Benchmarkfamilie)
Mathematik: 100 / 97 (1 Benchmarkfamilie)
Wissen: 100 / 97,9 (1 Benchmarkfamilie)
Finanzen: 100 / 97,2 (1 Benchmarkfamilie)
Recht: 100 / 98 (1 Benchmarkfamilie)
Cybersecurity: 100 / 91,9 (1 Benchmarkfamilie)
Gesundheit: 100 / 99,3 (1 Benchmarkfamilie)
60 passende Messreihen aus 2 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 9 vergleichbaren Kategorien.
GPT-5.4DeepSeek-V4-Flash
CyberBench v1.1Patch. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner81,356 %
DeepSeek-V4-Flash72,414 %
LMArena Text, Style ControlOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.464,964
DeepSeek-V4-Flash1.436,082
CyberBench v1.1PoC. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner64,407 %
DeepSeek-V4-Flash61,017 %
LMArena Text, Style ControlOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.475,198
DeepSeek-V4-Flash1.438,511
LMArena Text, Style ControlBusiness, management and finance. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.474,623
DeepSeek-V4-Flash1.438,526
LMArena Text, Style ControlBusiness, management and finance. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.481,559
DeepSeek-V4-Flash1.434,189
LMArena Text, Style ControlChinese. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.493,153
DeepSeek-V4-Flash1.471,267
LMArena Text, Style ControlChinese. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.506,812
DeepSeek-V4-Flash1.479,924
LMArena Text, Style ControlCoding. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.511,177
DeepSeek-V4-Flash1.484,094
LMArena Text, Style ControlCoding. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.520,571
DeepSeek-V4-Flash1.479,555
LMArena Text, Style ControlCreative writing. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.434,479
DeepSeek-V4-Flash1.407,791
LMArena Text, Style ControlCreative writing. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-5.4Gewinner1.442,663
DeepSeek-V4-Flash1.410,703
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 67.632 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 51.871 anonymen Paarvergleichen.
Gewinner1.464,964
95-%-Konfidenzintervall: ±3,702Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.436,082
95-%-Konfidenzintervall: ±4,048Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 64.479 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 51.747 anonymen Paarvergleichen.
Gewinner1.475,198
95-%-Konfidenzintervall: ±3,778Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.438,511
95-%-Konfidenzintervall: ±4,115Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 13.882 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 10.436 anonymen Paarvergleichen.
Gewinner1.474,623
95-%-Konfidenzintervall: ±6,376Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.438,526
95-%-Konfidenzintervall: ±6,971Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 13.092 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 10.641 anonymen Paarvergleichen.
Gewinner1.481,559
95-%-Konfidenzintervall: ±6,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.434,189
95-%-Konfidenzintervall: ±6,982Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 4.364 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.996 anonymen Paarvergleichen.
Gewinner1.493,153
95-%-Konfidenzintervall: ±9,833Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.471,267
95-%-Konfidenzintervall: ±11,424Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 4.159 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.992 anonymen Paarvergleichen.
Gewinner1.506,812
95-%-Konfidenzintervall: ±10,001Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.479,924
95-%-Konfidenzintervall: ±11,42Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 18.919 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 15.262 anonymen Paarvergleichen.
Gewinner1.511,177
95-%-Konfidenzintervall: ±5,805Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.484,094
95-%-Konfidenzintervall: ±6,23Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 17.577 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 15.239 anonymen Paarvergleichen.
Gewinner1.520,571
95-%-Konfidenzintervall: ±5,854Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.479,555
95-%-Konfidenzintervall: ±6,265Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 11.135 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 8.539 anonymen Paarvergleichen.
Gewinner1.434,479
95-%-Konfidenzintervall: ±6,844Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.407,791
95-%-Konfidenzintervall: ±7,543Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 10.894 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 8.638 anonymen Paarvergleichen.
Gewinner1.442,663
95-%-Konfidenzintervall: ±6,988Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.410,703
95-%-Konfidenzintervall: ±7,575Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 30.587 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 23.008 anonymen Paarvergleichen.
Gewinner1.468,151
95-%-Konfidenzintervall: ±4,916Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.444,92
95-%-Konfidenzintervall: ±5,29Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 28.991 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 22.908 anonymen Paarvergleichen.
Gewinner1.476,387
95-%-Konfidenzintervall: ±4,966Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.449,94
95-%-Konfidenzintervall: ±5,323Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlEntertainment, sports and mediaTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 14.616 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 11.179 anonymen Paarvergleichen.
Gewinner1.432,028
95-%-Konfidenzintervall: ±6,282Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.404,567
95-%-Konfidenzintervall: ±6,937Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlEntertainment, sports and mediaTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 13.917 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 11.428 anonymen Paarvergleichen.
Gewinner1.441,47
95-%-Konfidenzintervall: ±6,441Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.408,063
95-%-Konfidenzintervall: ±6,896Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 51.980 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 39.226 anonymen Paarvergleichen.
Gewinner1.471,069
95-%-Konfidenzintervall: ±4,836Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.431,809
95-%-Konfidenzintervall: ±5,308Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 49.393 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 39.391 anonymen Paarvergleichen.
Gewinner1.484,279
95-%-Konfidenzintervall: ±4,933Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.436,008
95-%-Konfidenzintervall: ±5,353Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 6.707 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 5.392 anonymen Paarvergleichen.
Gewinner1.492,198
95-%-Konfidenzintervall: ±8,255Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.457,264
95-%-Konfidenzintervall: ±8,778Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 6.334 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 5.311 anonymen Paarvergleichen.
Gewinner1.514,737
95-%-Konfidenzintervall: ±8,393Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.466,306
95-%-Konfidenzintervall: ±8,867Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 2.420 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.006 anonymen Paarvergleichen.
Gewinner1.485,522
95-%-Konfidenzintervall: ±14,25Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.448,483
95-%-Konfidenzintervall: ±15,039Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 2.403 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 1.966 anonymen Paarvergleichen.
Gewinner1.499,866
95-%-Konfidenzintervall: ±14,273Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.459,263
95-%-Konfidenzintervall: ±15,286Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.001 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 843 anonymen Paarvergleichen.
Kein klarer Vorsprung1.449,588
95-%-Konfidenzintervall: ±19,823Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.424,769
95-%-Konfidenzintervall: ±21,221Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.092 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 906 anonymen Paarvergleichen.
Gewinner1.476,158
95-%-Konfidenzintervall: ±19,045Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.433,595
95-%-Konfidenzintervall: ±20,539Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 44.698 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 34.753 anonymen Paarvergleichen.
Gewinner1.487,189
95-%-Konfidenzintervall: ±4,475Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.458,919
95-%-Konfidenzintervall: ±4,767Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 42.103 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 34.700 anonymen Paarvergleichen.
Gewinner1.496,664
95-%-Konfidenzintervall: ±4,521Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.458,083
95-%-Konfidenzintervall: ±4,832Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 21.002 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 16.176 anonymen Paarvergleichen.
Gewinner1.486,858
95-%-Konfidenzintervall: ±5,628Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.463,433
95-%-Konfidenzintervall: ±6,065Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 19.649 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 16.039 anonymen Paarvergleichen.
Gewinner1.493,158
95-%-Konfidenzintervall: ±5,688Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.464,61
95-%-Konfidenzintervall: ±6,133Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 23.384 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 17.961 anonymen Paarvergleichen.
Gewinner1.460,276
95-%-Konfidenzintervall: ±5,39Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.428,187
95-%-Konfidenzintervall: ±5,811Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 21.896 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 18.051 anonymen Paarvergleichen.
Gewinner1.471,171
95-%-Konfidenzintervall: ±5,474Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.433,413
95-%-Konfidenzintervall: ±5,881Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 681 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 647 anonymen Paarvergleichen.
Kein klarer Vorsprung1.445,374
95-%-Konfidenzintervall: ±24,201Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.398,363
95-%-Konfidenzintervall: ±24,906Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 671 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 635 anonymen Paarvergleichen.
Gewinner1.479,239
95-%-Konfidenzintervall: ±24,937Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.424,242
95-%-Konfidenzintervall: ±25,166Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.161 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 898 anonymen Paarvergleichen.
Kein klarer Vorsprung1.425,994
95-%-Konfidenzintervall: ±19,269Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.392,925
95-%-Konfidenzintervall: ±20,977Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.107 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 951 anonymen Paarvergleichen.
Gewinner1.433,931
95-%-Konfidenzintervall: ±19,893Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.378,153
95-%-Konfidenzintervall: ±20,872Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLegal and governmentTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 5.387 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 4.139 anonymen Paarvergleichen.
Gewinner1.475,748
95-%-Konfidenzintervall: ±9,028Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.447,478
95-%-Konfidenzintervall: ±9,874Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLegal and governmentTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 5.240 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 4.107 anonymen Paarvergleichen.
Gewinner1.489,844
95-%-Konfidenzintervall: ±9,116Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.457,491
95-%-Konfidenzintervall: ±9,927Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLife, physical and social scienceTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 11.096 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 8.423 anonymen Paarvergleichen.
Gewinner1.478,774
95-%-Konfidenzintervall: ±6,725Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.456,345
95-%-Konfidenzintervall: ±7,388Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLife, physical and social scienceTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 10.659 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 8.509 anonymen Paarvergleichen.
Gewinner1.487,593
95-%-Konfidenzintervall: ±6,842Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.459,724
95-%-Konfidenzintervall: ±7,418Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 29.890 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 23.359 anonymen Paarvergleichen.
Gewinner1.477,734
95-%-Konfidenzintervall: ±5,219Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.447,83
95-%-Konfidenzintervall: ±5,578Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 28.372 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 23.501 anonymen Paarvergleichen.
Gewinner1.481,678
95-%-Konfidenzintervall: ±5,295Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.448,636
95-%-Konfidenzintervall: ±5,577Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 3.551 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.688 anonymen Paarvergleichen.
Gewinner1.459,714
95-%-Konfidenzintervall: ±10,346Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.425,467
95-%-Konfidenzintervall: ±11,801Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 3.387 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.619 anonymen Paarvergleichen.
Gewinner1.491,354
95-%-Konfidenzintervall: ±10,6Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.441,412
95-%-Konfidenzintervall: ±11,893Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 3.730 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.975 anonymen Paarvergleichen.
Gewinner1.472,941
95-%-Konfidenzintervall: ±10,457Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.434,489
95-%-Konfidenzintervall: ±11,462Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 3.546 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 2.828 anonymen Paarvergleichen.
Gewinner1.499,27
95-%-Konfidenzintervall: ±10,639Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.445,003
95-%-Konfidenzintervall: ±11,761Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlMedicine and healthcareTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 5.046 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 3.699 anonymen Paarvergleichen.
Kein klarer Vorsprung1.466,482
95-%-Konfidenzintervall: ±9,337Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.459,257
95-%-Konfidenzintervall: ±10,503Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlMedicine and healthcareTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 4.826 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 3.774 anonymen Paarvergleichen.
Kein klarer Vorsprung1.474,929
95-%-Konfidenzintervall: ±9,555Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.461,307
95-%-Konfidenzintervall: ±10,453Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 12.664 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 9.363 anonymen Paarvergleichen.
Gewinner1.480,155
95-%-Konfidenzintervall: ±6,57Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.453,414
95-%-Konfidenzintervall: ±7,284Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 11.982 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 9.233 anonymen Paarvergleichen.
Gewinner1.492,905
95-%-Konfidenzintervall: ±6,641Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.446,332
95-%-Konfidenzintervall: ±7,34Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 37.043 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 28.862 anonymen Paarvergleichen.
Gewinner1.456,722
95-%-Konfidenzintervall: ±4,588Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.423,239
95-%-Konfidenzintervall: ±4,947Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 35.486 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 28.837 anonymen Paarvergleichen.
Gewinner1.468,109
95-%-Konfidenzintervall: ±4,642Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.423,125
95-%-Konfidenzintervall: ±5,023Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.304 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 1.030 anonymen Paarvergleichen.
Kein klarer Vorsprung1.471,709
95-%-Konfidenzintervall: ±16,827Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.438,601
95-%-Konfidenzintervall: ±18,712Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 1.322 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 1.037 anonymen Paarvergleichen.
Gewinner1.481,38
95-%-Konfidenzintervall: ±16,86Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.434,977
95-%-Konfidenzintervall: ±18,457Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 7.658 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 5.750 anonymen Paarvergleichen.
Gewinner1.469,597
95-%-Konfidenzintervall: ±7,678Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.433,519
95-%-Konfidenzintervall: ±8,502Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 7.218 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 5.790 anonymen Paarvergleichen.
Gewinner1.487,106
95-%-Konfidenzintervall: ±7,885Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.437,327
95-%-Konfidenzintervall: ±8,593Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlSoftware and IT servicesTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 26.958 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 21.360 anonymen Paarvergleichen.
Gewinner1.498,74
95-%-Konfidenzintervall: ±5,151Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.470,864
95-%-Konfidenzintervall: ±5,508Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlSoftware and IT servicesTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 25.454 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 21.329 anonymen Paarvergleichen.
Gewinner1.506,553
95-%-Konfidenzintervall: ±5,185Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.472,722
95-%-Konfidenzintervall: ±5,539Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 2.067 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 1.596 anonymen Paarvergleichen.
Kein klarer Vorsprung1.461,197
95-%-Konfidenzintervall: ±14,33Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.433,099
95-%-Konfidenzintervall: ±16,059Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 2.086 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 1.497 anonymen Paarvergleichen.
Kein klarer Vorsprung1.454,845
95-%-Konfidenzintervall: ±14,273Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.429,802
95-%-Konfidenzintervall: ±16,45Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlWriting, literature and languageTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 16.553 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 12.557 anonymen Paarvergleichen.
Gewinner1.458,352
95-%-Konfidenzintervall: ±5,94Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.415,672
95-%-Konfidenzintervall: ±6,557Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlWriting, literature and languageTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.4: Snapshot: gpt-5.4-high, Reasoning: high, Harness: Arena text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena text, style controlGPT-5.4: Stilbereinigte Arena-Bewertung aus 16.142 anonymen Paarvergleichen.DeepSeek-V4-Flash: Stilbereinigte Arena-Bewertung aus 12.763 anonymen Paarvergleichen.
Gewinner1.464,687
95-%-Konfidenzintervall: ±5,995Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.422,277
95-%-Konfidenzintervall: ±6,549Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Unsere Tests
Vergleiche, wie die Modelle denselben Prompt umsetzen. Angezeigt wird jeweils der aktuellste Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Frühere Läufe bleiben in den Testdetails erreichbar. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
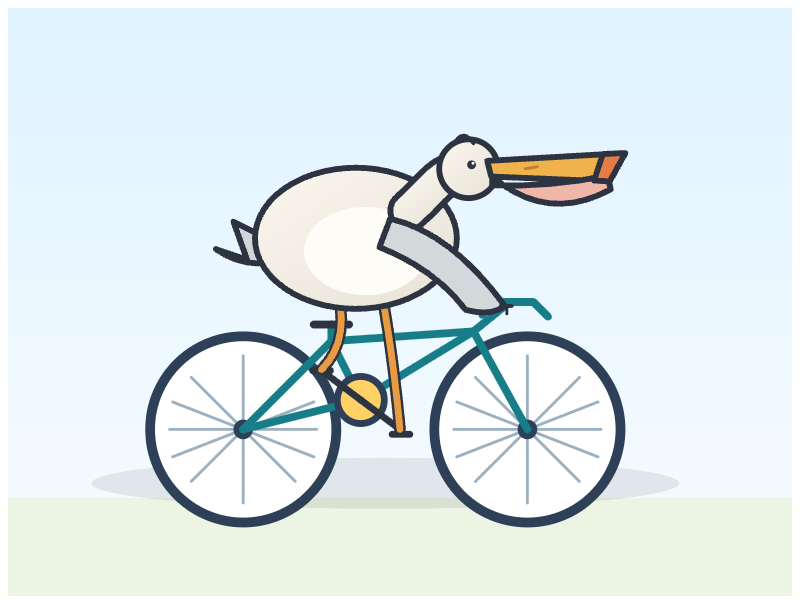
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-5.4
Community-Klassiker für eine freie SVG-Zeichnung.
Reasoning (angefragt): high
Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.4
API-Modell laut Antwort
openai/gpt-5.4
Reasoning-Einstellung
high
Festgelegter Endpunkt
OpenAI | openai/gpt-5.4-20260305
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
116,8 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Frühere Versuche (1)
07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
DeepSeek-V4-Flash
Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.
Reasoning (angefragt): high
Aktueller Versuch
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
deepseek/deepseek-v4-flash-0731
API-Modell laut Antwort
deepseek/deepseek-v4-flash-0731
Reasoning-Einstellung
high
Festgelegter Endpunkt
StreamLake | deepseek/deepseek-v4-flash-20260731
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden
Antwortzeit
117,6 s
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Frühere Versuche (2)
01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche GPT-5.4 und DeepSeek-V4-Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.