Muse Spark 1.3
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Muse Spark 1.3 | DeepSeek-V4-Flash |
|---|---|---|
| Anbieter | Meta | DeepSeek |
| Erschienen | 2. Sept. 2026 | 24. Apr. 2026 |
| Verfügbarkeit | Aktiv | Eingeschränkter Zugang |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 284 Mrd., 13 Mrd. aktiv |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1.048.576 Token | 1.000.000 Token |
| Wissensstand | Nicht veröffentlicht | Nicht veröffentlicht |
| Technische Quellen | Modell, Kontext | Modell |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Muse Spark 1.3 | DeepSeek-V4-Flash |
|---|---|---|
| API-Eingabe | 1,25 $ | 0,13 $ |
| API-Ausgabe | 4,25 $ | 0,28 $ |
| Cache lesen | 0,15 $ | Nicht ausgewiesen |
| Cache schreiben (5 Min.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | Nicht ausgewiesen | Nicht ausgewiesen |
| Preis geprüft | 18.10.2026 Quelle | 18.10.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Muse Spark 1.3 | Meta | Über OpenRoutermeta | Günstigster erfasster Preis: 1,25 $ | Günstigster erfasster Preis: 4,25 $ | Quelle18.10.2026 |
| DeepSeek-V4-Flash | Alibaba | Über OpenRouteralibaba | 0,352 $ | 1,056 $ | Quelle18.10.2026 |
| Alibaba | Über OpenRouteralibaba/us-east-1 | 0,374 $ | 1,122 $ | Quelle18.10.2026 | |
| AtlasCloud | Über OpenRouteratlas-cloud/fp4 | 0,44 $ | 1,32 $ | Quelle18.10.2026 | |
| Baidu | Über OpenRouterbaidu/fp8 | 0,0598 $ | 0,1795 $ | Quelle18.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp32 | 0,13 $ | 0,26 $ | Quelle18.10.2026 | |
| BaseTen | Über OpenRouterbaseten/fp8 | 0,13 $ | 0,26 $ | Quelle18.10.2026 | |
| Cloudflare | Über OpenRoutercloudflare | 0,44 $ | 1,32 $ | Quelle18.10.2026 | |
| Cohere | Über OpenRoutercohere | 0,14 $ | 0,28 $ | Quelle18.10.2026 | |
| CoreWeave | Über OpenRoutercoreweave/fp8 | 0,13 $ | 0,28 $ | Quelle18.10.2026 | |
| DeepInfra | Über OpenRouterdeepinfra/fp8 | 0,06 $ | 0,18 $ | Quelle18.10.2026 | |
| DigitalOcean | Über OpenRouterdigitalocean | 0,119 $ | 0,238 $ | Quelle18.10.2026 | |
| GMICloud | Über OpenRoutergmicloud/fp8 | 0,286 $ | 0,858 $ | Quelle18.10.2026 | |
| Inceptron | Über OpenRouterinceptron/fp4 | 0,13 $ | 0,4782 $ | Quelle18.10.2026 | |
| Mancer 2 | Über OpenRoutermancer/fp8 | 0,2 $ | 0,6 $ | Quelle18.10.2026 | |
| Novita | Über OpenRouternovita/fp8 | 0,4092 $ | 1,2276 $ | Quelle18.10.2026 | |
| OpenInference | Über OpenRouteropen-inference/fp4 | 0,0091 $ | Günstigster erfasster Preis: 0,1436 $ | Quelle18.10.2026 | |
| Parasail | Über OpenRouterparasail/fp8 | 0,14 $ | 0,28 $ | Quelle18.10.2026 | |
| Phala | Über OpenRouterphala | 0,308 $ | 0,924 $ | Quelle18.10.2026 | |
| Reka | Über OpenRouterreka | 0,021 $ | 0,528 $ | Quelle18.10.2026 | |
| Relace | Über OpenRouterrelace/fp4 | Günstigster erfasster Preis: 0,0086 $ | 0,45 $ | Quelle18.10.2026 | |
| Sail Research | Über OpenRoutersail-research/fp4 | 0,1 $ | 0,3 $ | Quelle18.10.2026 | |
| Sail Research | Über OpenRoutersail-research/us | 0,1 $ | 0,3 $ | Quelle18.10.2026 | |
| SiliconFlow | Über OpenRoutersiliconflow/fp8 | 0,22 $ | 0,66 $ | Quelle18.10.2026 | |
| StreamLake | Über OpenRouterstreamlake/fp8 | 0,088 $ | 0,264 $ | Quelle18.10.2026 | |
| Together | Über OpenRoutertogether | 0,14 $ | 0,28 $ | Quelle18.10.2026 | |
| Venice | Über OpenRoutervenice | 0,13 $ | 0,26 $ | Quelle18.10.2026 | |
| Wafer | Über OpenRouterwafer/fast | 0,13 $ | 0,23 $ | Quelle18.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
9 passende Messreihen aus 9 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 5 von 5 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Muse Spark 1.3 | DeepSeek-V4-Flash | Quelle |
|---|---|---|---|
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner1.581,34 elo | 1.258,64 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner83,0 % | 79,7 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner25 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | -14,283 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner48,092 Punkte | 34,331 Punkte | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner57,9 % | 54,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner26,6 % | 11,0 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner1.680,99 elo | 1.433,74 elo | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner48,7 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | 38,6 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3 (xHigh), Reasoning: xhigh, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 7.987 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.152 veröffentlichten Paarvergleichen. | Höherer Messwert1.621,927 95-%-Konfidenzintervall: ±8,096Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.430,632 95-%-Konfidenzintervall: ±6,942Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 16.731 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 52.016 veröffentlichten Paarvergleichen. | Höherer Messwert1.494,213 95-%-Konfidenzintervall: ±5,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.435,976 95-%-Konfidenzintervall: ±4,036Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Terminal-BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: Task successBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: Muse Spark 1.3 (Max), Reasoning: Max DeepSeek-V4-Flash: Snapshot: DeepSeek V4 Flash 0731 (Max), Reasoning: MaxMuse Spark 1.3: Exakte AA-Konfiguration: Muse Spark 1.3 (Max) (Release muse-spark-1-3, Zeile muse-spark-1-3, UUID 9999672c-b687-4026-9c15-5cef02ff53bb, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.DeepSeek-V4-Flash: Exakte AA-Konfiguration: DeepSeek V4 Flash 0731 (Max) (Release deepseek-v4-flash, Zeile deepseek-v4-flash, UUID fe4c0848-e284-4e52-a79d-cdc28392f1a9, reasoning=true, source reasoning-token configuration budget=2000, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner33,3 % | 12,1 % | Artificial AnalysisQuellendetailsDatenstand: 15.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 8.683 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.152 veröffentlichten Paarvergleichen. | Höherer Messwert1.658,54 95-%-Konfidenzintervall: ±8,09Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.430,632 95-%-Konfidenzintervall: ±6,942Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 16.731 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 51.814 veröffentlichten Paarvergleichen. | Höherer Messwert1.494,213 95-%-Konfidenzintervall: ±5,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.438,654 95-%-Konfidenzintervall: ±4,106Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3 (xHigh), Reasoning: xhigh, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 7.987 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.152 veröffentlichten Paarvergleichen. | Höherer Messwert1.621,927 95-%-Konfidenzintervall: ±8,096Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.430,632 95-%-Konfidenzintervall: ±6,942Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 3.041 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.448 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,61 95-%-Konfidenzintervall: ±11,102Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.438,829 95-%-Konfidenzintervall: ±6,961Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 8.683 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.152 veröffentlichten Paarvergleichen. | Höherer Messwert1.658,54 95-%-Konfidenzintervall: ±8,09Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.430,632 95-%-Konfidenzintervall: ±6,942Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 3.041 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 10.643 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,61 95-%-Konfidenzintervall: ±11,102Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.434,084 95-%-Konfidenzintervall: ±6,963Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3 (xHigh), Reasoning: xhigh, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 1.195 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 1.165 veröffentlichten Paarvergleichen. | Höherer Messwert1.627,36 95-%-Konfidenzintervall: ±19,007Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.416,219 95-%-Konfidenzintervall: ±18,033Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.298 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 3.005 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,417 95-%-Konfidenzintervall: ±16,859Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.470,018 95-%-Konfidenzintervall: ±11,382Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 1.196 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 1.165 veröffentlichten Paarvergleichen. | Höherer Messwert1.657,124 95-%-Konfidenzintervall: ±19,59Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.416,219 95-%-Konfidenzintervall: ±18,033Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.298 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.975 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,417 95-%-Konfidenzintervall: ±16,859Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.480,516 95-%-Konfidenzintervall: ±11,412Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdev-reactTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3 (xHigh), Reasoning: xhigh, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 5.098 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.109 veröffentlichten Paarvergleichen. | Höherer Messwert1.630,932 95-%-Konfidenzintervall: ±9,812Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.421,593 95-%-Konfidenzintervall: ±7,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.357 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 15.290 veröffentlichten Paarvergleichen. | Höherer Messwert1.536,661 95-%-Konfidenzintervall: ±9,472Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.484,301 95-%-Konfidenzintervall: ±6,214Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Code Arena WebDevWebdev-reactTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Code Arena WebDev DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Code Arena WebDevMuse Spark 1.3: Arena-Bewertung aus 5.603 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.109 veröffentlichten Paarvergleichen. | Höherer Messwert1.670,223 95-%-Konfidenzintervall: ±9,509Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.421,593 95-%-Konfidenzintervall: ±7,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.357 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 15.245 veröffentlichten Paarvergleichen. | Höherer Messwert1.536,661 95-%-Konfidenzintervall: ±9,472Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.479,463 95-%-Konfidenzintervall: ±6,25Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 3.666 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.595 veröffentlichten Paarvergleichen. | Höherer Messwert1.460,856 95-%-Konfidenzintervall: ±10,701Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.408,246 95-%-Konfidenzintervall: ±7,512Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 3.666 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.668 veröffentlichten Paarvergleichen. | Höherer Messwert1.460,856 95-%-Konfidenzintervall: ±10,701Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.410,845 95-%-Konfidenzintervall: ±7,548Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 6.647 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 23.136 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,366 95-%-Konfidenzintervall: ±7,853Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.445,189 95-%-Konfidenzintervall: ±5,273Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 6.647 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 23.022 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,366 95-%-Konfidenzintervall: ±7,853Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.449,707 95-%-Konfidenzintervall: ±5,31Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.323 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 11.221 veröffentlichten Paarvergleichen. | Höherer Messwert1.457,32 95-%-Konfidenzintervall: ±9,849Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.404,55 95-%-Konfidenzintervall: ±6,918Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.323 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 11.460 veröffentlichten Paarvergleichen. | Höherer Messwert1.457,32 95-%-Konfidenzintervall: ±9,849Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.407,781 95-%-Konfidenzintervall: ±6,873Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 12.251 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 39.351 veröffentlichten Paarvergleichen. | Höherer Messwert1.511,723 95-%-Konfidenzintervall: ±7,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.431,858 95-%-Konfidenzintervall: ±5,294Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 12.251 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 39.449 veröffentlichten Paarvergleichen. | Höherer Messwert1.511,723 95-%-Konfidenzintervall: ±7,665Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.436,129 95-%-Konfidenzintervall: ±5,336Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.858 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 5.416 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,392 95-%-Konfidenzintervall: ±13,935Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.457,085 95-%-Konfidenzintervall: ±8,727Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.858 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 5.338 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,392 95-%-Konfidenzintervall: ±13,935Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.466,764 95-%-Konfidenzintervall: ±8,816Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 514 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.004 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,441 95-%-Konfidenzintervall: ±27,044Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.449,161 95-%-Konfidenzintervall: ±14,911Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 514 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 1.957 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,441 95-%-Konfidenzintervall: ±27,044Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.458,886 95-%-Konfidenzintervall: ±15,182Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 242 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 841 veröffentlichten Paarvergleichen. | Höherer Messwert1.519,307 95-%-Konfidenzintervall: ±37,488Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.425,17 95-%-Konfidenzintervall: ±21,221Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 242 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 904 veröffentlichten Paarvergleichen. | Höherer Messwert1.519,307 95-%-Konfidenzintervall: ±37,488Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.433,291 95-%-Konfidenzintervall: ±20,525Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 10.873 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 34.789 veröffentlichten Paarvergleichen. | Höherer Messwert1.515,521 95-%-Konfidenzintervall: ±6,697Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.459,087 95-%-Konfidenzintervall: ±4,755Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 10.873 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 34.719 veröffentlichten Paarvergleichen. | Höherer Messwert1.515,521 95-%-Konfidenzintervall: ±6,697Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.458,022 95-%-Konfidenzintervall: ±4,823Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.271 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 16.226 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,173 95-%-Konfidenzintervall: ±9,515Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.463,782 95-%-Konfidenzintervall: ±6,043Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 4.271 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 16.101 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,173 95-%-Konfidenzintervall: ±9,515Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.464,326 95-%-Konfidenzintervall: ±6,118Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 6.031 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 17.984 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,851 95-%-Konfidenzintervall: ±8,24Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.428,161 95-%-Konfidenzintervall: ±5,795Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 6.031 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 18.097 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,851 95-%-Konfidenzintervall: ±8,24Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.433,654 95-%-Konfidenzintervall: ±5,864Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlJapaneseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 276 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 653 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,252 95-%-Konfidenzintervall: ±37,875Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.398,855 95-%-Konfidenzintervall: ±24,754Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlJapaneseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 276 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 640 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,252 95-%-Konfidenzintervall: ±37,875Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.426,069 95-%-Konfidenzintervall: ±24,977Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlKoreanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 303 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 900 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,068 95-%-Konfidenzintervall: ±33,955Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.391,938 95-%-Konfidenzintervall: ±20,897Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlKoreanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 303 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 949 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,068 95-%-Konfidenzintervall: ±33,955Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.376,332 95-%-Konfidenzintervall: ±20,813Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLegal and governmentTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.407 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 4.152 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,939 95-%-Konfidenzintervall: ±16,24Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.448,281 95-%-Konfidenzintervall: ±9,836Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLegal and governmentTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.407 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 4.099 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,939 95-%-Konfidenzintervall: ±16,24Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.457,757 95-%-Konfidenzintervall: ±9,897Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLife, physical and social scienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 2.736 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.416 veröffentlichten Paarvergleichen. | Höherer Messwert1.509,294 95-%-Konfidenzintervall: ±11,74Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.456,243 95-%-Konfidenzintervall: ±7,368Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLife, physical and social scienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 2.736 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 8.489 veröffentlichten Paarvergleichen. | Höherer Messwert1.509,294 95-%-Konfidenzintervall: ±11,74Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.459,964 95-%-Konfidenzintervall: ±7,4Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLonger queriesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 7.577 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 23.382 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,599 95-%-Konfidenzintervall: ±7,76Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.447,798 95-%-Konfidenzintervall: ±5,56Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLonger queriesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 7.577 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 23.493 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,599 95-%-Konfidenzintervall: ±7,76Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.448,579 95-%-Konfidenzintervall: ±5,563Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 804 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.699 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,44 95-%-Konfidenzintervall: ±20,483Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.424,989 95-%-Konfidenzintervall: ±11,731Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 804 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.625 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,44 95-%-Konfidenzintervall: ±20,483Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.441,363 95-%-Konfidenzintervall: ±11,858Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathematical professionsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 964 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.980 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,518 95-%-Konfidenzintervall: ±19,004Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.434,613 95-%-Konfidenzintervall: ±11,415Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathematical professionsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 964 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 2.825 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,518 95-%-Konfidenzintervall: ±19,004Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.444,604 95-%-Konfidenzintervall: ±11,746Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMedicine and healthcareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.168 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 3.692 veröffentlichten Paarvergleichen. | Höherer Messwert1.495,696 95-%-Konfidenzintervall: ±17,901Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.459,398 95-%-Konfidenzintervall: ±10,484Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMedicine and healthcareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 1.168 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 3.760 veröffentlichten Paarvergleichen. | Höherer Messwert1.495,696 95-%-Konfidenzintervall: ±17,901Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.461,041 95-%-Konfidenzintervall: ±10,433Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMulti-turnTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 2.495 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 9.349 veröffentlichten Paarvergleichen. | Höherer Messwert1.489,527 95-%-Konfidenzintervall: ±12,17Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.453,168 95-%-Konfidenzintervall: ±7,275Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMulti-turnTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash-high-preview, Reasoning: high, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 2.495 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 9.223 veröffentlichten Paarvergleichen. | Höherer Messwert1.489,527 95-%-Konfidenzintervall: ±12,17Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.446,213 95-%-Konfidenzintervall: ±7,326Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlNon-EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserMuse Spark 1.3: Snapshot: muse-spark-1.3-max, Reasoning: max, Harness: Arena Text, style control DeepSeek-V4-Flash: Snapshot: deepseek-v4-flash, Harness: Arena Text, style controlMuse Spark 1.3: Arena-Bewertung aus 10.079 veröffentlichten Paarvergleichen.DeepSeek-V4-Flash: Arena-Bewertung aus 28.879 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,313 95-%-Konfidenzintervall: ±6,784Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.422,96 95-%-Konfidenzintervall: ±4,937Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.
Community-Klassiker für eine freie SVG-Zeichnung.
Muse Spark 1.3
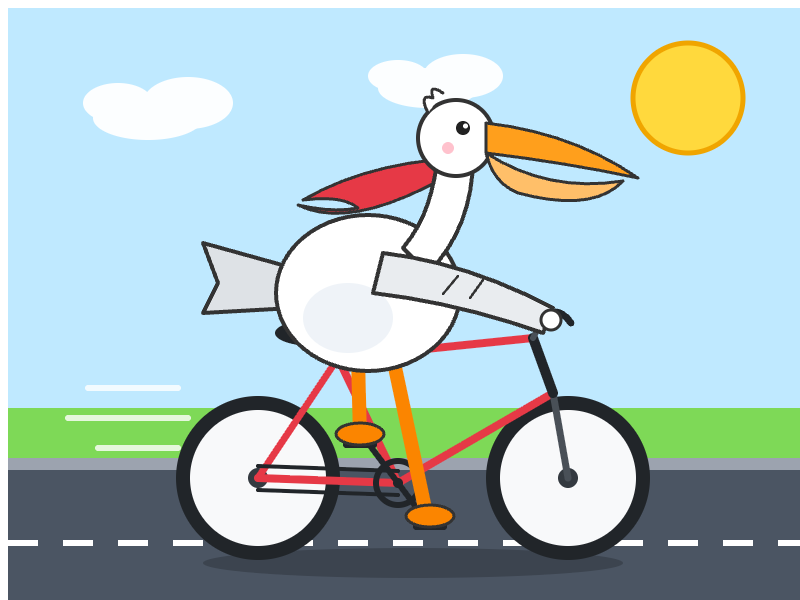
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
DeepSeek-V4-Flash
Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Muse Spark 1.3 und DeepSeek-V4-Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.