Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
196
verschiedene Benchmarks
24
jüngster Abruf
04.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Allgemeine Daten von Claude Sonnet 5 und Gemini 3.6 Flash
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
API-Preise von Claude Sonnet 5 und Gemini 3.6 Flash
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Anbieterpreise von Claude Sonnet 5 und Gemini 3.6 Flash
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Claude Sonnet 5
Gemini 3.6 Flash
Coding: 98,9 / 91,4 (6 Benchmarkfamilien)
Reasoning: 97,5 / 99,9 (2 Benchmarkfamilien)
Mathematik: 98,7 / 100 (1 Benchmarkfamilie)
Wissen: 98,9 / 100 (2 Benchmarkfamilien)
Finanzen: 99,1 / 98,1 (6 Benchmarkfamilien)
Recht: 99,1 / 81,6 (4 Benchmarkfamilien)
Agenten-Aufgaben: 100 / 99 (1 Benchmarkfamilie)
Multimodal: 93,9 / 100 (1 Benchmarkfamilie)
54 passende Messreihen aus 24 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 13 vergleichbaren Kategorien.
Claude Sonnet 5Gemini 3.6 Flash
Code MigrationOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 5Gewinner44,392 %
Gemini 3.6 Flash30,928 %
CorpFin v2Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 5Gewinner66,977 %
Gemini 3.6 Flash63,326 %
EMBOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 5Gewinner66,316 %
Gemini 3.6 Flash65,411 %
Finance Agent (v2)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 553,909 %
Gemini 3.6 FlashGewinner56,296 %
GPQA DiamondOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 588,889 %
Gemini 3.6 FlashGewinner93,434 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 5Gewinner5 %
Gemini 3.6 Flash3,333 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 5Gewinner41,827 %
Gemini 3.6 Flash25 %
LegalBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 583,922 %
Gemini 3.6 FlashGewinner86,705 %
LiveCodeBench v6Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 582,429 %
Gemini 3.6 FlashGewinner88,08 %
LMArena Text, Style ControlOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 51.462,16
Gemini 3.6 FlashGewinner1.480,192
MedCodeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 547,54 %
Gemini 3.6 FlashGewinner53,153 %
MedScribeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Sonnet 576,054 %
Gemini 3.6 FlashGewinner79,661 %
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Benchmarkwerte von Claude Sonnet 5 und Gemini 3.6 Flash
Benchmark und Aufgabe
Claude Sonnet 5
Gemini 3.6 Flash
Quelle
Code MigrationOverallTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Sonnet 5: Snapshot: claude-sonnet-5-high, Reasoning: high, Harness: Arena text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena text, style controlClaude Sonnet 5: Stilbereinigte Arena-Bewertung aus 31.096 anonymen Paarvergleichen.Gemini 3.6 Flash: Stilbereinigte Arena-Bewertung aus 22.009 anonymen Paarvergleichen.
1.462,16
95-%-Konfidenzintervall: ±4,745Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.480,192
95-%-Konfidenzintervall: ±5,12Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Sonnet 5: Snapshot: claude-sonnet-5-high, Reasoning: high, Harness: Arena text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena text, style controlClaude Sonnet 5: Stilbereinigte Arena-Bewertung aus 6.214 anonymen Paarvergleichen.Gemini 3.6 Flash: Stilbereinigte Arena-Bewertung aus 4.278 anonymen Paarvergleichen.
1.462,981
95-%-Konfidenzintervall: ±8,229Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.477,825
95-%-Konfidenzintervall: ±9,689Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Sonnet 5: Snapshot: claude-sonnet-5-high, Reasoning: high, Harness: Arena text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena text, style controlClaude Sonnet 5: Stilbereinigte Arena-Bewertung aus 2.074 anonymen Paarvergleichen.Gemini 3.6 Flash: Stilbereinigte Arena-Bewertung aus 1.402 anonymen Paarvergleichen.
1.499,492
95-%-Konfidenzintervall: ±13,64Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.536,451
95-%-Konfidenzintervall: ±16,413Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Community-Tests zum Anschauen
Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
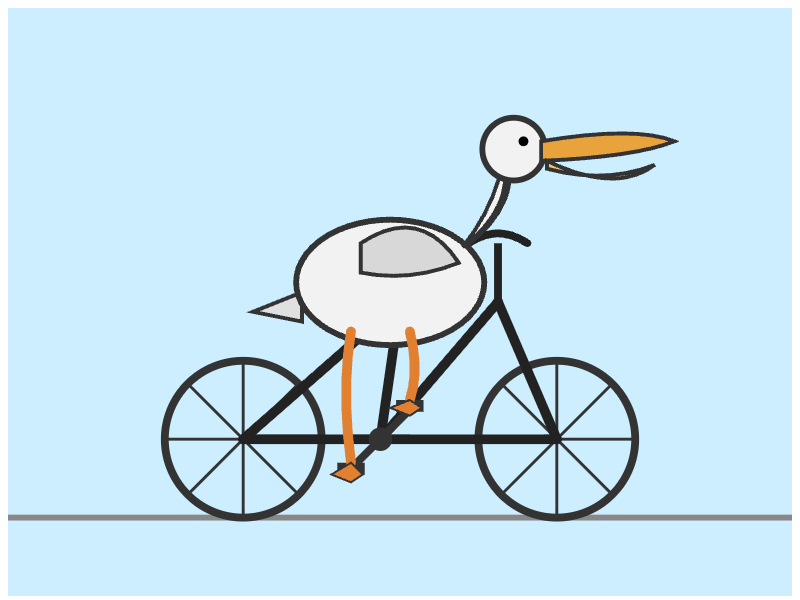
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Sonnet 5
Community-Klassiker für eine freie SVG-Zeichnung.Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-sonnet-5
API-Modell laut Antwort
anthropic/claude-sonnet-5
Festgelegter Endpunkt
Anthropic | anthropic/claude-sonnet-5-20260630
Reasoning-Einstellung
high
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
47,9 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Gemini 3.6 Flash
In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.
Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
google/gemini-3.6-flash
Festgelegter Endpunkt
Google AI Studio | google/gemini-3.6-flash-20260721
Reasoning-Einstellung
high
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche Claude Sonnet 5 und Gemini 3.6 Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.