Zum Hauptinhalt springen

OpenAIGoogleLLM-Duell

GPT-5.4vs.Gemini 3.5 Flash-Lite

Wer ist besser?

GPT-5.4 schneidet besser als Gemini 3.5 Flash-Lite ab, aber kostet 8,3-mal (Eingabe) und 6-mal (Ausgabe) so viel.

GPT-5.4 vorn
LeistungGesamtindex, 100 Punkte = Durchschnitt
86,4

GPT-5.4

Platz 50

72,4

Gemini 3.5 Flash-Lite

Platz 67

Gemini 3.5 Flash-Lite schneller
TempoToken pro Sekunde
64

GPT-5.4

135

Gemini 3.5 Flash-Lite

Gemini 3.5 Flash-Lite günstiger
Preis$ je 1 Mio. Token
5,63 $

GPT-5.4

0,85 $

Gemini 3.5 Flash-Lite

Beliebtheit0 bis 100
k. A.

GPT-5.4

71

Gemini 3.5 Flash-Lite

Platz 38 von 508

Ab 272.000 Token im Kontext kostet GPT-5.4 mehr: 5 $ Eingabe und 22,50 $ Ausgabe je 1 Mio. Token.

Nimm GPT-5.4 für

AgentenProgrammierenSchlussfolgernRechtFinanzeneher Gesundheiteher Multimodal

Bei Gemini 3.5 Flash-Lite gibt es keinen klaren Vorteil.

Wo liegt der Unterschied?

Stärken im Überblick

GPT-5.4Gemini 3.5 Flash-LiteMedian aller Modelle mit Platz

8010060ProgrammierenGPT-5.4SchlussfolgernGPT-5.4AgentenGPT-5.4MultimodalleichtGPT-5.4FinanzenGPT-5.4RechtGPT-5.4GesundheitleichtGPT-5.4
ProgrammierenGPT-5.4 vorn
GPT-5.485,0Platz 60
Gemini 3.5 Flash-Lite68,6Platz 81
Median aller Modelle mit Platz87,5

95-%-Bereich: GPT-5.4 75,3 bis 94,6, Gemini 3.5 Flash-Lite 62,4 bis 74,8.

BereichGPT-5.4Gemini 3.5 Flash-Lite

Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 60 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100. Nicht im Netz, weil ein Modell dort keinen eigenen Wert hat oder die Daten zu dünn sind: Mathematik, Wissen, Allgemein.

GPT-5.4 liegt in 5 von 9 Bereichen vorn, Gemini 3.5 Flash-Lite in keinem.

GPT-5.4 vorn: 5GPT-5.4 leicht vorn: 2zu wenig Daten: 2

Bereiche im Gesamtindex
AgentenGPT-5.4 +2190,5 zu 69,9
ProgrammierenGPT-5.4 +1685,0 zu 68,6
SchlussfolgernGPT-5.4 +1687,9 zu 71,6
Multimodaleher GPT-5.4nicht sicher · 4 und 3 Tests
Allgemeinzu wenig Daten86,1 zu 64,0
Wissenzu wenig Daten87,0 zu 77,9
Fachgebiete
RechtGPT-5.4 +1183,9 zu 72,5
FinanzenGPT-5.4 +1185,9 zu 74,7
Gesundheiteher GPT-5.4nicht sicher · 3 und 2 Tests

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

3 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Cybersicherheitnur Gemini 3.5 Flash-Lite mit Wertung
Produktivitätnur Gemini 3.5 Flash-Lite mit Wertung
Bildungnur Gemini 3.5 Flash-Lite mit Wertung

Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.

Welches Modell für welche Aufgabe?

Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.

Code schreiben und Fehler findenGPT-5.4Programmieren 85,0 zu 68,6
Mathe und DatenanalyseGPT-5.4Schlussfolgern 87,9 zu 71,6
Fakten und RechercheoffenWissen 87,0 zu 77,9 (zu wenig Daten)
Agenten und WorkflowsGPT-5.4Agenten 90,5 zu 69,9
Schnelle Antworten im ChatGemini 3.5 Flash-Lite64 zu 135 Token pro Sekunde
SicherheitsanalysenoffenCybersicherheit ohne Wertung für GPT-5.4
Viele Anfragen, kleines BudgetGemini 3.5 Flash-Lite5,63 $ zu 0,85 $ je 1 Mio. Token
Finanz-, Rechts- und MedizintexteGPT-5.4Finanzen 85,9 zu 74,7, Recht 83,9 zu 72,5, Gesundheit 80,4 zu 72,8
Bilder, Screenshots und PDFseher GPT-5.4Multimodal 88,8 zu 83,6

GPT-5.4 gegen Gemini 3.5 Flash-Lite im eigenen Test

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

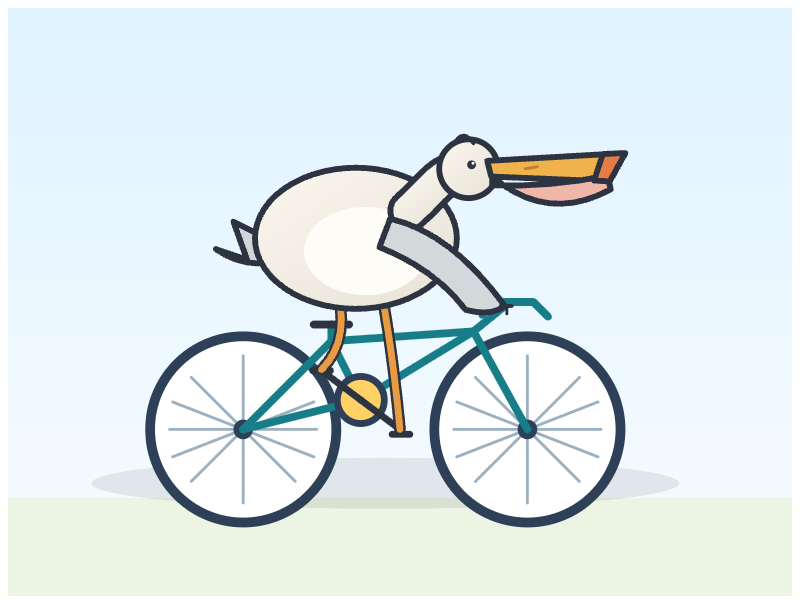
Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

Ursprung der Aufgabe: Simon Willison

GPT-5.4

GPT-5.4: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

01.10.2026 · 117 s · 0,11 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.4
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
7.339 Token
Kosten des Versuchs
0,1101 $
Antwortzeit
116,8 s
API-Modell laut Antwort
openai/gpt-5.4
Festgelegter Endpunkt
OpenAI | openai/gpt-5.4-20260305
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)

  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high

Gemini 3.5 Flash-Lite
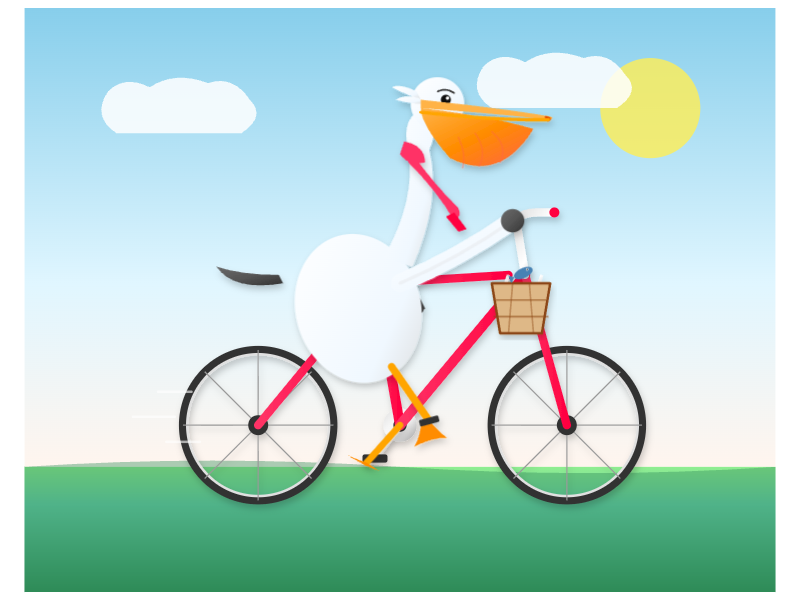
Gemini 3.5 Flash-Lite: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

02.10.2026 · 14 s · 0,01 $

Testdetails
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
google/gemini-3.5-flash-lite
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
5.414 Token
Kosten des Versuchs
0,0135 $
Antwortzeit
14,3 s
API-Modell laut Antwort
google/gemini-3.5-flash-lite
Festgelegter Endpunkt
Google AI Studio | google/gemini-3.5-flash-lite-20260721
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (2)

  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

GPT-5.4

In dieser Runde nicht verfügbar

Gemini 3.5 Flash-Lite

In dieser Runde nicht verfügbar

GPT-5.4 und Gemini 3.5 Flash-Lite im Gesamtindex

Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.

Gesamtindex (Gradually Meta-Score v6)

20 von 95 Modellen

Claude Fable 5.2max130,9
Gemini 4 Carbonhigh127,0
Claude Opus 5.5max125,7
Claude Fable 5.1max124,1
Claude Sonnet 5.5max121,9
Gemini 4 Argonhigh121,2
GPT-6 Astramax119,6
Muse Wonder Fullmax118,4
GPT-6.1 Solmax117,5
Claude Opus 5max117,3
Muse Wondermax113,7
Claude Fable 5max112,8
Kimi K3.1 Promax112,6
Muse Ember 1.0max110,5
GPT-5.6 Solmax109,3
GPT-6 Solmax108,4
Gemini 3.7 Flashhigh107,7
DeepSeek V4.1 Flash 1017max107,1
GPT-5.4xhigh86,4
Gemini 3.5 Flash-Litehigh72,4

Beliebtheit im Vergleich

Wie oft die Modelle gesucht, genutzt und erwähnt werden, auf einer Skala von 0 bis 100.

Für GPT-5.4 gibt es noch keinen Beliebtheitswert.

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 16. November 2026

GPT-5.4Gemini 3.5 Flash-Lite

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlGPT-5.4Gemini 3.5 Flash-Lite
Leistung
GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser86,472,4
PlatzPlatz 50 von 95Platz 67 von 95
Preis je 1 Mio. Token
Eingabewas du schickst2,50 $über 272.000 Token: 5 $0,30 $
Ausgabewas das Modell schreibt15 $über 272.000 Token: 22,50 $2,50 $
Kosten je Aufgabe (eigene Tests)Durchschnitt aus 3 Aufgaben des ursprünglichen Testprotokolls, die beide Modelle bestanden haben (ohne SVG-Kurztest)0,19 $0,022 $
Tempo
Token pro Sekunde64135
Beliebtheit
BeliebtheitSuche, Nutzung und Erwähnungen, 0 bis 100k. A.71Platz 38 von 508
Technik
Kontextfensterwie viel Text das Modell auf einmal liest1,05 Mio. Token≈ 1.580 A4-Seiten1,05 Mio. Token≈ 1.570 A4-Seiten
Wissensstand31.08.2025k. A.
Veröffentlicht05.03.202621.07.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinnein

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gibt es eine bessere Wahl?

Nachfolger von GPT-5.4GPT-5.5

Gesamtindex 101,4, Platz 275 $ Eingabe und 30 $ Ausgabe je 1 Mio. Token

Gemini 3.5 Flash-Lite vs. GPT-5.5
Günstiger als Gemini 3.5 Flash-LiteMuse Ember 1.0

Gesamtindex 110,5, Platz 140,10 $ Eingabe und 0,50 $ Ausgabe je 1 Mio. Token

Zum Profil
Bestes Modell im GesamtindexClaude Fable 5.2

Gesamtindex 130,9, Platz 18 $ Eingabe und 40 $ Ausgabe je 1 Mio. Token

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: GPT-5.4B: Gemini 3.5 Flash-Lite

Code MigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 35,0 %Gemini 3.5 Flash-Lite: 6,1 %Vals AIStand 29.10.2026
CorpFin v2Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 65,3 %Gemini 3.5 Flash-Lite: 60,7 %Vals AIStand 12.08.2026
GPQA DiamondOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 91,7 %Gemini 3.5 Flash-Lite: 83,8 %Vals AIStand 01.09.2026
LegalBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 86,0 %Gemini 3.5 Flash-Lite: 84,1 %Vals AIStand 13.10.2026
LiveCodeBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 84,1 %Gemini 3.5 Flash-Lite: 79,0 %Vals AIStand 01.09.2026
LMArena Code Arena WebDevOverall · höher ist besserGPT-5.4: 1.400Gemini 3.5 Flash-Lite: 1.432LMArenaStand 15.11.2026
LMArena Text, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.475Gemini 3.5 Flash-Lite: 1.455LMArenaStand 11.11.2026
LMArena Vision, Style ControlOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.282Gemini 3.5 Flash-Lite: 1.266LMArenaStand 09.11.2026
MedCodeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 41,3 %Gemini 3.5 Flash-Lite: 43,5 %Vals AIStand 29.10.2026
MedScribeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 77,5 %Gemini 3.5 Flash-Lite: 70,9 %Vals AIStand 29.10.2026
54 weitere Benchmarks anzeigen
MMLU ProOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 87,5 %Gemini 3.5 Flash-Lite: 85,8 %Vals AIStand 01.09.2026
MMMU ProOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 87,5 %Gemini 3.5 Flash-Lite: 83,6 %Vals AIStand 01.09.2026
MortgageTaxOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 68,3 %Gemini 3.5 Flash-Lite: 68,7 %Vals AIStand 01.09.2026
ProgramBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 0 %Gemini 3.5 Flash-Lite: 0 %Vals AIStand 05.11.2026
SWE-bench VerifiedOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 78,2 %Gemini 3.5 Flash-Lite: 75,0 %Vals AIStand 01.09.2026
TaxEval v2Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 74,0 %Gemini 3.5 Flash-Lite: 72,6 %Vals AIStand 01.09.2026
Vibe Code Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 67,4 %Gemini 3.5 Flash-Lite: 37,2 %Vals AIStand 05.11.2026
Code MigrationCLI · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 23,8 %Gemini 3.5 Flash-Lite: 5,9 %Vals AIStand 29.10.2026
CorpFin v2Exact Pages · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 64,1 %Gemini 3.5 Flash-Lite: 57,5 %Vals AIStand 12.08.2026
GPQA DiamondFew-Shot CoT · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 91,4 %Gemini 3.5 Flash-Lite: 81,8 %Vals AIStand 01.09.2026
LegalBenchConclusion Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 88,9 %Gemini 3.5 Flash-Lite: 88,4 %Vals AIStand 13.10.2026
LiveCodeBenchEasy · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 99,1 %Gemini 3.5 Flash-Lite: 98,8 %Vals AIStand 01.09.2026
LMArena Code Arena WebDevImage to WebDev · höher ist besserGPT-5.4: 1.441Gemini 3.5 Flash-Lite: 1.449LMArenaStand 15.11.2026
LMArena Text, Style ControlBusiness, management and finance · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.482Gemini 3.5 Flash-Lite: 1.453LMArenaStand 11.11.2026
LMArena Vision, Style ControlChinese · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.317Gemini 3.5 Flash-Lite: 1.306LMArenaStand 09.11.2026
MMLU ProBiology · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 92,9 %Gemini 3.5 Flash-Lite: 91,9 %Vals AIStand 01.09.2026
MortgageTaxNumerical Extraction · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 76,0 %Gemini 3.5 Flash-Lite: 75,8 %Vals AIStand 01.09.2026
ProgramBenchAlmost Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 7 %Gemini 3.5 Flash-Lite: 0 %Vals AIStand 05.11.2026
SWE-bench Verified<15 min fix · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 88,1 %Gemini 3.5 Flash-Lite: 85,6 %Vals AIStand 01.09.2026
TaxEval v2Correctness · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 64,9 %Gemini 3.5 Flash-Lite: 61,7 %Vals AIStand 01.09.2026
Code MigrationCOBOL · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 68,6 %Gemini 3.5 Flash-Lite: 7,0 %Vals AIStand 29.10.2026
CorpFin v2Max Fitting Context · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 64,9 %Gemini 3.5 Flash-Lite: 62,4 %Vals AIStand 12.08.2026
GPQA DiamondZero-Shot CoT · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 91,9 %Gemini 3.5 Flash-Lite: 85,9 %Vals AIStand 01.09.2026
LegalBenchInterpretation Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 83,9 %Gemini 3.5 Flash-Lite: 80,3 %Vals AIStand 13.10.2026
LiveCodeBenchHard · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 67,7 %Gemini 3.5 Flash-Lite: 53,4 %Vals AIStand 01.09.2026
LMArena Code Arena WebDevReact development · höher ist besserGPT-5.4: 1.388Gemini 3.5 Flash-Lite: 1.407LMArenaStand 15.11.2026
LMArena Text, Style ControlChinese · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.505Gemini 3.5 Flash-Lite: 1.485LMArenaStand 11.11.2026
LMArena Vision, Style ControlCreative writing with images · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.264Gemini 3.5 Flash-Lite: 1.252LMArenaStand 09.11.2026
MMLU ProBusiness · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 91,8 %Gemini 3.5 Flash-Lite: 90,6 %Vals AIStand 01.09.2026
MortgageTaxSemantic Extraction · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 60,7 %Gemini 3.5 Flash-Lite: 61,5 %Vals AIStand 01.09.2026
ProgramBenchFully Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 0 %Gemini 3.5 Flash-Lite: 0 %Vals AIStand 05.11.2026
SWE-bench Verified>4 hours · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 0,0 %Gemini 3.5 Flash-Lite: 33,3 %Vals AIStand 01.09.2026
TaxEval v2Stepwise Reasoning · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 83,0 %Gemini 3.5 Flash-Lite: 83,5 %Vals AIStand 01.09.2026
Code MigrationCode Quality · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 3,632 / 5Gemini 3.5 Flash-Lite: 2,652 / 5Vals AIStand 29.10.2026
CorpFin v2Shared Max Context · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 66,8 %Gemini 3.5 Flash-Lite: 62,2 %Vals AIStand 12.08.2026
LegalBenchIssue Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 90,5 %Gemini 3.5 Flash-Lite: 89,3 %Vals AIStand 13.10.2026
LiveCodeBenchMedium · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 85,6 %Gemini 3.5 Flash-Lite: 84,9 %Vals AIStand 01.09.2026
LMArena Code Arena WebDevWeb development · höher ist besserGPT-5.4: 1.400Gemini 3.5 Flash-Lite: 1.432LMArenaStand 15.11.2026
LMArena Text, Style ControlCoding · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.521Gemini 3.5 Flash-Lite: 1.502LMArenaStand 11.11.2026
LMArena Vision, Style ControlDiagram understanding · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.319Gemini 3.5 Flash-Lite: 1.287LMArenaStand 09.11.2026
MMLU ProChemistry · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 91,1 %Gemini 3.5 Flash-Lite: 91,0 %Vals AIStand 01.09.2026
ProgramBenchRaw Pass Rate · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 68,6 %Gemini 3.5 Flash-Lite: 33,9 %Vals AIStand 05.11.2026
SWE-bench Verified1-4 hours · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 50,0 %Gemini 3.5 Flash-Lite: 40,5 %Vals AIStand 01.09.2026
LegalBenchRhetoric Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 82,8 %Gemini 3.5 Flash-Lite: 80,6 %Vals AIStand 13.10.2026
LMArena Text, Style ControlCreative writing · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.440Gemini 3.5 Flash-Lite: 1.436LMArenaStand 11.11.2026
LMArena Vision, Style ControlEnglish · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.279Gemini 3.5 Flash-Lite: 1.266LMArenaStand 09.11.2026
MMLU ProComputer Science · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 89,8 %Gemini 3.5 Flash-Lite: 87,6 %Vals AIStand 01.09.2026
SWE-bench Verified15 min - 1 hour · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 76,2 %Gemini 3.5 Flash-Lite: 73,2 %Vals AIStand 01.09.2026
LegalBenchRule Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 84,0 %Gemini 3.5 Flash-Lite: 81,7 %Vals AIStand 13.10.2026
LMArena Text, Style ControlEnglish · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.476Gemini 3.5 Flash-Lite: 1.461LMArenaStand 11.11.2026
LMArena Vision, Style ControlHomework · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.330Gemini 3.5 Flash-Lite: 1.288LMArenaStand 09.11.2026
MMLU ProEconomics · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 89,7 %Gemini 3.5 Flash-Lite: 89,8 %Vals AIStand 01.09.2026
LMArena Text, Style ControlEntertainment, sports and media · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.441Gemini 3.5 Flash-Lite: 1.433LMArenaStand 11.11.2026
LMArena Vision, Style ControlHumor · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4: 1.267Gemini 3.5 Flash-Lite: 1.267LMArenaStand 09.11.2026

Weitere Vergleiche

Vergleiche GPT-5.4 und Gemini 3.5 Flash-Lite mit den Modellen, die am häufigsten mit ihnen verglichen werden.

Anderes Duell vergleichen

Die beliebtesten Vergleiche

  1. 1Gemini 3.8 Flash vs. Gemini 3.5 Flash-Lite
  2. 2GPT-6 Luna vs. Gemini 3.5 Flash-Lite
  3. 3Claude Haiku 5.5 vs. Gemini 3.5 Flash-Lite
  4. 4GPT-6 Luna vs. GPT-5.4
  5. 5Claude Sonnet 5.5 vs. Gemini 3.5 Flash-Lite
  6. 6GPT-5.4 vs. GLM-5.3-Flash
  7. 7Gemini 3.5 Flash-Lite vs. Qwen 3.8 27B
  8. 8Gemini 3.5 Flash-Lite vs. DeepSeek-V4.1-Flash
  9. 9GPT-6 Sol vs. GPT-5.4
Alle 27 Vergleiche zeigen
  1. 10GPT-5.6 Luna vs. Gemini 3.5 Flash-Lite
  2. 11Gemini 3.5 Flash-Lite vs. DeepSeek V4.1 Flash 1017
  3. 12Gemini 3.5 Flash-Lite vs. GLM-5.3
  4. 13Claude Opus 5.5 vs. Gemini 3.5 Flash-Lite
  5. 14Gemini 3.7 Flash vs. Gemini 3.5 Flash-Lite
  6. 15GPT-5.6 Luna vs. GPT-5.4
  7. 16GPT-5.4 vs. GLM-5.3
  8. 17Claude Sonnet 5.5 vs. GPT-5.4
  9. 18GPT-6 Astra vs. GPT-5.4
  10. 19Claude Opus 5.5 vs. GPT-5.4
  11. 20GPT-5.6 Terra vs. GPT-5.4
  12. 21GPT-5.6 Sol vs. GPT-5.4
  13. 22Claude Haiku 4.5 vs. Gemini 3.5 Flash-Lite
  14. 23Claude Fable 5 vs. GPT-5.4
  15. 24GPT-6.1 Sol vs. GPT-5.4
  16. 25Gemini 4 Argon vs. Gemini 3.5 Flash-Lite
  17. 26GPT-6.1 Terra vs. GPT-5.4
  18. 27Gemini 4 Carbon vs. Gemini 3.5 Flash-Lite