Zum Hauptinhalt springen

XiaomiSprachmodellAktiv

MiMo V2.6 Pro UltraSpeed
Für MiMo V2.6 Pro UltraSpeed gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

Leistungnoch ohne Platz

k. A.Gesamtindexhöher ist besser

Temponicht gemessen

k. A.noch keine Messung

PreisPlatz 79 von 95

Eingabe 4,35 $ · Ausgabe 8,70 $

5,44 $je 1 Mio. Tokenniedriger ist besser

Kontextk. A.

k. A.Token auf einmal

BeliebtheitPlatz 673 von 876

0von 100wie im Vormonat

Zusammenfassung

Es ist teuer: 5,44 $ je 1 Mio. Token (Eingabe und Ausgabe gemischt), ein typisches Modell kostet 1,56 $.

MiMo V2.6 Pro UltraSpeed ist Xiaomis beschleunigter API- und Desktop-Modus für MiMo V2.6 Pro. Xiaomi verweist für die Gewichte auf den regulären Pro-Checkpoint. Die Bezeichnung beschreibt eine Auslieferung mit niedrigerer Latenz innerhalb der V2.6-Reihe.

Xiaomi nennt für UltraSpeed eine Beschleunigung von bis zu 20-fach. Das ist eine Anbieterangabe und hängt von der jeweiligen Plattform sowie dem gewählten Arbeitsablauf ab.

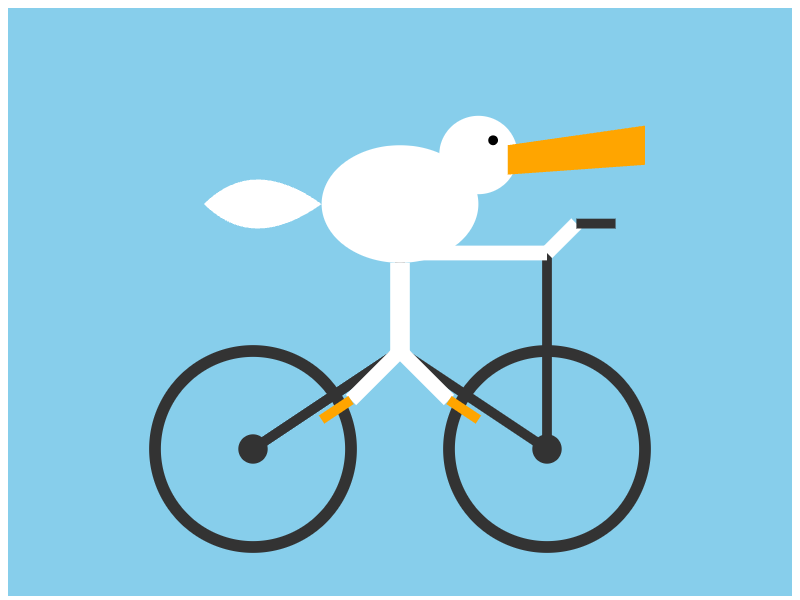
Selbst ansehen: ein Auftrag, ein Versuch

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

MiMo V2.6 Pro UltraSpeed

MiMo V2.6 Pro UltraSpeed: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0087 $

Testdetails
Testlauf
14.10.2026
Anbieter
xiaomi/fp8
API-Modell
xiaomi/mimo-v2.6-pro-ultraspeed
Ausgabe
953 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0087 $
Testrunde
43b8c5c46830
Frühere Tests

Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

06.10.2026 · 16 s · 0,07 $

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
06.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
xiaomi/mimo-v2.6-pro-ultraspeed
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
8.192 Token
Kosten des Versuchs
0,0713 $
Antwortzeit
15,9 s
API-Modell laut Antwort
xiaomi/mimo-v2.6-pro-ultraspeed
Festgelegter Endpunkt
Xiaomi | xiaomi/mimo-v2.6-pro-ultraspeed-20260921
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden

Frühere Versuche (2)

  • 02.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Ursprung der Aufgabe: Simon Willison

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 29 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 3

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

DataLLM Lab Python function suite hidden-assert tasks passed (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
9
Bewertung
9
Messgröße
tasks passed
Einheit
count
Benchmark-Version
DataLLM Lab nine-task Python function suite, run 2026-10-02
Kategorie
coding
Richtung
Mehr ist besser
Stichprobe
9
Quellentyp
independent-evaluator
Auswertung
DataLLM Lab executed API benchmark
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Exakter Endpunkt xiaomi/mimo-v2.6-pro-ultraspeed über OpenRouter. Neun eigenständige Python-Funktionsaufgaben. Der generierte Code wurde isoliert mit python3 -I und 12 Sekunden Zeitlimit gegen verborgene Assertions ausgeführt. Temperature 0, max_tokens 4000, ein gewerteter Versuch je Aufgabe. Alle neun bestanden.
Einordnung
Eine kleine Micro-Suite mit einem Versuch je Aufgabe und Deckeneffekt. Sie unterscheidet keine Modellqualität, misst weder multimodale noch agentische Arbeit und erlaubt keine allgemeine Aussage zur Programmierleistung.
Quelle DataLLM Lab executed API benchmark
DataLLM Lab Python function suite mean per-call latency (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
2.5
Bewertung
2.5
Messgröße
arithmetic mean latency per call
Einheit
seconds
Benchmark-Version
DataLLM Lab nine-task Python function suite, run 2026-10-02
Kategorie
coding
Richtung
Weniger ist besser
Stichprobe
9
Quellentyp
independent-evaluator
Auswertung
DataLLM Lab executed API benchmark
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Exakter Endpunkt xiaomi/mimo-v2.6-pro-ultraspeed über OpenRouter. Neun Aufrufe derselben Python-Funktionssuite mit neun Aufgaben. Gemeldete mittlere Latenz je Aufruf: 2,5 Sekunden. Dies ist die Wall-Clock-Latenz, kein Token-Durchsatz.
Einordnung
Ein einzelner Durchlauf mit nur neun Aufrufen. Der Wert ist keine stabile Service-Level- oder allgemeine Durchsatzmessung.
Quelle DataLLM Lab executed API benchmark
ToneBench Writing Score (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
80.6
Bewertung
80.6
Messgröße
composite score out of 100
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Writing Elo (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1990
Bewertung
1990
Messgröße
board-relative pairwise writing rating
Einheit
elo
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Untere Konfidenzgrenze
1947
Obere Konfidenzgrenze
2037
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Tone & Voice Match (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
78.2
Bewertung
78.2
Messgröße
Tone & Voice Match
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Writing Craft & Clarity (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
78
Bewertung
78
Messgröße
Writing Craft & Clarity
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Substance, Accuracy & Value (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
82.7
Bewertung
82.7
Messgröße
Substance, Accuracy & Value
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Continuity & Emotion (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
80
Bewertung
80
Messgröße
Continuity & Emotion
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench YouTube Best Practices (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
78.6
Bewertung
78.6
Messgröße
YouTube Best Practices
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Hook Strength (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
80.6
Bewertung
80.6
Messgröße
Hook Strength
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Length Adherence (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
89.4
Bewertung
89.4
Messgröße
Length Adherence
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench
ToneBench Slop Score (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
83.8
Bewertung
83.8
Messgröße
Slop Score
Einheit
points
Benchmark-Version
ToneBench October 2026 board, generated 2026-10-13T20:08:00Z
Kategorie
English long-form writing
Richtung
Mehr ist besser
Stichprobe
50
Quellentyp
independent-evaluator
Auswertung
Towards AI ToneBench
Status
superseded
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Über OpenRouter, exakte Route xiaomi/mimo-v2.6-pro-ultraspeed; Standard-Sampling des Anbieters, der Anbieter wendet Thinking an; fünf unabhängige Entwürfe je zehn englischsprachigen Skriptbriefs (50 Entwürfe), Laufdatum 2026-10-08; vier verblindete Beurteiler; geschlossen und ohne Tools.
Einordnung
Spezialisierte englischsprachige YouTube-Langformskripte in der Stimme eines einzelnen Creators, kein allgemeiner Fähigkeitswert. Vier verblindete Beurteiler bewerten die Entwürfe; Längenpassung wird berechnet und die Hälfte des Slop Scores ebenfalls. Die genaue Rubrik ist nicht öffentlich. Veröffentlichte ±-Werte der Metriken sind Standardabweichungen zwischen Entwürfen, keine Konfidenzintervalle.
Quelle Towards AI ToneBench

Seite 1 von 3

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 6. November 2026

MiMo V2.6 Pro UltraSpeedAgnes 3.0 FlashAion 3.5Aion 3.5 MiniEmber-1

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Modellklasse
Hochgeschwindigkeitsmodus für MiMo V2.6 Pro
Quelle: Modellklasse

Ein- und Ausgabe

Geschwindigkeit
Laut Xiaomi bis zu 20-mal schnellere Inferenz
Quelle: Geschwindigkeit

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Zugang
MiMo API und MiMo Desktop
Quelle: Zugang
Gewichte
Keine eigenständigen Gewichte veröffentlicht
Quelle: Gewichte

API

API-Modellkennung
mimo-v2.6-pro-ultraspeed
Quelle: API-Modellkennung

Weitere Angaben

Batch API
Nicht verfügbar
Quelle: Batch API

Preise

Preisansicht wählen

1 Angebot, Preise in US-Dollar je 1 Mio. Token, Mischpreis aus 3 Teilen Eingabe und 1 Teil Ausgabe.

AnbieterEingabeAusgabeCache lesenMischpreis
Xiaomidirekt4,35 $8,70 $0,036 $5,44 $

Direktpreis laut Hersteller, geprüft am 25.10.2026. Zum LLM-Preisindex

Weitere Preisstufen und Regeln
Cache-Preis
0,036 US$ / 1 Mio. Token, Overseas-Echtzeit-API, CachetrefferQuelle
Eingabe-Preis
4,35 US$ / 1 Mio. Token, Overseas-Echtzeit-API, Cache MissQuelle
Ausgabe-Preis
8,70 US$ / 1 Mio. Token, Overseas-Echtzeit-APIQuelle

Kein Abo von Xiaomi mit diesem Modell. Über andere Anbieter ab ≈ 10,66 € im Monat (Command Code GOAT, mit begrenztem Guthaben). 4 Tarife in Deutschland.

TarifPreis im MonatHinweis
Command Code GOAT≈ 10,66 €mit begrenztem Guthaben
Command Code Pro≈ 21,32 €mit begrenztem Guthaben
Command Code Max 10×≈ 106,58 €mit begrenztem Guthaben
Command Code Max 20×≈ 213,17 €mit begrenztem Guthaben

Geschätzte Europreise zum EZB-Kurs vom 06.11.2026.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu MiMo V2.6 Pro UltraSpeed

Was kostet MiMo V2.6 Pro UltraSpeed?

Per API 4,35 $ je 1 Mio. Token Eingabe und 8,70 $ Ausgabe. Das ist teuer.

PreisDollar je 1 Mio. Token, Eingabe und Ausgabe gemischt · niedriger ist besser
GPT-5.6 Terra4,50 $
Gemini 3.1 Pro Preview4,50 $
MiMo V2.6 Pro UltraSpeedPlatz 79 von 955,44 $
GPT-5.45,63 $
Kimi K36 $
Claude Sonnet 4.66 $
Claude Sonnet 4.56 $

Wo kann ich MiMo V2.6 Pro UltraSpeed nutzen?

Nicht im Abo von Xiaomi. Zusammen mit anderen Anbietern sind es 4 Tarife in Deutschland, dazu kommt die API.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei Xiaomi

Kein Abo von Xiaomi mit diesem Modell.

Über andere Anbieter

4 Tarife bei 1 Anbieter, ab ≈ 10,66 € im Monat (Command Code GOAT), mit begrenztem Guthaben.

Per API

4,35 $ Eingabe, 8,70 $ Ausgabe je 1 Mio. Token.

Quellen und Datenstand

Alle 12 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Preis

API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten.

RecherchestandRecherchestand 15. Oktober 2026. 5 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Ungeklärt

broader-independent-quality-benchmarks

Hinweis

Für die exakte UltraSpeed-API-Route liegen getrennte Ergebnisse einer Python-Micro-Suite und von ToneBench für englische Langtexte vor. Diese spezialisierten Tests belegen weder breitere allgemeine Fähigkeiten noch eine unveränderliche Serving-Revision. Eine Aussage zum gleichen Checkpoint überträgt keine Ergebnisse des Geschwistermodells.

Weitere QuelleXiaomi MiMo model release (abgerufen 22. September 2026; 15. Oktober 2026) · Xiaomi MiMo V2.6 model release · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleXiaomi MiMo V2.6 announcement (abgerufen 22. September 2026; 15. Oktober 2026) · Xiaomi MiMo V2.6 announcement · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleDataLLM Lab executed API benchmark (abgerufen 16. Oktober 2026; 23. Oktober 2026)
Weitere QuelleTowards AI ToneBench (abgerufen 17. Oktober 2026; 28. Oktober 2026; 30. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 16. Oktober 2026)
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0