Zum Hauptinhalt springen

MetaSprachmodell

Llama 4 Maverick 17B Instruct

Für Llama 4 Maverick 17B Instruct gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen. Aus den Herstellerangaben schätzen wir rund 52,5 Punkte (95-%-Bereich 32,6 bis 72,3). Das ist keine unabhängige Messung.

BeliebtheitPlatz 448 von 785

33von 100+1 zum Vormonat

beruht auf Suche, Nutzung und Aufmerksamkeit

Zusammenfassung

Llama 4 Maverick 17B Instruct ist die katalogisierte Instruct-Identität für Metas offene Maverick-Gewichte. Die 17B im Namen stehen für aktive Parameter, nicht für die Gesamtgröße des MoE-Modells. Es verarbeitet Text und Bilder und bietet rund eine Million Token Kontext.

Die Gewichte nutzen die Llama-4-Community-Lizenz. Llama 4 Maverick führt zum Familien-Checkpoint. Llama 4 Scout 17B Instruct ist die parallele Scout-Variante mit größerem Kontext. Die Modellkarte nennt Transformers, vLLM und SGLang sowie Quantisierungen für llama.cpp, Ollama und LM Studio.

Selbst ansehen: ein Auftrag, ein Versuch

Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

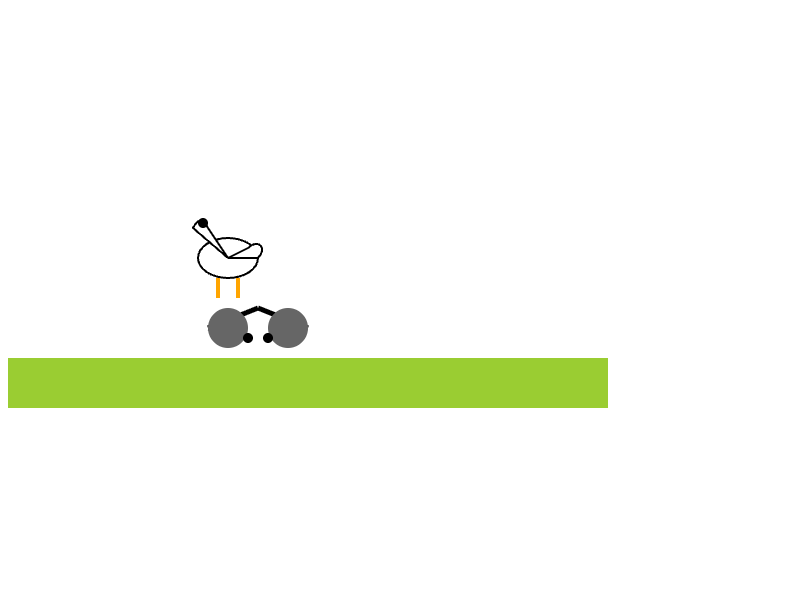
Llama 4 Maverick 17B Instruct: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

02.10.2026 · 33 s · 0,0005 $

Testdetails
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
meta-llama/llama-4-maverick
Reasoning-Einstellung
nicht vorgegeben
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
785 Token
Kosten des Versuchs
0,0005 $
Antwortzeit
33,3 s
API-Modell laut Antwort
meta-llama/llama-4-maverick
Festgelegter Endpunkt
DigitalOcean | meta-llama/llama-4-maverick-17b-128e-instruct
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Ursprung der Aufgabe: Simon Willison
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Llama 4 Maverick 17B Instruct

Kein unabhängiger Test. Dieser API-Zugang ist ein Alias von llama-4-maverick.

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 111 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 10

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

SWE-bench Verified (official mini-SWE-agent) (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
21.04
Bewertung
21.04
Messgröße
resolved issue rate
Einheit
%
Benchmark-Version
SWE-bench Verified; mini-SWE-agent 0.0.0; submission 20250720_mini-v0.0.0-Llama-4-Maverick-17B-Instruct
Kategorie
coding
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
SWE-bench
Status
active
Abrufdatum
2026-10-16
Methodik
Offizielle Benchmark-Rangliste. Offizielles SWE-bench Verified (500 Benchmarkaufgaben); mini-SWE-agent 0.0.0; Quellenkennung 20250720_mini-v0.0.0-Llama-4-Maverick-17B-Instruct; Quelldatum 2025-07-20; Modellbezeichnung Llama 4 Maverick Instruct; Reasoning-Stufe nicht angegeben. Quellprotokolle: s3://swe-bench-submissions/bash-only/20250720_mini-v0.0.0-Llama-4-Maverick-17B-Instruct/logs. Die Rangliste kennzeichnet die unabhängige Prüfung dieses Eintrags als bestätigt.
Einordnung
Historischer Eintrag der offiziellen Rangliste, kein neuer Modelllauf und keine Vals-Auswertung. mini-SWE-agent 1.x und 2.x verwenden unterschiedliche Aktionsschnittstellen und sind nicht automatisch vergleichbar. Nicht genannte Sampling-Werte, Wiederholungszahlen und Backend-Revisionen bleiben unbekannt.
Quelle SWE-bench
MMMU (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
73.4
Bewertung
73.4
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
MMMU Pro (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
59.6
Bewertung
59.6
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
MathVista (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
73.7
Bewertung
73.7
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
ChartQA (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
90
Bewertung
90
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
DocVQA (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
94.4
Bewertung
94.4
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
LiveCodeBench (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
43.4
Bewertung
43.4
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
MMLU Pro instruct (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
80.5
Bewertung
80.5
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
GPQA (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
69.8
Bewertung
69.8
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
MGSM (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
92.3
Bewertung
92.3
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; BF16
Quelle Meta Llama 4 model card
MTOB half (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
46.4
Bewertung
46.4
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
superseded
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned tool-use table; BF16
Quelle Meta Llama 4 model card
MTOB full (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
46.7
Bewertung
46.7
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 4 model card
Status
superseded
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned tool-use table; BF16
Quelle Meta Llama 4 model card

Seite 1 von 10

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

Llama 4 Maverick 17B InstructMixtral 8x22B 33Amazon Nova Pro 33Aya Expanse 32B 33MiMo V2.6 Pro UltraSpeed 33

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Parameter
400 Mrd.
Quelle: Parameter
Aktive Parameter
17 Mrd.
Quelle: Aktive Parameter
Wissensstand
August 2024
Quelle: Wissensstand

Ein- und Ausgabe

Kontextfenster
1.000.000 Token
Quelle: Kontextfenster
Maximale Ausgabe
16.384 Token
Quelle: Maximale Ausgabe
Eingaben
Text, Bild
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben
Tool-Aufrufe
Ja
Quelle: Tool-Aufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Offene Gewichte
Quelle: Gewichte
Lizenz
Llama 4 Community
Quelle: Lizenz

Preise

In keinem Abo in Deutschland enthalten.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Llama 4 Maverick 17B Instruct

Wie gut ist Llama 4 Maverick 17B Instruct in Benchmarks?

Unabhängige Ergebnisse reichen noch nicht für den Gesamtindex. Eine Schätzung aus 3 Herstellerangaben (MMLU-Pro 80,5 %, MMMU-Pro 59,6 %, MMMU (Validierung) 73,4 %) ergibt rund 52,5 Punkte, mit einem 95-%-Bereich von 32,6 bis 72,3. Die Schätzung ist an Modellen geeicht, für die es sowohl Herstellerangaben als auch unabhängige Messungen gibt. Herstellerangaben liegen bei einigen Tests deutlich über unabhängigen Messungen; die Eichung gleicht das im Mittel aus.

Herstellerschätzung, kein Wert des Gesamtindex

Bis wann reicht das Wissen von Llama 4 Maverick 17B Instruct?

Bis August 2024, laut Meta. Das ist 8 Monate vor der Veröffentlichung.

Angabe von Meta

Wie groß ist das Kontextfenster von Llama 4 Maverick 17B Instruct?

1 Mio. Token. So viel Text liest Llama 4 Maverick 17B Instruct auf einmal, das sind rund 1.500 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
Llama 4 Maverick 17B InstructPlatz 31 von 1031 Mio.
Claude Opus 5.51 Mio.
Gemini 4 Carbon1 Mio.
Claude Fable 5.11 Mio.
Claude Sonnet 5.51 Mio.
Muse Wonder Full1 Mio.
Claude Opus 51 Mio.

Kann ich Llama 4 Maverick 17B Instruct lokal nutzen?

Ja, die Gewichte sind offen. Mit 400 Mrd. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von Meta

Offene Gewichte
ja
Lizenz
Llama 4 Community
Parameter
400 Mrd.
davon aktiv je Token
17 Mrd.

Quellen und Datenstand

Alle 35 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
LMArena001
SWE-bench001
Scale AI Evals001

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten. 3 Messwerte sind noch keiner Testreihe zugeordnet.

ArtNachweis und Datenstand
Eingabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

RecherchestandRecherchestand 8. September 2026. 28 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

per-row evaluation N and confidence interval

Hinweis

Die Studie beschreibt Datensatzgrößen, berichtet aber weder N je Modellzeile noch ein Konfidenzintervall.

Ungeklärt

row-specific prompt, route, and checkpoint revision

Hinweis

Das Protokoll wird allgemein beschrieben, aber dieser Zeile nicht mit einer Promptvariante, Serving-Route oder Checkpoint-Revision zugeordnet.

Nicht veröffentlicht

evaluated N

Originalwortlaut

The leaderboard reports preference-vote totals but no fixed task-case N; Votes are not copied to sampleCount.

Ungeklärt

confidence interval

Originalwortlaut

The Score cell displays ±, but the official policy does not define that notation as a confidence interval; no CI field is populated.

Ungeklärt

score direction

Originalwortlaut

The captured source does not explicitly state higher-is-better or lower-is-better; higherIsBetter remains null.

Nicht veröffentlicht

per-model prompts and generation settings

Originalwortlaut

No exact prompt, decoding settings, or serving configuration is published in the captured row.

Weitere QuelleHugging Face (abgerufen 15. Oktober 2026; 20. Oktober 2026; 28. Oktober 2026) · Hugging Face, Llama 4 Maverick 17B Instruct · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleSWE-bench (abgerufen 16. Oktober 2026)
Weitere QuelleMeta Llama 4 model card (abgerufen 8. September 2026; 28. Oktober 2026)
Weitere QuelleMeta Llama-verifications benchmark report, pinned commit 9a53f29 (abgerufen 17. Oktober 2026)
Weitere QuelleRobustness as an Emergent Property of Task Performance (abgerufen 17. Oktober 2026; 24. Oktober 2026)
Weitere QuelleEFFIBENCH-X: A Multi-Language Benchmark for Measuring Efficiency of LLM-Generated Code (abgerufen 17. Oktober 2026)
Weitere QuelleAssessing Large Language Models for Medical QA: Zero-Shot and LLM-as-a-Judge Evaluation (arXiv:2602.14564v1) (abgerufen 17. Oktober 2026)
Weitere QuelleSpatialViz-Bench, anonymous ICLR 2026 submission (abgerufen 18. Oktober 2026)
Weitere QuelleMM-BrowseComp: A Comprehensive Benchmark for Multimodal Browsing Agents (abgerufen 18. Oktober 2026)
Weitere QuelleACL Anthology, Findings of EMNLP 2025, From KMMLU-Redux to Pro (abgerufen 18. Oktober 2026)
Weitere QuelleArena leaderboard (abgerufen 18. Oktober 2026)
Weitere QuelleFinCon Bench (abgerufen 19. Oktober 2026)
Weitere QuelleMeta Llama Verifications Benchmark Evaluation Report (abgerufen 19. Oktober 2026)
Weitere QuelleMERA Text (abgerufen 23. Oktober 2026)
Weitere QuelleBigCodeBench official leaderboard (abgerufen 28. Oktober 2026)12
Weitere QuelleScale SWE-Bench Pro public leaderboard (abgerufen 28. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 16. Oktober 2026)12
Weitere QuelleModellmetadaten (abgerufen 8. September 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 18. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 19. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 28. Oktober 2026)12345
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0