Zum Hauptinhalt springen

MetaSprachmodell

Llama-3.3-70B-Instruct

Für Llama-3.3-70B-Instruct gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

Leistungnoch ohne Platz

k. A.Gesamtindexhöher ist besser

TempoPlatz 62 von 101

75Token pro Sekundehöher ist besser

Preiskein API-Preis

k. A.je 1 Mio. Tokenniedriger ist besser

KontextPlatz 98 von 103

128 Tsd.Token auf einmal≈ 190 A4-Seiten

BeliebtheitPlatz 98 von 785

50von 100-1 zum Vormonat

beruht auf Suche, Nutzung und Aufmerksamkeit

Zusammenfassung

Mit 75 Token pro Sekunde schreibt es langsamer als ein typisches Modell (87).

Llama 3.3 70B Instruct ist der offene Instruct-Checkpoint der Llama-3.3-70B-Generation. Die Modellkarte führt Tool Calling und die Llama-3.3-Community-Lizenz auf. Llama 3.3 70B Instruct ist damit als selbst betreibbarer Gewichts-Checkpoint dokumentiert.

Llama 3.3 70B ist der parallele Verzeichniseintrag derselben Generation. Die Karte nennt 128.000 Token Kontext und Dezember 2023 als Wissensstand.

Selbst ansehen: ein Auftrag, ein Versuch

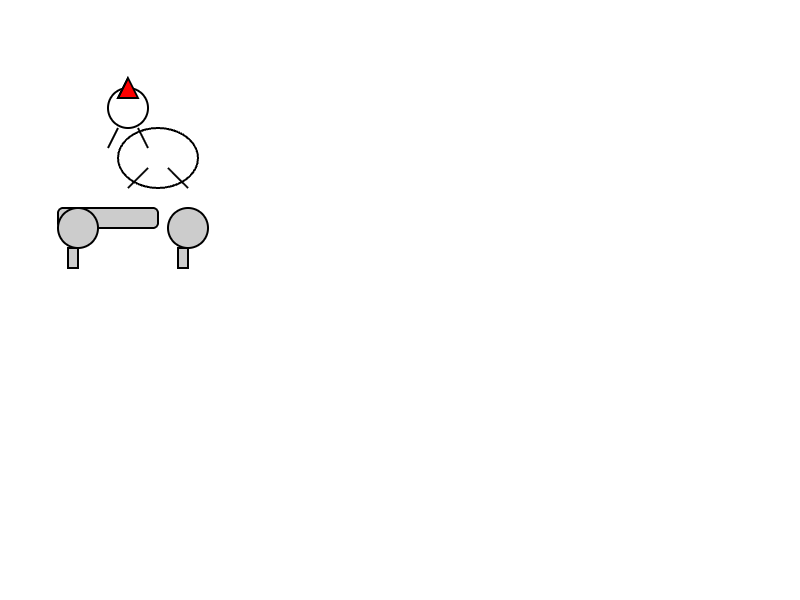
Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

Llama-3.3-70B-Instruct: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

01.10.2026 · 20 s · 0,0002 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
meta-llama/llama-3.3-70b-instruct
Reasoning-Einstellung
nicht vorgegeben
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
663 Token
Kosten des Versuchs
0,0002 $
Antwortzeit
20,4 s
API-Modell laut Antwort
meta-llama/llama-3.3-70b-instruct
Festgelegter Endpunkt
DeepInfra | meta-llama/llama-3.3-70b-instruct
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Ursprung der Aufgabe: Simon Willison
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Llama-3.3-70B-Instruct

Kein unabhängiger Test. Dieser API-Zugang ist ein Alias von llama-3.3-70b.

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 80 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 7

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

CritPt v2: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0
Bewertung
0
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
disputed
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Kennung des Quellmodells: artificial-analysis/976cc8ad-7904-4056-83c5-960181f47d5f/llama-3-3-instruct-70b/llama-3-3-instruct-70b. Name des Quellmodells: Llama-3.3-70B-Instruct. Anbieter laut Quelle: Meta. Modellstand: Llama 3.3 Instruct 70B. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: non-reasoning. Reasoning-Stufe: none. Angezeigter Wert: 0,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2:v2:standalone:non-reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: non-reasoning. Reasoning-Stufe: none
Einordnung
Die AA-Quelle enthält hier den ursprünglichen CritPt-Wert. Die frühere Zuordnung zu CritPt v2 ist falsch; Wert und frühere Beschriftung bleiben als strittiger Altbeleg erhalten.. Der Quelldatensatz markiert diesen Wert als umstritten. Er bleibt als dokumentierte Evidenz sichtbar, ist aber kein belastbarer Vergleichsnachweis.
Quelle Artificial Analysis
IFBench: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
47.0748299319728
Bewertung
47.0748299319728
Messgröße
IFBench prompt-level loose accuracy (pass@1)
Einheit
%
Benchmark-Version
AA test set: 294 questions
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1.. Kennung des Quellmodells: artificial-analysis/976cc8ad-7904-4056-83c5-960181f47d5f/llama-3-3-instruct-70b/llama-3-3-instruct-70b. Name des Quellmodells: Llama-3.3-70B-Instruct. Anbieter laut Quelle: Meta. Modellstand: Llama 3.3 Instruct 70B. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Single-turn answer evaluated with the official IFBench source code. Versuche: pass@1, 5 repeats per question. Reasoning: non-reasoning. Reasoning-Stufe: none. Angezeigter Wert: 47,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-ifbench:AA test set: 294 questions:standalone:non-reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1.. Werkzeugrichtlinie: Single-turn answer evaluated with the official IFBench source code. Versuche: pass@1, 5 repeats per question. Reasoning: non-reasoning. Reasoning-Stufe: none
Einordnung
Die Angabe von 58 bezieht sich auf die verifizierbaren Out-of-Domain-Bedingungstypen, nicht auf die Zahl der Fragen im AA-Testlauf.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
IFBench: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
47.0748299319728
Bewertung
47.0748299319728
Messgröße
IFBench prompt-level loose accuracy (pass@1)
Einheit
%
Benchmark-Version
AA test set: 294 questions
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1.. Kennung des Quellmodells: artificial-analysis/976cc8ad-7904-4056-83c5-960181f47d5f/llama-3-3-instruct-70b/llama-3-3-instruct-70b. Name des Quellmodells: Llama-3.3-70B-Instruct. Anbieter laut Quelle: Meta. Modellstand: Llama 3.3 Instruct 70B. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Single-turn answer evaluated with the official IFBench source code. Versuche: pass@1, 5 repeats per question. Reasoning: non-reasoning. Reasoning-Stufe: none. Angezeigter Wert: 47,1 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-ifbench:AA test set: 294 questions:standalone:non-reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1.. Werkzeugrichtlinie: Single-turn answer evaluated with the official IFBench source code. Versuche: pass@1, 5 repeats per question. Reasoning: non-reasoning. Reasoning-Stufe: none
Einordnung
Die Angabe von 58 bezieht sich auf die verifizierbaren Out-of-Domain-Bedingungstypen, nicht auf die Zahl der Fragen im AA-Testlauf.
Quelle Artificial Analysis
ITBench-AA (SRE): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.5649717514124291
Bewertung
0.5649717514124291
Messgröße
Average precision at full recall
Einheit
%
Benchmark-Version
AA cohort: 59 tasks
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. 59 Kubernetes-Incidentaufgaben, davon 40 öffentliche und 19 private, mit drei Wiederholungen je Aufgabe. Ein Lauf erhält null, wenn eine tatsächliche Ursache fehlt, sonst die Präzision bei vollständigem Recall. Dies ist nur die SRE-Teilmenge von ITBench.. Kennung des Quellmodells: artificial-analysis/976cc8ad-7904-4056-83c5-960181f47d5f/llama-3-3-instruct-70b/llama-3-3-instruct-70b. Name des Quellmodells: Llama-3.3-70B-Instruct. Anbieter laut Quelle: Meta. Modellstand: Llama 3.3 Instruct 70B. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Shell access to an offline Kubernetes incident snapshot. Versuche: Average precision at full recall, 3 repeats per task. Reasoning: non-reasoning. Reasoning-Stufe: none. Angezeigter Wert: 0,6 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-itbench-aa:AA cohort: 59 tasks:standalone:non-reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). AA kennzeichnet diese Modellvariante als non-reasoning und weist 0 Reasoning-Tokens aus. 59 Kubernetes-Incidentaufgaben, davon 40 öffentliche und 19 private, mit drei Wiederholungen je Aufgabe. Ein Lauf erhält null, wenn eine tatsächliche Ursache fehlt, sonst die Präzision bei vollständigem Recall. Dies ist nur die SRE-Teilmenge von ITBench.. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Shell access to an offline Kubernetes incident snapshot. Versuche: Average precision at full recall, 3 repeats per task. Reasoning: non-reasoning. Reasoning-Stufe: none
Einordnung
Die AA-Implementierung deckt hier nur Site Reliability Engineering ab, nicht die weiteren ITBench-Domänen CISO und FinOps.. Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
ITBench-AA (SRE): Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.5649717514124291
Bewertung
0.5649717514124291
Messgröße
Average precision at full recall
Einheit
%
Benchmark-Version
AA cohort: 59 tasks
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-07
Methodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. 59 Kubernetes-Incidentaufgaben, davon 40 öffentliche und 19 private, mit drei Wiederholungen je Aufgabe. Ein Lauf erhält null, wenn eine tatsächliche Ursache fehlt, sonst die Präzision bei vollständigem Recall. Dies ist nur die SRE-Teilmenge von ITBench.. Kennung des Quellmodells: artificial-analysis/976cc8ad-7904-4056-83c5-960181f47d5f/llama-3-3-instruct-70b/llama-3-3-instruct-70b. Name des Quellmodells: Llama-3.3-70B-Instruct. Anbieter laut Quelle: Meta. Modellstand: Llama 3.3 Instruct 70B. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Shell access to an offline Kubernetes incident snapshot. Versuche: Average precision at full recall, 3 repeats per task. Reasoning: non-reasoning. Reasoning-Stufe: none. Angezeigter Wert: 0,6 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-07-b96e3ffc8c5b. Prüfsumme der Quelldaten: b96e3ffc8c5b052aa56f96d05e89d02b8cc234a75085820fca0ca2a39e498274. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-07. Quellenkohorte: artificial-analysis-itbench-aa:AA cohort: 59 tasks:standalone:non-reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Llama 3.3 Instruct 70B (Release llama-3-3-instruct-70b, Zeile llama-3-3-instruct-70b, UUID 976cc8ad-7904-4056-83c5-960181f47d5f, reasoning=false, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. 59 Kubernetes-Incidentaufgaben, davon 40 öffentliche und 19 private, mit drei Wiederholungen je Aufgabe. Ein Lauf erhält null, wenn eine tatsächliche Ursache fehlt, sonst die Präzision bei vollständigem Recall. Dies ist nur die SRE-Teilmenge von ITBench.. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Shell access to an offline Kubernetes incident snapshot. Versuche: Average precision at full recall, 3 repeats per task. Reasoning: non-reasoning. Reasoning-Stufe: none
Einordnung
Die AA-Implementierung deckt hier nur Site Reliability Engineering ab, nicht die weiteren ITBench-Domänen CISO und FinOps.
Quelle Artificial Analysis
MMLU CoT (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
86
Bewertung
86
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table; chain-of-thought setting as labeled
Quelle Meta Llama 3.3 model card
MMLU Pro (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
68.9
Bewertung
68.9
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card
IFEval (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
92.1
Bewertung
92.1
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card
GPQA Diamond (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
50.5
Bewertung
50.5
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card
HumanEval (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
88.4
Bewertung
88.4
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card
MBPP (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
87.6
Bewertung
87.6
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card
MATH (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
77
Bewertung
77
Messgröße
percent
Einheit
%
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Meta Llama 3.3 model card
Status
active
Abrufdatum
2026-09-08
Methodik
Vom Anbieter veröffentlichter Wert. Instruction-tuned table; Card benchmark table
Quelle Meta Llama 3.3 model card

Seite 1 von 7

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 100 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

Llama-3.3-70B-InstructGemma 4 26B A4B 51Gemini 3.1 Pro Preview 50Flint 50Claude Sonnet 4.5 50

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Parameter
70 Mrd.
Quelle: Parameter
Wissensstand
Dezember 2023
Quelle: Wissensstand

Ein- und Ausgabe

Kontextfenster
128.000 Token
Quelle: Kontextfenster
Maximale Ausgabe
4.096 Token
Quelle: Maximale Ausgabe
Eingaben
Text
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben
Tool-Aufrufe
Ja
Quelle: Tool-Aufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Offene Gewichte
Quelle: Gewichte
Lizenz
Llama 3.3 Community
Quelle: Lizenz

Preise

In keinem Abo in Deutschland enthalten.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Llama-3.3-70B-Instruct

Bis wann reicht das Wissen von Llama-3.3-70B-Instruct?

Bis Dezember 2023, laut Meta. Das ist 12 Monate vor der Veröffentlichung.

Angabe von Meta

Wie groß ist das Kontextfenster von Llama-3.3-70B-Instruct?

128.000 Token. So viel Text liest Llama-3.3-70B-Instruct auf einmal, das sind rund 190 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GLM-5.1200 Tsd.
DeepSeek-V3 0324164 Tsd.
GLM-4.5131 Tsd.
GPT OSS 120B131 Tsd.
Llama-3.3-70B-InstructPlatz 98 von 103128 Tsd.
DeepSeek-V3.2128 Tsd.
DeepSeek-R1128 Tsd.

Wie schnell ist Llama-3.3-70B-Instruct?

75 Token pro Sekunde. Das ist langsamer als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
GPT-5.579
Mistral Large 378
Llama-3.3-70B-InstructPlatz 62 von 10175
Gemini 4 Argon74
GPT-6.1 Terra73
Grok 4.672
Grok 4.771

Kann ich Llama-3.3-70B-Instruct lokal nutzen?

Ja, die Gewichte sind offen.

Angaben von Meta

Offene Gewichte
ja
Lizenz
Llama 3.3 Community
Parameter
70 Mrd.
davon aktiv je Token
k. A.

Quellen und Datenstand

Alle 40 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis303
LMArena001
Berkeley Function Calling Leaderboard001

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten. 2 Messwerte sind noch keiner Testreihe zugeordnet.

ArtNachweis und Datenstand
Geschwindigkeit

Median der bereitstellenden Anbieter, Non-reasoning. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

Eingabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

RecherchestandRecherchestand 8. September 2026. 28 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

effective-sample-count-and-confidence-interval

Hinweis

CRADLE und SciTaRC veröffentlichen weder eine tatsächlich ausgewertete Stichprobengröße je Modellzeile noch ein Konfidenzintervall. Die 245 manuell annotierten Fragen zur Judge-Übereinstimmung bei SciTaRC sind nicht der Nenner der Modellbewertung und wurden nicht als N übernommen.

Nicht veröffentlicht

per-row evaluation N and confidence interval

Hinweis

Die Studie beschreibt Datensatzgrößen, berichtet aber weder N je Modellzeile noch ein Konfidenzintervall.

Ungeklärt

row-specific prompt, route, and checkpoint revision

Hinweis

Das Protokoll wird allgemein beschrieben, aber dieser Zeile nicht mit einer Promptvariante, Serving-Route oder Checkpoint-Revision zugeordnet.

Nicht veröffentlicht

evaluated N

Originalwortlaut

The leaderboard reports preference-vote totals but no fixed task-case N; Votes are not copied to sampleCount.

Ungeklärt

confidence interval

Originalwortlaut

The Score cell displays ±, but the official policy does not define that notation as a confidence interval; no CI field is populated.

Ungeklärt

score direction

Originalwortlaut

The captured source does not explicitly state higher-is-better or lower-is-better; higherIsBetter remains null.

Nicht veröffentlicht

per-model prompts and generation settings

Originalwortlaut

No exact prompt, decoding settings, or serving configuration is published in the captured row.

Weitere QuelleHugging Face (abgerufen 15. Oktober 2026) · Hugging Face, Llama 3.3 70B Instruct · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 29. Oktober 2026; 2. November 2026; 7. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 2. November 2026; 7. November 2026)12
Weitere QuelleMeta Llama 3.3 model card (abgerufen 8. September 2026)
Weitere QuelleCRADLE Bench: A Clinician-Annotated Benchmark for Multi-Faceted Mental Health Crisis and Safety Risk Detection (abgerufen 17. Oktober 2026)
Weitere QuelleSciTaRC: A Plan-Annotated Scientific Tabular QA Benchmark for Language Reasoning and Complex Computation (abgerufen 17. Oktober 2026)
Weitere QuelleRobustness as an Emergent Property of Task Performance (abgerufen 17. Oktober 2026)
Weitere QuelleHow Good Are LLMs at Processing Tool Outputs? (abgerufen 17. Oktober 2026)
Weitere QuelleAssessing Large Language Models for Medical QA: Zero-Shot and LLM-as-a-Judge Evaluation (arXiv:2602.14564v1) (abgerufen 17. Oktober 2026)
Weitere QuelleCausalVerify, Zhang et al. (abgerufen 17. Oktober 2026)
Weitere QuelleCould language models win the International Linguistics Olympiad? (abgerufen 18. Oktober 2026)
Weitere QuelleACL Anthology, Findings of EMNLP 2025, From KMMLU-Redux to Pro (abgerufen 18. Oktober 2026)
Weitere QuelleArena leaderboard (abgerufen 18. Oktober 2026)
Weitere QuelleDynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133 (abgerufen 19. Oktober 2026)
Weitere QuelleAre LLMs Ready for Computer Science Education? A Cross-Domain, Cross-Lingual and Cognitive-Level Evaluation Using Professional Certification Exams (arXiv:2604.06898v1) (abgerufen 19. Oktober 2026)
Weitere QuelleOracle Cloud Infrastructure (abgerufen 20. Oktober 2026)
Weitere QuelleBigCodeBench official leaderboard (abgerufen 28. Oktober 2026)12
Weitere QuelleBerkeley Function Calling Leaderboard V4 official overall CSV (abgerufen 28. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)12
Weitere QuelleModellmetadaten (abgerufen 18. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 28. Oktober 2026)1234567
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0