Llama 3.1 70B
Meta
Llama 3.1 70B vergrößert die dichte Architektur von Llama 3.1 8B auf 70 Milliarden Parameter. Beide verwenden Grouped-Query Attention und unterstützen acht Sprachen, darunter Deutsch.
Das 128K-Kontextfenster bleibt über beide Modellgrößen hinweg gleich. Die Gewichte stehen unter der Llama-3.1-Community-Lizenz, der Wissensstand endet im Dezember 2023. Llama 3.3 70B ist die spätere 70B-Generation.
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | Open WeightsQuelle nicht angegeben |
| Zugang | API, LokalQuelle |
| Parameter | 70 Mrd.Quelle nicht angegeben |
| Kontextfenster | 131.072 TokenQuelle |
| Knowledge Cutoff | Dezember 2023Quelle |
| Lizenz | Llama 3.1 Community LicenseQuelle |
| Veröffentlichung | 2024-07-23Quelle |
| Parameter | 70 Mrd.Quelle |
| Architektur | dense transformerQuelle |
| Eingabe | TextQuelle |
| Ausgabe | Text, codeQuelle |
| Sprachen | |
| Trainings-Token | 15T+Quelle |
| Wissensstand | 2023-12Quelle |
Seite 1 von 2
Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.
Seite 1 von 2
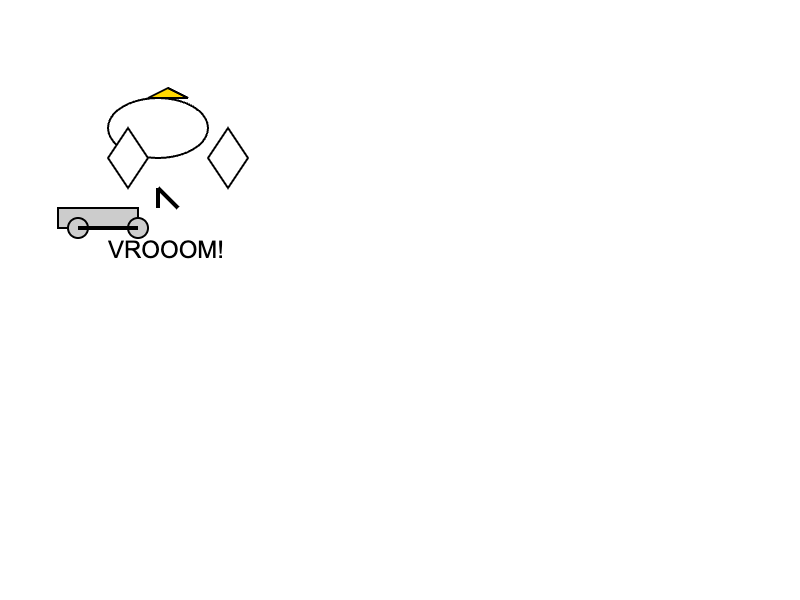
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
Llama 3.1 70B
Reasoning (angefragt): nicht vorgegeben
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)19,2 / 100
| Art | Nachweis und Datenstand |
|---|---|
| Geschwindigkeit | Median der bereitstellenden Anbieter. Ausgabetempo nach dem ersten empfangenen Textabschnitt, nicht die gesamte Antwortzeit. Bei Artificial Analysis als veraltet eingeordnet. Artificial Analysis pflegt dort nur noch den Standard-Workload mit 10.000 Eingabe-Token. Abgerufen am 8. September 2026. |
| Preis | API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten. |
| Eingabe | Dokumentierte Modalitäten. Abgerufen am 8. September 2026. |
| Ausgabe | Dokumentierte Modalitäten. Abgerufen am 8. September 2026. |
| Recherchestand | Recherchestand 8. September 2026. 2 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell. |
| In den geprüften Quellen nicht gefunden | max-output-tokens Originalwortlaut No model-specific maximum output in the card. |
| Weitere Quelle | Kontextfenster-Daten |
| Weitere Quelle | Wissensstand-Daten · Meta Llama model documentation · Redaktionelle Beschreibung geprüft am 4. Oktober 2026 |
| Weitere Quelle | OpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Vercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Creative Commons Attribution 4.0 |
| Weitere Quelle | Meta, Llama-3.3-70B-Instruct model card (Hugging Face) (2026-09-19) |