Zum Hauptinhalt springen

DeepSeekSprachmodell

DeepSeek V4 Pro 0423
Für DeepSeek V4 Pro 0423 gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

BeliebtheitPlatz 757 von 785

14von 100wie im Vormonat

beruht auf zwei Datengruppen, überwiegend Suche

Zusammenfassung

DeepSeek V4 Pro 0423 ist der Katalogeintrag vom 23. April 2026. DeepSeek datiert die öffentliche V4-Ankündigung auf den 24. April; damit bezeichnet 0423 einen initialen Snapshot und keinen separat bestätigten Gewichtsrelease. Das Datum trennt ihn vom späteren DeepSeek V4 Pro 0813.

Am 14. September 2026 leitete DeepSeek den Alias deepseek-v4-pro auf DeepSeek-V4.1-Flash um; der 0423-Snapshot stammt aus der ursprünglichen V4-Pro-Veröffentlichung.

Selbst ansehen: ein Auftrag, ein Versuch

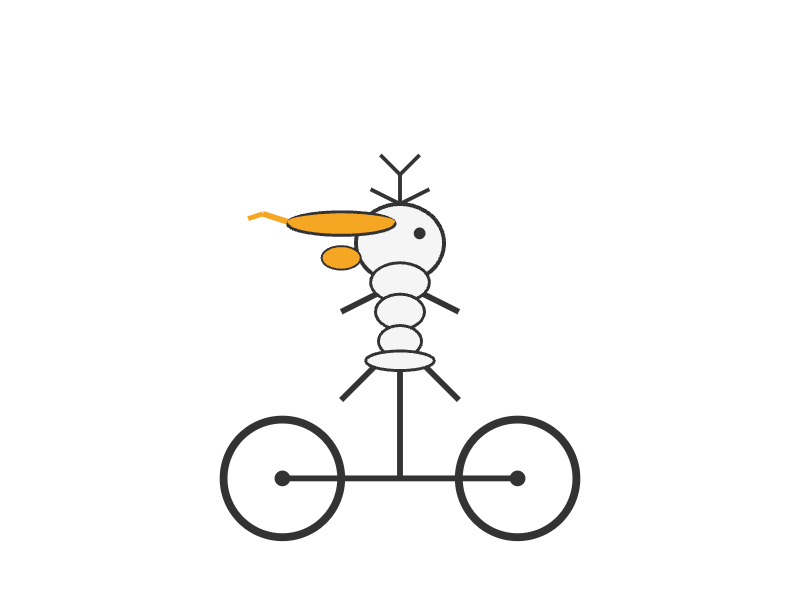
SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

DeepSeek V4 Pro 0423

DeepSeek V4 Pro 0423: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0018 $

Testdetails
Testlauf
14.10.2026
Anbieter
streamlake/fp8
API-Modell
deepseek/deepseek-v4-pro
Ausgabe
923 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0018 $
Testrunde
43b8c5c46830
Frühere Tests

Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

05.10.2026 · 161 s · 0,0034 $

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
05.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
deepseek/deepseek-v4-pro
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
8.192 Token
Kosten des Versuchs
0,0034 $
Antwortzeit
160,6 s
API-Modell laut Antwort
deepseek/deepseek-v4-pro
Festgelegter Endpunkt
StreamLake | deepseek/deepseek-v4-pro-20260423
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden

Frühere Versuche (2)

  • 02.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Ursprung der Aufgabe: Simon Willison

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 12 veröffentlichten Benchmark-Werte anzeigen

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

Aider Polyglot (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
20.6
Bewertung
20.6
Messgröße
pass@1
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; Python Exercism subset
Kategorie
coding
Richtung
Mehr ist besser
Stichprobe
34
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Einzelmodell-Ergebnis aus dem TrustedRouter-Panel über das TrustedRouter-Gateway; pass@1 für eine Python-Exercism-Teilmenge mit 34 Aufgaben. Sieben Aufgaben bestanden, eine Aufgabe hatte einen Transportfehler. Der Evaluator führte echte Tests aus und nutzte keinen LLM-Judge. Der öffentliche Datensatz bindet den Lauf nicht an eine unveränderliche Anbieterrevision und nennt nicht alle damaligen Decoding-Einstellungen.
Einordnung
Dies ist eine eng begrenzte Code-Reparatur-Testsuite und kein allgemeiner Modellqualitätswert. Die genaue Bezeichnung 0423 stammt aus der datierten Zuordnung des Evaluators. Das Ergebnisartefakt nennt nur deepseek/deepseek-v4-pro und keine unveränderliche Anbieterrevision.
Quelle TrustedRouter Benchmarks
SimpleQA Verified (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
55.1
Bewertung
55.1
Messgröße
F-score
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; SimpleQA Verified
Kategorie
knowledge
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Einzelmodell-Ergebnis über das TrustedRouter-Gateway; geschlossenes Wissen, keine Tools und Zielpopulation 250. Die Tabelle nennt Attempted% 91,3 als neutrale Diagnose. GPT-4.1 bewertet den F-Score anhand des modifizierten veröffentlichten Google-SimpleQA-Graderprompts mit Regeln für direkte Antworten und akzeptable numerische Bereiche. Das Antwortlimit beträgt 32.768 Token. Der Replay weist neun Transportfehler und null leere Antworten aus. Der Scorer schließt Antworten mit Transportfehlern aus, aber die öffentliche Zusammenfassung nennt nicht die Zahl tatsächlich bewerteter Antworten.
Einordnung
Die 250 Aufgaben sind die Zielpopulation und keine veröffentlichte tatsächliche Zahl bewerteter Antworten. Die Zahl tatsächlich ausgewerteter Antworten fehlt, neun Transportfehler werden von der Wertung ausgeschlossen und der F-Score nutzt einen LLM-Judge. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
SimpleQA Verified correct (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
52.7
Bewertung
52.7
Messgröße
Correct%
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; SimpleQA Verified
Kategorie
knowledge
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Einzelmodell-Ergebnis über das TrustedRouter-Gateway. Die gepinnte Evaluatortabelle weist für die Zielpopulation von 250 SimpleQA-Verified-Aufgaben Correct% mit 52,7 % und den neutralen Attempted%-Diagnosewert mit 91,3 % aus. Für Correct% definiert die Tabelle keinen Nenner der tatsächlich je Modell bewerteten Antworten. Der separate F-Score-Scorer schließt Transportfehler aus.
Einordnung
Die Tabelle nennt für diese Spalte nicht den tatsächlichen Nenner bewerteter Antworten; neun Transportfehler werden separat ausgewiesen. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators. Das Artefakt enthält keine unveränderliche Anbieterrevision.
Quelle TrustedRouter Benchmarks
SimpleQA Verified accuracy among attempted (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
57.7
Bewertung
57.7
Messgröße
Acc|attempted
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; SimpleQA Verified
Kategorie
knowledge
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Einzelmodell-Ergebnis über das TrustedRouter-Gateway. Die gepinnte Evaluatortabelle weist Acc|attempted mit 57,7 % und den neutralen Attempted%-Diagnosewert mit 91,3 % aus. Die Zielpopulation umfasst 250 Aufgaben. Die öffentliche Zusammenfassung veröffentlicht jedoch nicht die genaue Zahl der versuchten Antworten, die als Nenner der Genauigkeitsspalte dient.
Einordnung
Der genaue Nenner der versuchten Antworten ist nicht veröffentlicht; die Stichprobengröße bleibt daher unbekannt. Diese bedingte Genauigkeitsspalte unterscheidet sich vom F-Score und vom Correct-Anteil. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators. Das Artefakt enthält keine unveränderliche Anbieterrevision.
Quelle TrustedRouter Benchmarks
IFEval (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
36.2
Bewertung
36.2
Messgröße
mean of prompt-strict, prompt-loose, instruction-strict, and instruction-loose accuracy
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 100-prompt subset
Kategorie
instruction-following
Richtung
Mehr ist besser
Stichprobe
100
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Zero-Shot ohne Systemprompt, 100 Prompts; deterministische Google-Python-Verifizierer und kein LLM-Judge. Die vier Teilwerte sind prompt-strict 24,0 %, prompt-loose 30,0 %, instruction-strict 42,3 % und instruction-loose 48,5 %. Der Scorer zählt zwei Transportfehler als Fehler im Nenner von 100 Prompts.
Einordnung
Dies ist eine Instruktionsbefolgungsprüfung mit 100 Prompts und kein allgemeiner Qualitätswert. Zwei Transportfehler zählen als Fehler. Die genaue Bezeichnung 0423 stammt aus der datierten Zuordnung des Evaluators. Das Ergebnisartefakt nennt nur deepseek/deepseek-v4-pro und keine unveränderliche Anbieterrevision.
Quelle TrustedRouter Benchmarks
IFEval prompt-strict accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
24
Bewertung
24
Messgröße
Prompt-strict
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 100-prompt subset
Kategorie
instruction-following
Richtung
Mehr ist besser
Stichprobe
100
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Strenger IFEval-Wert auf Prompt-Ebene für die Teilmenge mit 100 Prompts; deterministische Google-Python-Prüfung und kein LLM-Judge. Der Scorer zählt zwei Transportfehler als Fehler im Prompt-Nenner.
Einordnung
Dies ist die strenge IFEval-Teilwertung auf Prompt-Ebene, nicht der Gesamtmittelwert und kein allgemeiner Qualitätswert. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
IFEval prompt-loose accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
30
Bewertung
30
Messgröße
Prompt-loose
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 100-prompt subset
Kategorie
instruction-following
Richtung
Mehr ist besser
Stichprobe
100
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Lockerer IFEval-Wert auf Prompt-Ebene für die Teilmenge mit 100 Prompts; deterministische Google-Python-Prüfung und kein LLM-Judge. Der Scorer zählt zwei Transportfehler als Fehler im Prompt-Nenner.
Einordnung
Dies ist die lockere IFEval-Teilwertung auf Prompt-Ebene, nicht der Gesamtmittelwert und kein allgemeiner Qualitätswert. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
IFEval instruction-strict accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
42.3
Bewertung
42.3
Messgröße
Inst-strict
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 100-prompt subset
Kategorie
instruction-following
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Strenge IFEval-Teilwertung auf Anweisungsebene aus der Teilmenge mit 100 Prompts; deterministische Google-Python-Prüfung und kein LLM-Judge. Die öffentliche Zusammenfassung nennt nicht die Zahl einzelner Anweisungen im Nenner dieser Teilwertung.
Einordnung
Dies ist die strenge IFEval-Teilwertung auf Anweisungsebene. Die 100 Prompts des Evaluators belegen nicht den Nenner einzelner Anweisungsbedingungen; die Stichprobengröße bleibt unbekannt. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
IFEval instruction-loose accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
48.5
Bewertung
48.5
Messgröße
Inst-loose
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 100-prompt subset
Kategorie
instruction-following
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Lockere IFEval-Teilwertung auf Anweisungsebene aus der Teilmenge mit 100 Prompts; deterministische Google-Python-Prüfung und kein LLM-Judge. Die öffentliche Zusammenfassung nennt nicht die Zahl einzelner Anweisungen im Nenner dieser Teilwertung.
Einordnung
Dies ist die lockere IFEval-Teilwertung auf Anweisungsebene. Die 100 Prompts des Evaluators belegen nicht den Nenner einzelner Anweisungsbedingungen; die Stichprobengröße bleibt unbekannt. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
MMLU-Pro (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
83.3
Bewertung
83.3
Messgröße
accuracy
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-19; MMLU-Pro subset
Kategorie
knowledge
Richtung
Mehr ist besser
Stichprobe
150
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. Der archivierte Replay enthält 150 MMLU-Pro-Aufgaben; Zero-Shot Chain-of-Thought, zehn Auswahlmöglichkeiten, deterministischer Abgleich des Antwortbuchstabens, kein LLM-Judge. Er weist 125/150 richtige Antworten, zwei Aufgaben ohne Antwort und null Transportfehler aus. Die Evaluatorwebseite bezeichnet dieselbe Zeile dagegen als Teilmenge mit 200 Fragen.
Einordnung
Der archivierte Replay und der Wert beziehen sich auf N=150. Die Evaluatorwebseite nennt N=200; der Quellenwiderspruch bleibt sichtbar. Dies ist ein einzelner Multiple-Choice-Benchmark und keine allgemeine Modellrangliste. Die genaue Bezeichnung 0423 ist die datierte Zuordnung des Evaluators und kein unveränderlicher Anbieternachweis.
Quelle TrustedRouter Benchmarks
GSM8K (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
100
Bewertung
100
Messgröße
exact-match accuracy
Einheit
%
Benchmark-Version
TrustedRouter replay 2026-06-17; 30-item subset
Kategorie
reasoning
Richtung
Mehr ist besser
Stichprobe
30
Quellentyp
independent-evaluator
Auswertung
TrustedRouter Benchmarks
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. GSM8K-Teilmenge mit 30 Aufgaben. Der Prompt verlangt eine Schlussantwort im ####-Format. Der Scorer prüft deterministisch auf numerische exakte Übereinstimmung und nutzt keinen LLM-Judge. Der Evaluator beschreibt diesen kleinen Lauf als gesättigte Plausibilitätsprüfung.
Einordnung
N=30 ist klein. Der Evaluator bezeichnet den gesättigten Lauf als Plausibilitätsprüfung und nicht als breiten Qualitätsmaßstab. Die genaue Bezeichnung 0423 stammt aus der datierten Zuordnung des Evaluators. Das Ergebnisartefakt nennt nur deepseek/deepseek-v4-pro und keine unveränderliche Anbieterrevision.
Quelle TrustedRouter Benchmarks
ObviousBench answer pass³ (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
79.9
Bewertung
79.9
Messgröße
Answer pass³, percentage of item/model/config cells where all three sampled answers are correct
Einheit
%
Benchmark-Version
0.2.0
Richtung
Mehr ist besser
Stichprobe
144
Quellentyp
independent-evaluator
Auswertung
ObviousBench
Status
active
Abrufdatum
2026-10-21
Methodik
Unabhängige Evaluation. ObviousBench v0.2.0, öffentliche Freigabe vom 13.08.2026; DeepSeek V4 Pro 0423, Einstellung „Reasoning“; 144 private Holdout-Aufgaben mit drei Antworten je Aufgabe. Die Quelle nennt weder die API-Route noch eine unveränderliche Servingrevision oder die genaue Reasoning-Stufe.
Einordnung
Der Wert misst nur einfache, objektiv auswertbare Aufgaben nach der pass³-Regel, nicht die allgemeine Modellqualität. Rohantworten und Ergebnisse je Aufgabe fehlen im Public-Local-Releasebundle, dessen README den Status local-prep nennt.
Quelle ObviousBench

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

DeepSeek V4 Pro 0423Sonar Reasoning Pro 14Seed 2.0 Mini 14Seed 2.0 Pro 14Seed 2.0 Lite 13

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Parameter
1.600 Mrd.
Quelle: Parameter
Aktive Parameter
49 Mrd.
Quelle: Aktive Parameter
Wissensstand
Mai 2025
Quelle: Wissensstand

Ein- und Ausgabe

Kontextfenster
1.000.000 Token
Quelle: Kontextfenster
Maximale Ausgabe
384.000 Token
Quelle: Maximale Ausgabe
Eingaben
Text
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben
Tool-Aufrufe
Ja
Quelle: Tool-Aufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Offene Gewichte
Quelle: Gewichte

Preise

In keinem Abo in Deutschland enthalten.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu DeepSeek V4 Pro 0423

Bis wann reicht das Wissen von DeepSeek V4 Pro 0423?

Bis Mai 2025, laut DeepSeek. Das ist 11 Monate vor der Veröffentlichung.

Angabe von DeepSeek

Wie groß ist das Kontextfenster von DeepSeek V4 Pro 0423?

1 Mio. Token. So viel Text liest DeepSeek V4 Pro 0423 auf einmal, das sind rund 1.500 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
DeepSeek V4 Pro 0423Platz 31 von 1031 Mio.
Claude Opus 5.51 Mio.
Gemini 4 Carbon1 Mio.
Claude Fable 5.11 Mio.
Claude Sonnet 5.51 Mio.
Muse Wonder Full1 Mio.
Claude Opus 51 Mio.

Kann ich DeepSeek V4 Pro 0423 lokal nutzen?

Ja, die Gewichte sind offen. Mit 1,6 Bio. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von DeepSeek

Offene Gewichte
ja
Lizenz
MIT
Parameter
1,6 Bio.
davon aktiv je Token
49 Mrd.

Quellen und Datenstand

Alle 24 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Eingabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

RecherchestandRecherchestand 15. Oktober 2026. 15 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Ungeklärt

exact-release-source-and-benchmarks

Hinweis

Es wurde keine lesbare offizielle Autorenseite für ein DeepSeek-V4-Pro-0423-Release gefunden; die direkte Kandidaten-URL war nicht verfügbar. Die verifizierte Pro-0813-Karte gehört zu einem getrennten offiziellen Release und bezeichnet dieses als Nachfolger der Preview. Dessen Ergebnisse werden deshalb nicht 0423 zugeordnet.

Ungeklärt

provider-checkpoint-identity

Hinweis

Die Evaluatorseite vom 18. Juni 2026 ordnet diese Zeilen ausdrücklich DeepSeek V4 Pro 0423 zu und beansprucht eine genaue Checkpoint-Abgrenzung. Die gepinnten Replay-Artefakte selbst nennen nur deepseek/deepseek-v4-pro. Eine unveränderliche Anbieterrevision wurde nicht gefunden. Die Namensbrücke ist daher die datierte Zuordnung des Evaluators, kein Anbieternachweis.

Nicht veröffentlicht

simpleqa-verified-scored-response-count

Hinweis

Die öffentliche Tabelle nennt eine Zielpopulation von 250 und einen Fehlerzähler von neun. Der gepinnte Scorer schließt Antworten mit Transportfehlern aus, veröffentlicht aber nicht die tatsächliche Zahl der Antworten je Modell, die in den F-Score eingehen. Die Zahl bewerteter Antworten bleibt unbekannt.

Ungeklärt

mmlu-pro-population-conflict

Hinweis

Die Evaluatorwebseite bezeichnet die Teilmenge als 200 Fragen. Die gepinnte README und die archivierte Replaydatei nennen dagegen 150 Aufgaben und 125/150 richtige Antworten. Die angegebene Stichprobengröße verwendet die überprüfbare Replaypopulation von 150. Der Widerspruch bleibt festgehalten.

Weitere QuelleTrustedRouter Benchmarks (abgerufen 16. Oktober 2026)
Weitere QuelleObviousBench (abgerufen 21. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 15. Oktober 2026; 16. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 16. Oktober 2026)123456789101112
Weitere QuelleDeepSeek V4 announcement · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleDeepSeek V4.1 lifecycle notice · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0