Zum Hauptinhalt springen

MicrosoftSprachmodell

WizardLM-2 8x22B

Für WizardLM-2 8x22B gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

BeliebtheitPlatz 400 von 785

36von 100-1 zum Vormonat

beruht auf Suche, Nutzung und Aufmerksamkeit

Zusammenfassung

WizardLM-2 8x22B ist ein großes, sparsames Mixture-of-Experts-Instruct-Modell von Microsoft. Der Checkpoint umfasst 141 Milliarden Parameter, aktiviert pro Token aber etwa 39 Milliarden. Microsoft ordnet ihn als größte WizardLM-2-Variante für komplexe Gespräche, Mehrsprachigkeit, Schlussfolgern und agentische Aufgaben ein. Das Kontextfenster umfasst 65.536 Token.

Die Modellkarte dokumentiert Bereitstellung über Transformers, vLLM und SGLang. In der Modellliste stehen außerdem quantisierte Fassungen für llama.cpp, Ollama und LM Studio. Die Apache-2.0-Lizenz gilt für den veröffentlichten Checkpoint.

Selbst ansehen: ein Auftrag, ein Versuch

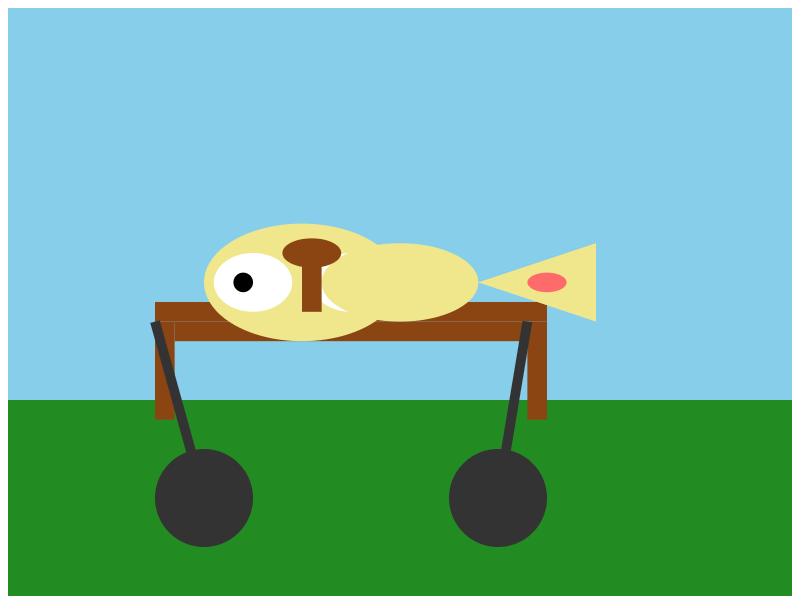
SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

WizardLM-2 8x22B

WizardLM-2 8x22B: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0004 $

Testdetails
Testlauf
14.10.2026
Anbieter
novita/bf16
API-Modell
microsoft/wizardlm-2-8x22b
Ausgabe
509 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0004 $
Testrunde
43b8c5c46830

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 62 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 6

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

IFEval strict accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
52.72
Bewertung
52.72
Messgröße
0-shot strict accuracy
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; IFEval 0-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; IFEval wird laut Modellkarte mit 0 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
BBH normalized accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
48.58
Bewertung
48.58
Messgröße
3-shot accuracy
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; BBH 3-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; BBH wird laut Modellkarte mit 3 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
MATH Lvl 5 exact match (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
22.28
Bewertung
22.28
Messgröße
4-shot exact match
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; MATH Level 5 4-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; MATH Level 5 wird laut Modellkarte mit 4 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
GPQA accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
17.56
Bewertung
17.56
Messgröße
0-shot accuracy
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; GPQA 0-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; GPQA wird laut Modellkarte mit 0 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
MuSR accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
14.54
Bewertung
14.54
Messgröße
0-shot accuracy
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; MuSR 0-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; MuSR wird laut Modellkarte mit 0 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
MMLU-Pro accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
39.96
Bewertung
39.96
Messgröße
5-shot accuracy
Einheit
%
Benchmark-Version
Open LLM Leaderboard row; MMLU-Pro 5-shot
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
official-leaderboard
Auswertung
WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
Status
active
Abrufdatum
2026-10-15
Methodik
Offizielle Benchmark-Rangliste. Exakter model-index-Wert von alpindale/WizardLM-2-8x22B; MMLU-Pro wird laut Modellkarte mit 5 Shots bewertet.
Einordnung
Die Modellkarte enthält Open-LLM-Leaderboard-Werte, pinnt aber weder ausgewertete Repository-Revision noch vollständige Decoding-Parameter.
Quelle WizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table
AlpacaEval 2.0 length-controlled win rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
51.3
Bewertung
51.3
Messgröße
LC win rate
Einheit
%
Benchmark-Version
AlpacaEval 2.0
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
OSC: Cognitive Orchestration through Dynamic Knowledge Alignment in Multi-Agent LLM Collaboration, Table 1
Status
active
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. OSC-Arbeit, Tabelle 1. Die Autoren sagen ausdrücklich, dass WizardLM-2-8x22B-Werte aus Vorarbeiten stammen. AlpacaEval 2.0 nutzt 805 Anweisungen, GPT-4 Preview als Vergleich und einen GPT-4-basierten Evaluator. MT-Bench nutzt veröffentlichte Mehrturn-Dialogwerte.
Einordnung
Die Arbeit gibt Ergebnisse aus Vorarbeiten wieder, keine neuen Läufe ihrer Autoren. Ausgewertetes N, Konfidenzintervalle und vollständige Generierungseinstellungen fehlen.
Quelle OSC: Cognitive Orchestration through Dynamic Knowledge Alignment in Multi-Agent LLM Collaboration, Table 1
AlpacaEval 2.0 standard win rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
62.3
Bewertung
62.3
Messgröße
standard win rate
Einheit
%
Benchmark-Version
AlpacaEval 2.0
Kategorie
general
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
OSC: Cognitive Orchestration through Dynamic Knowledge Alignment in Multi-Agent LLM Collaboration, Table 1
Status
active
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. OSC-Arbeit, Tabelle 1. Die Autoren sagen ausdrücklich, dass WizardLM-2-8x22B-Werte aus Vorarbeiten stammen. AlpacaEval 2.0 nutzt 805 Anweisungen, GPT-4 Preview als Vergleich und einen GPT-4-basierten Evaluator. MT-Bench nutzt veröffentlichte Mehrturn-Dialogwerte.
Einordnung
Die Arbeit gibt Ergebnisse aus Vorarbeiten wieder, keine neuen Läufe ihrer Autoren. Ausgewertetes N, Konfidenzintervalle und vollständige Generierungseinstellungen fehlen.
Quelle OSC: Cognitive Orchestration through Dynamic Knowledge Alignment in Multi-Agent LLM Collaboration, Table 1
DynaCode (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
35.4
Bewertung
35.4
Messgröße
Pass@1; Unit 1
Einheit
%
Benchmark-Version
Findings of ACL 2025 paper, Table 2; DynaCode
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. Exakte Quellenzeile WizardLM-2-8x22B (176B); Pass@1 bezeichnet den prozentualen Anteil der im ersten Versuch korrekt gelösten Probleme, bei Temperatur 0. Laut Artikel werden Ergebnisse aus drei Experimenten mit fünf Zufalls-Seeds gemittelt. Zellnenner, ausgelieferte Checkpoint-Revision und vollständige Generierungsparameter sind dieser Zeile nicht zugeordnet.
Einordnung
Der Artikel druckt in Tabelle 2 Werte in Klammern mit ±, ordnet sie hier aber keinem Konfidenzintervall zu. Der Tabellenwert „Average“ bleibt als Verlagswert erhalten und wird nicht neu berechnet.
Quelle DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
DynaCode (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
27.5
Bewertung
27.5
Messgröße
Pass@1; Unit 2
Einheit
%
Benchmark-Version
Findings of ACL 2025 paper, Table 2; DynaCode
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. Exakte Quellenzeile WizardLM-2-8x22B (176B); Pass@1 bezeichnet den prozentualen Anteil der im ersten Versuch korrekt gelösten Probleme, bei Temperatur 0. Laut Artikel werden Ergebnisse aus drei Experimenten mit fünf Zufalls-Seeds gemittelt. Zellnenner, ausgelieferte Checkpoint-Revision und vollständige Generierungsparameter sind dieser Zeile nicht zugeordnet.
Einordnung
Der Artikel druckt in Tabelle 2 Werte in Klammern mit ±, ordnet sie hier aber keinem Konfidenzintervall zu. Der Tabellenwert „Average“ bleibt als Verlagswert erhalten und wird nicht neu berechnet.
Quelle DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
DynaCode (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
25.1
Bewertung
25.1
Messgröße
Pass@1; Unit 3
Einheit
%
Benchmark-Version
Findings of ACL 2025 paper, Table 2; DynaCode
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. Exakte Quellenzeile WizardLM-2-8x22B (176B); Pass@1 bezeichnet den prozentualen Anteil der im ersten Versuch korrekt gelösten Probleme, bei Temperatur 0. Laut Artikel werden Ergebnisse aus drei Experimenten mit fünf Zufalls-Seeds gemittelt. Zellnenner, ausgelieferte Checkpoint-Revision und vollständige Generierungsparameter sind dieser Zeile nicht zugeordnet.
Einordnung
Der Artikel druckt in Tabelle 2 Werte in Klammern mit ±, ordnet sie hier aber keinem Konfidenzintervall zu. Der Tabellenwert „Average“ bleibt als Verlagswert erhalten und wird nicht neu berechnet.
Quelle DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
DynaCode (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
12.8
Bewertung
12.8
Messgröße
Pass@1; Unit 4
Einheit
%
Benchmark-Version
Findings of ACL 2025 paper, Table 2; DynaCode
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. Exakte Quellenzeile WizardLM-2-8x22B (176B); Pass@1 bezeichnet den prozentualen Anteil der im ersten Versuch korrekt gelösten Probleme, bei Temperatur 0. Laut Artikel werden Ergebnisse aus drei Experimenten mit fünf Zufalls-Seeds gemittelt. Zellnenner, ausgelieferte Checkpoint-Revision und vollständige Generierungsparameter sind dieser Zeile nicht zugeordnet.
Einordnung
Der Artikel druckt in Tabelle 2 Werte in Klammern mit ±, ordnet sie hier aber keinem Konfidenzintervall zu. Der Tabellenwert „Average“ bleibt als Verlagswert erhalten und wird nicht neu berechnet.
Quelle DynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133

Seite 1 von 6

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 7. November 2026

WizardLM-2 8x22BAion 3.5 36Claude Opus 4.6 36ZDTaichu5.0-9B 36Apodex 1.1 Mini 36

Methodenwechsel im Verlauf, ein Sprung an dieser Stelle ist kein Marktereignis:

  1. 11. November 2026: Wert nur mit Such- oder Nutzungsdaten, 30-Tage-Aufmerksamkeit

Was gerade an Beliebtheit gewinnt, steht für Modelle, Anbieter, Harnesses und KI-Abos gesammelt in Alle KI-Trends.

Alle technischen Daten

Architektur

Parameter
141 Mrd.
Quelle: Parameter
Aktive Parameter
39 Mrd.
Quelle: Aktive Parameter

Ein- und Ausgabe

Kontextfenster
65.536 Token
Quelle: Kontextfenster
Eingaben
Text
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Offene Gewichte
Quelle: Gewichte
Lizenz
Apache 2.0
Quelle: Lizenz

Häufige Fragen zu WizardLM-2 8x22B

Wie groß ist das Kontextfenster von WizardLM-2 8x22B?

65.536 Token. So viel Text liest WizardLM-2 8x22B auf einmal, das sind rund 100 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GLM-5.1200 Tsd.
DeepSeek-V3 0324164 Tsd.
GLM-4.5131 Tsd.
GPT OSS 120B131 Tsd.
DeepSeek-V3.2128 Tsd.
DeepSeek-R1128 Tsd.
WizardLM-2 8x22BPlatz 103 von 10366 Tsd.

Kann ich WizardLM-2 8x22B lokal nutzen?

Ja, die Gewichte sind offen. Mit 141 Mrd. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von Microsoft

Offene Gewichte
ja
Lizenz
Apache 2.0
Parameter
141 Mrd.
davon aktiv je Token
39 Mrd.

Quellen und Datenstand

Alle 18 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Eingabe

Dokumentierte Modalitäten.

Ausgabe

Dokumentierte Modalitäten.

RecherchestandRecherchestand 15. Oktober 2026. 10 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

checkpoint-revision

Hinweis

Die eingebettete Leaderboard-Tabelle pinnt die Gewichtsrevision und einzelne Aufgaben-/Datumsdetails nicht.

Nicht veröffentlicht

scored-denominator-and-generation-settings

Hinweis

Die Ergebnistabellen nennen weder ausgewertetes N pro Aufgabe noch vollständige Sampling- und Decoding-Details. Die OSC-Arbeit kennzeichnet die WizardLM-Werte als Vorarbeiten.

Nicht veröffentlicht

score-unit

Originalwortlaut

The inspected Table 3 excerpt presents numeric scores without an explicit unit label; no percent unit is inferred.

Nicht veröffentlicht

confidence-interval-95

Originalwortlaut

The paper does not report a 95% confidence interval for these cells.

Nicht veröffentlicht

immutable-api-served-revision

Originalwortlaut

The paper identifies Lepton AI API as the route but no immutable served revision.

Weitere QuelleWizardLM-2 8x22B model-card Open LLM Leaderboard evaluation table (abgerufen 15. Oktober 2026)
Weitere QuelleTIGER-Lab official MMLU-Pro leaderboard results.csv (abgerufen 15. Oktober 2026)
Weitere QuelleOSC: Cognitive Orchestration through Dynamic Knowledge Alignment in Multi-Agent LLM Collaboration, Table 1 (abgerufen 17. Oktober 2026)
Weitere QuelleArena Learning: Build Data Flywheel for LLMs, Table 8 (abgerufen 17. Oktober 2026)
Weitere QuelleDARG (NeurIPS 2024) (abgerufen 18. Oktober 2026)
Weitere QuelleFinance Language Model Evaluation (FLAME) (abgerufen 19. Oktober 2026)
Weitere QuelleDynaCode paper, Findings of ACL 2025, ACL Anthology ID 2025.findings-acl.1133 (abgerufen 19. Oktober 2026)
Weitere QuelleNeurIPS 2024 Datasets and Benchmarks Track paper publishing REPLIQA0 results (abgerufen 19. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 15. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)
Weitere QuelleWizardLM-2 official release post · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0