xAIMistral AILLM-Duell
Grok 4.6vs.Mistral Large 3
Wer ist besser?
Grok 4.6 schneidet besser als Mistral Large 3 ab, aber kostet 4-mal so viel.
Grok 4.6
Platz 25
Mistral Large 3
Platz 95
Grok 4.6
Mistral Large 3
Grok 4.6
Mistral Large 3
Grok 4.6
Mistral Large 3
Platz 150 von 511
Ab 200.000 Token im Kontext kostet Grok 4.6 mehr: 4 $ Eingabe und 12 $ Ausgabe je 1 Mio. Token.
Nimm Grok 4.6 für
Bei Mistral Large 3 gibt es keinen klaren Vorteil.
Wo liegt der Unterschied?
Grok 4.6 liegt in 3 von 10 Bereichen vorn, Mistral Large 3 in keinem.
Grok 4.6 vorn: 3zu wenig Daten: 7
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
2 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
Welches Modell für welche Aufgabe?
Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.
Grok 4.6 gegen Mistral Large 3 im eigenen Test
Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.
Pelikan auf dem Fahrrad
Auftrag (englisches Original)
Generate an SVG of a pelican riding a bicycle
Grok 4.6
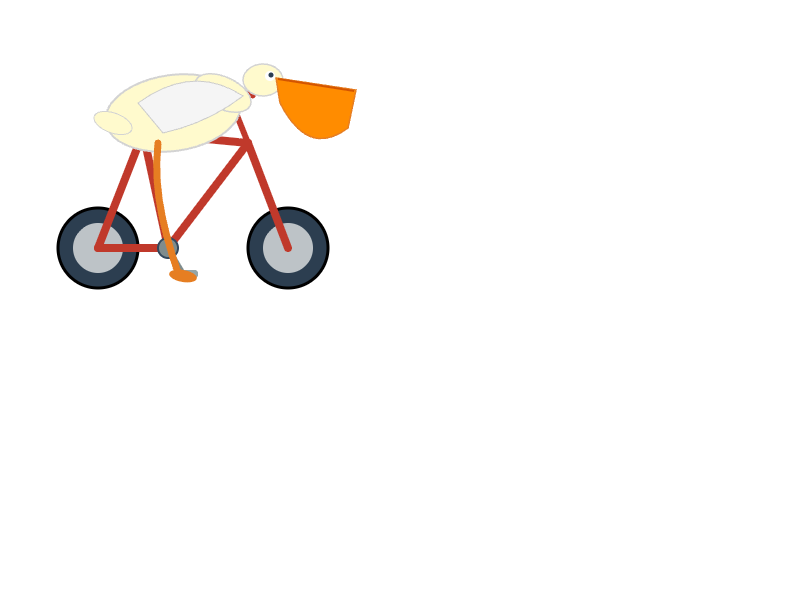
01.10.2026 · 114 s · 0,05 $
Testdetails
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- x-ai/grok-4.6
- Reasoning-Einstellung
- high
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Ausgabe-Token
- 7.660 Token
- Kosten des Versuchs
- 0,0462 $
- Antwortzeit
- 113,6 s
- API-Modell laut Antwort
- x-ai/grok-4.6
- Festgelegter Endpunkt
- xAI | x-ai/grok-4.6-20260810
- Temperatur
- Anbieterstandard
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Frühere Versuche (1)
- 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
Mistral Large 3
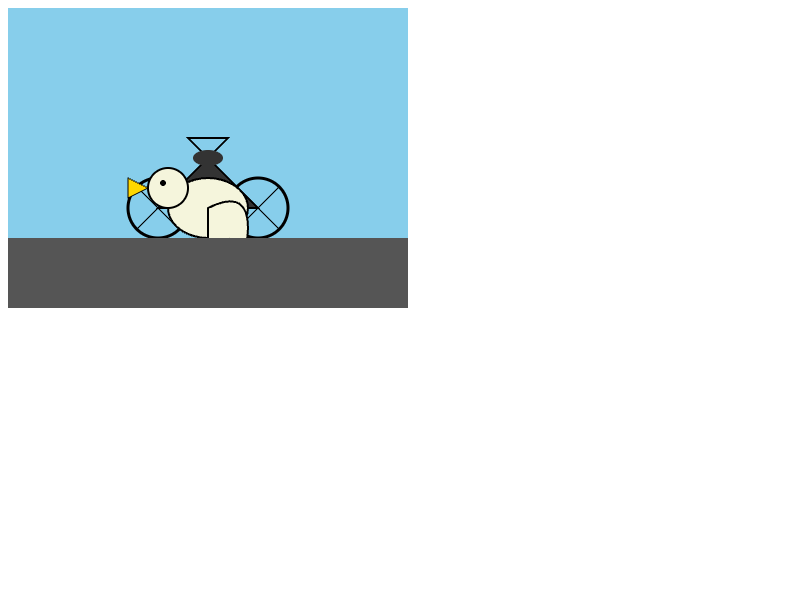
01.10.2026 · 14 s · 0,0022 $
Testdetails
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- mistralai/mistral-large-2512
- Reasoning-Einstellung
- nicht vorgegeben
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Ausgabe-Token
- 1.451 Token
- Kosten des Versuchs
- 0,0022 $
- Antwortzeit
- 14,2 s
- API-Modell laut Antwort
- mistralai/mistral-large-2512
- Festgelegter Endpunkt
- Mistral | mistralai/mistral-large-2512
- Temperatur
- Anbieterstandard
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
- Reasoning (Modellstandard)
- kein Reasoning-Modus Quelle
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Frühere Versuche (1)
- 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: nicht vorgegeben
SVG-Kurztest
SVG-Kurztest
Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.
Auftrag
Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.
Englischer Original-Auftrag
Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.
Grok 4.6
In dieser Runde nicht verfügbar
Mistral Large 3
API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.
Grok 4.6 und Mistral Large 3 im Gesamtindex
Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.
Gesamtindex (Gradually Meta-Score v6)
20 von 95 Modellen
Beliebtheit im Vergleich
Wie oft die Modelle gesucht, genutzt und erwähnt werden, auf einer Skala von 0 bis 100.
Für Grok 4.6 gibt es noch keinen Beliebtheitswert.
Zeitlicher Verlauf
Wochenwerte vom 18. Oktober 2026 bis 17. November 2026
Grok 4.6Mistral Large 3
Alle Daten im Vergleich
Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.
| Kennzahl | Grok 4.6 | Mistral Large 3 |
|---|---|---|
| Leistung | ||
| GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser | 102,1 | 32,7 |
| Platz | Platz 25 von 95 | Platz 95 von 95 |
| Preis je 1 Mio. Token | ||
| Eingabewas du schickst | 2 $über 200.000 Token: 4 $ | 0,50 $ |
| Ausgabewas das Modell schreibt | 6 $über 200.000 Token: 12 $ | 1,50 $ |
| Kosten je Aufgabe (eigene Tests)Durchschnitt aus 1 Aufgabe des ursprünglichen Testprotokolls, die beide Modelle bestanden haben (ohne SVG-Kurztest) | 0,046 $ | 0,002 $ |
| Tempo | ||
| Token pro Sekunde | 38 | 57 |
| Beliebtheit | ||
| BeliebtheitSuche, Nutzung und Erwähnungen, 0 bis 100 | k. A. | 48Platz 150 von 511 |
| Technik | ||
| Kontextfensterwie viel Text das Modell auf einmal liest | 500.000 Token≈ 750 A4-Seiten | 262.144 Token≈ 390 A4-Seiten |
| Wissensstand | 01.02.2026 | k. A. |
| Veröffentlicht | 12.08.2026 | 02.12.2025 |
| Verfügbarkeit | Aktiv | Aktiv |
| Offene Gewichte | nein | ja |
Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis
Gibt es eine bessere Wahl?
Gesamtindex 103,6, Platz 232 $ Eingabe und 6 $ Ausgabe je 1 Mio. Token
Mistral Large 3 vs. Grok 4.7Gesamtindex 110,5, Platz 140,10 $ Eingabe und 0,50 $ Ausgabe je 1 Mio. Token
Zum ProfilGesamtindex 130,9, Platz 18 $ Eingabe und 40 $ Ausgabe je 1 Mio. Token
Grok 4.6 vs. Claude Fable 5.2Gemeinsame Benchmarks
Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.
A: Grok 4.6B: Mistral Large 3
54 weitere Benchmarks anzeigen
Weitere Vergleiche
Vergleiche Grok 4.6 und Mistral Large 3 mit den Modellen, die am häufigsten mit ihnen verglichen werden.
Anderes Duell vergleichen
Vorgänger und Nachfolger
Die beliebtesten Vergleiche
- 1Claude Opus 5.5 vs. Grok 4.6
- 2Gemini 3.8 Flash vs. Grok 4.6
- 3Claude Opus 5.5 vs. Mistral Large 3
- 4Claude Opus 5 vs. Grok 4.6
- 5Gemini 4 Carbon vs. Grok 4.6
- 6Claude Sonnet 5.5 vs. Grok 4.6
- 7GLM-5.3 vs. Mistral Large 3
- 8Grok 4.6 vs. DeepSeek V4.1 Flash 1017
- 9Grok 4.6 vs. DeepSeek-V4-Flash
Alle 20 Vergleiche zeigen
- 10DeepSeek-V4-Flash vs. Mistral Large 3
- 11GPT-6 Luna vs. Grok 4.6
- 12Grok 4.6 vs. DeepSeek-V4.1-Flash
- 13GPT-5.6 Sol vs. Grok 4.6
- 14Claude Haiku 5.5 vs. Grok 4.6
- 15Claude Fable 5.2 vs. Grok 4.6
- 16Mistral Large 4 vs. Mistral Large 3
- 17DeepSeek-V4.1-Flash vs. Mistral Large 3
- 18Claude Haiku 5.5 vs. Mistral Large 3
- 19DeepSeek V4.1 Flash 1017 vs. Mistral Large 3
- 20GPT-5.6 Terra vs. Mistral Large 3