Claude Fable 5.1
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Fable 5.1 | Mistral Large 3 |
|---|---|---|
| Anbieter | Anthropic | Mistral AI |
| Erschienen | 1. Sept. 2026 | 2. Dez. 2025 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Open Weights |
| Parameter | Nicht veröffentlicht | 675 Mrd., 41 Mrd. aktiv |
| Architektur | Nicht veröffentlicht | Mixture of Experts |
| Kontextfenster | 1.000.000 Token | 262.144 Token |
| Wissensstand | Juni 2026 | Nicht veröffentlicht |
| Technische Quellen | Modell | Modell, Kontext |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Fable 5.1 | Mistral Large 3 |
|---|---|---|
| API-Eingabe | 10 $ | 0,5 $ |
| API-Ausgabe | 50 $ | 1,5 $ |
| Cache lesen | 0,25 $ | Nicht ausgewiesen |
| Cache schreiben (5 Min.) | 12,5 $ | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | 20 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | ||
| Mistral Large 3 | Mistral AI | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle22.09.2026 |
| Mistral | Über OpenRoutermistral/eu | 0,55 $ | 1,65 $ | Quelle17.10.2026 | |
| Mistral | Über OpenRoutermistral/zdr | Günstigster erfasster Preis: 0,5 $ | Günstigster erfasster Preis: 1,5 $ | Quelle17.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Fable 5.1 | Mistral Large 3 | Quelle |
|---|---|---|---|
GPQA DiamondOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,434 % | 68,434 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,511 % | 79,138 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,515 % | 55,337 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 7.230 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.742,652 95-%-Konfidenzintervall: ±9,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 14.121 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 83.498 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,568 95-%-Konfidenzintervall: ±6,106Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.414,136 95-%-Konfidenzintervall: ±2,865Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 4.648 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 8.643 veröffentlichten Paarvergleichen. | Höherer Messwert1.286,407 95-%-Konfidenzintervall: ±9,66Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.199,757 95-%-Konfidenzintervall: ±7,981Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,375 % | 79,823 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMMU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,636 % | 66,185 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert70,786 % | 52,106 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert48,526 % | 24,595 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
TaxEval v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert75,961 % | 73,058 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
GPQA DiamondFew-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,929 % | 64,141 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchConclusion TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,511 % | 81,032 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert99,068 % | 95,342 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 2.470 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.413 veröffentlichten Paarvergleichen. | Höherer Messwert1.719,751 95-%-Konfidenzintervall: ±13,642Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.361,78 95-%-Konfidenzintervall: ±17,387Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 2.589 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 15.540 veröffentlichten Paarvergleichen. | Höherer Messwert1.485,231 95-%-Konfidenzintervall: ±11,847Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.409,853 95-%-Konfidenzintervall: ±5,362Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 260 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 540 veröffentlichten Paarvergleichen. | Höherer Messwert1.340,8 95-%-Konfidenzintervall: ±36,169Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.211,728 95-%-Konfidenzintervall: ±27,072Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBiologyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert96,095 % | 88,563 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxNumerical ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert77,583 % | 50 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert34,524 % | 11,905 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
TaxEval v2CorrectnessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert64,105 % | 61,57 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
GPQA DiamondZero-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,939 % | 72,727 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchInterpretation TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert86,902 % | 76,594 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6HardTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert80,571 % | 17,143 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 7.230 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.742,652 95-%-Konfidenzintervall: ±9,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.230,205 95-%-Konfidenzintervall: ±25,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 1.069 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 6.341 veröffentlichten Paarvergleichen. | Höherer Messwert1.567,304 95-%-Konfidenzintervall: ±18,995Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,609 95-%-Konfidenzintervall: ±7,919Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 476 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 807 veröffentlichten Paarvergleichen. | Höherer Messwert1.289,586 95-%-Konfidenzintervall: ±29,623Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.196,146 95-%-Konfidenzintervall: ±22,467Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBusinessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert95,184 % | 84,664 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxSemantic ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert63,99 % | 54,213 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGECalculusTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert83,642 % | 0 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
TaxEval v2Stepwise ReasoningTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert87,817 % | 84,546 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LegalBenchIssue TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert92,72 % | 81,006 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6MediumTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert91,906 % | 53,525 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 855 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 839 veröffentlichten Paarvergleichen. | Höherer Messwert1.690,402 95-%-Konfidenzintervall: ±23,795Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.238,427 95-%-Konfidenzintervall: ±26,132Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 2.816 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 21.009 veröffentlichten Paarvergleichen. | Höherer Messwert1.535,255 95-%-Konfidenzintervall: ±11,537Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.470,833 95-%-Konfidenzintervall: ±4,783Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 1.100 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.169 veröffentlichten Paarvergleichen. | Höherer Messwert1.326,379 95-%-Konfidenzintervall: ±18,282Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.235,106 95-%-Konfidenzintervall: ±13,517Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProChemistryTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert93,816 % | 84,982 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGELinear AlgebraTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert71,371 % | 44,419 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LegalBenchRhetoric TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert82,295 % | 77,926 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 3.200 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 14.972 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,901 95-%-Konfidenzintervall: ±11,553Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.373,958 95-%-Konfidenzintervall: ±5,611Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 1.686 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.983 veröffentlichten Paarvergleichen. | Höherer Messwert1.277,583 95-%-Konfidenzintervall: ±15,139Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.210,278 95-%-Konfidenzintervall: ±12,173Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProComputer ScienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert94,878 % | 83,171 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
SAGEPartial Differential EquationsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Mistral Large 3: Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert39,683 % | 17,46 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
LegalBenchRule TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert88,125 % | 79,13 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 5.753 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 34.656 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,791 95-%-Konfidenzintervall: ±8,329Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.426,99 95-%-Konfidenzintervall: ±3,961Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 690 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 891 veröffentlichten Paarvergleichen. | Höherer Messwert1.335,022 95-%-Konfidenzintervall: ±22,506Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.211,931 95-%-Konfidenzintervall: ±20,61Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProEconomicsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert95,142 % | 85,782 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 3.559 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 18.448 veröffentlichten Paarvergleichen. | Höherer Messwert1.475,342 95-%-Konfidenzintervall: ±10,833Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.372,089 95-%-Konfidenzintervall: ±5,132Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHumorTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 193 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 427 veröffentlichten Paarvergleichen. | Höherer Messwert1.280,538 95-%-Konfidenzintervall: ±42,439Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.187,198 95-%-Konfidenzintervall: ±29,507Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProEngineeringTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,815 % | 74,923 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 10.459 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 61.071 veröffentlichten Paarvergleichen. | Höherer Messwert1.518,19 95-%-Konfidenzintervall: ±8,066Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.401,523 95-%-Konfidenzintervall: ±3,976Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 3.190 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 5.778 veröffentlichten Paarvergleichen. | Höherer Messwert1.302,401 95-%-Konfidenzintervall: ±10,866Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.215,499 95-%-Konfidenzintervall: ±8,709Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProHealthTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert86,675 % | 77,262 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 1.222 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 7.976 veröffentlichten Paarvergleichen. | Höherer Messwert1.523,697 95-%-Konfidenzintervall: ±17,383Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.427,286 95-%-Konfidenzintervall: ±7,215Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProHistoryTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert85,302 % | 70,866 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 476 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 2.379 veröffentlichten Paarvergleichen. | Höherer Messwert1.517,688 95-%-Konfidenzintervall: ±29,031Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,543 95-%-Konfidenzintervall: ±13,786Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProLawTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert87,466 % | 56,403 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 268 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 1.359 veröffentlichten Paarvergleichen. | Höherer Messwert1.484,511 95-%-Konfidenzintervall: ±35,581Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.407,953 95-%-Konfidenzintervall: ±17,201Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert97,335 % | 88,379 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 8.244 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 50.980 veröffentlichten Paarvergleichen. | Höherer Messwert1.520,197 95-%-Konfidenzintervall: ±7,328Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.432,155 95-%-Konfidenzintervall: ±3,56Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProOthersTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert89,935 % | 79,221 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 3.345 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 21.186 veröffentlichten Paarvergleichen. | Höherer Messwert1.516,447 95-%-Konfidenzintervall: ±10,669Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.439,589 95-%-Konfidenzintervall: ±4,785Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProPhilosophyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Mistral Large 3: Temperatur: 0.065, Ausgabegrenze: 256.000 tokens | Höherer Messwert90,18 % | 76,353 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Mistral Large 3: Snapshot: mistral-large-3, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 4.222 veröffentlichten Paarvergleichen.Mistral Large 3: Arena-Bewertung aus 26.939 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,708 95-%-Konfidenzintervall: ±9,807Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.401,72 95-%-Konfidenzintervall: ±4,374Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
API-Anfrage fehlgeschlagen. Das Modell wurde nicht bewertet.
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Fable 5.1
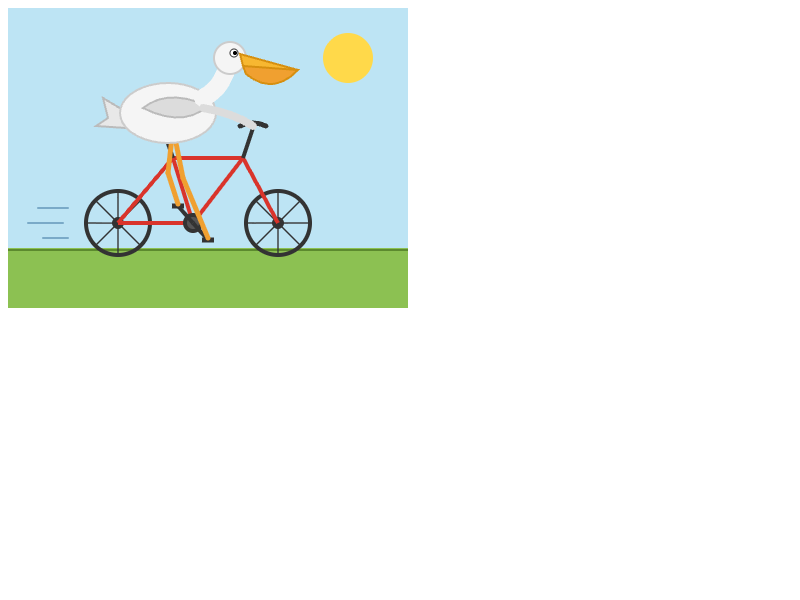
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Mistral Large 3
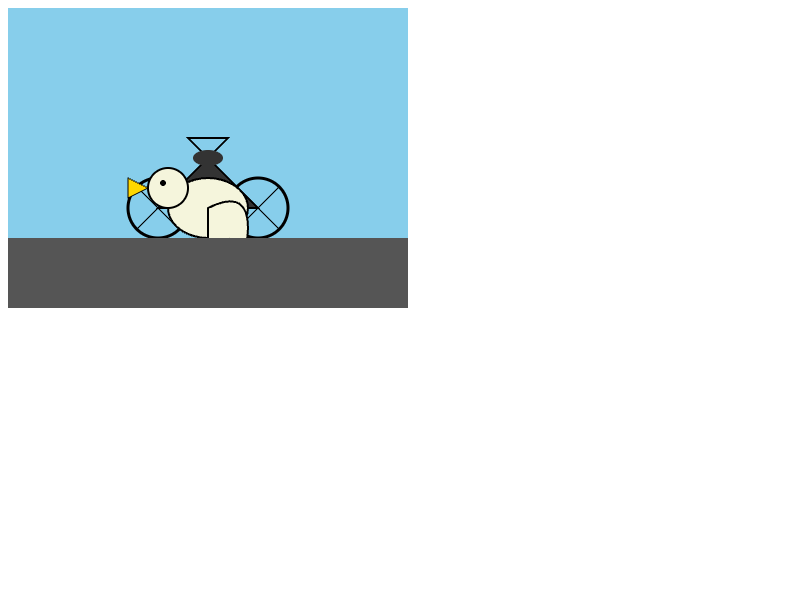
Reasoning (Modellstandard): kein Reasoning-Modus Quelle
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Fable 5.1 und Mistral Large 3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.