Claude Fable 5.1
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Fable 5.1 | Gemini 3.6 Flash |
|---|---|---|
| Anbieter | Anthropic | |
| Erschienen | 1. Sept. 2026 | 21. Juli 2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 1.048.576 Token |
| Wissensstand | Juni 2026 | März 2026 |
| Technische Quellen | Modell | Modell, Wissensstand |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Fable 5.1 | Gemini 3.6 Flash |
|---|---|---|
| API-Eingabe | 10 $ | 0,75 $ |
| API-Ausgabe | 50 $ | 3,75 $ |
| Cache lesen | 0,25 $ | 0,075 $ |
| Cache schreiben (5 Min.) | 12,5 $ | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | 20 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | |
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 10 $ | Günstigster erfasster Preis: 50 $ | Quelle17.10.2026 | ||
| Gemini 3.6 Flash | Direkt beim EntwicklerStandard-API | 0,75 $ | 3,75 $ | Quelle22.09.2026 | |
| Über OpenRoutergoogle-vertex/global | 0,75 $ | 3,75 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/global/flex | Günstigster erfasster Preis: 0,375 $ | Günstigster erfasster Preis: 1,875 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/global/priority | 1,35 $ | 6,75 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/us | 0,825 $ | 4,125 $ | Quelle17.10.2026 | ||
| Google AI Studio | Über OpenRoutergoogle-ai-studio | 0,75 $ | 3,75 $ | Quelle17.10.2026 | |
| Google AI Studio | Über OpenRoutergoogle-ai-studio/flex | Günstigster erfasster Preis: 0,375 $ | Günstigster erfasster Preis: 1,875 $ | Quelle17.10.2026 | |
| Google AI Studio | Über OpenRoutergoogle-ai-studio/priority | 1,35 $ | 6,75 $ | Quelle17.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Fable 5.1 | Gemini 3.6 Flash | Quelle |
|---|---|---|---|
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert54,607 % | 30,928 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert70,416 % | 45,357 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert76,67 % | 65,411 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert58,877 % | 56,296 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GPQA DiamondOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Kein direkter Sieger93,434 % | Kein direkter Sieger93,434 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert6,667 % | 3,333 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert90,778 % | 35,056 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert55,288 % | 25 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert88,511 % | 86,705 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert90,515 % | 88,08 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 7.230 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 8.768 veröffentlichten Paarvergleichen. | Höherer Messwert1.742,652 95-%-Konfidenzintervall: ±9,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.538,044 95-%-Konfidenzintervall: ±7,497Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 14.121 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 36.107 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,568 95-%-Konfidenzintervall: ±6,106Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.482,911 95-%-Konfidenzintervall: ±4,426Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 4.648 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 8.127 veröffentlichten Paarvergleichen. | Höherer Messwert1.286,407 95-%-Konfidenzintervall: ±9,66Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.280,714 95-%-Konfidenzintervall: ±8,17Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert53,509 % | 53,153 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert91,294 % | 79,661 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert92,375 % | 89,276 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMMU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert90,636 % | 88,382 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert70,786 % | 67,608 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert7 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Public Benefits Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert74,899 % | 56,563 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 30.000 tokens | 48,526 % | Höherer Messwert48,686 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
Tax Agent BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert49,194 % | 18,038 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
TaxEval v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert75,961 % | 74,857 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Terminal-Bench 2.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert85,019 % | 73,783 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench ScienceOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert40 % | 4,286 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert90,263 % | 64,005 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert52,809 % | 19,332 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PatchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert87,5 % | 85,714 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBCompsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert82,233 % | 70,019 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert54,393 % | 53,608 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GPQA DiamondFew-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert92,929 % | 92,424 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert89,855 % | 79,71 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2024TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert100 % | 40,667 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert68,182 % | 31,818 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchConclusion TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert92,511 % | 91,081 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Kein direkter Sieger99,068 % | Kein direkter Sieger99,068 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevImage to webdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 2.470 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 1.799 veröffentlichten Paarvergleichen. | Höherer Messwert1.719,751 95-%-Konfidenzintervall: ±13,642Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.544,911 95-%-Konfidenzintervall: ±14,31Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 2.589 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 6.836 veröffentlichten Paarvergleichen. | Höherer Messwert1.485,231 95-%-Konfidenzintervall: ±11,847Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.472,186 95-%-Konfidenzintervall: ±7,855Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 260 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 479 veröffentlichten Paarvergleichen. | Höherer Messwert1.340,8 95-%-Konfidenzintervall: ±36,169Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.329,153 95-%-Konfidenzintervall: ±27,579Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBiologyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert96,095 % | 94,7 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxNumerical ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert77,583 % | 76,789 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert53,5 % | 2,5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 30.000 tokens | 34,524 % | Höherer Messwert34,92 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert26,667 % | 3,333 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
TaxEval v2CorrectnessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert64,105 % | 63,532 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Terminal-Bench 2.1EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: high, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Kein direkter Sieger100 % | Kein direkter Sieger100 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench ScienceEarth SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert25 % | 12,5 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Code MigrationCOBOLTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | 60 % | Höherer Messwert65,714 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CyberBench v1.1PoCTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert53,333 % | 5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
EMBDataroomTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert86,736 % | 72,965 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)All-PassTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert47,773 % | 44,634 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GPQA DiamondZero-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | 93,939 % | Höherer Messwert94,444 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
IOIIOI 2025TestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert87,167 % | 40,833 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Legal Research BenchAdministrative / Regulatory · Weighted partial creditTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert92,519 % | 83,517 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchInterpretation TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert86,902 % | 83,894 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6HardTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert80,571 % | 74,571 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Code Arena WebDev Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Fable 5.1: Arena-Bewertung aus 7.230 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 8.768 veröffentlichten Paarvergleichen. | Höherer Messwert1.742,652 95-%-Konfidenzintervall: ±9,147Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.538,044 95-%-Konfidenzintervall: ±7,497Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Text, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Text, style controlClaude Fable 5.1: Arena-Bewertung aus 1.069 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 2.684 veröffentlichten Paarvergleichen. | Höherer Messwert1.567,304 95-%-Konfidenzintervall: ±18,995Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.529,669 95-%-Konfidenzintervall: ±11,898Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Fable 5.1: Snapshot: claude-fable-5.1-max, Reasoning: max, Harness: Arena Vision, style control Gemini 3.6 Flash: Snapshot: gemini-3.6-flash-high, Reasoning: high, Harness: Arena Vision, style controlClaude Fable 5.1: Arena-Bewertung aus 476 veröffentlichten Paarvergleichen.Gemini 3.6 Flash: Arena-Bewertung aus 716 veröffentlichten Paarvergleichen. | Höherer Messwert1.289,586 95-%-Konfidenzintervall: ±29,623Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.254,767 95-%-Konfidenzintervall: ±23,295Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBusinessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert95,184 % | 92,776 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxSemantic ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert63,99 % | 58,426 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
ProgramBenchFully ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 65.536 tokens | Höherer Messwert7 % | 0 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGECalculusTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Fable 5.1: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens Gemini 3.6 Flash: Reasoning: high, Temperatur: 1, Ausgabegrenze: 30.000 tokens | Höherer Messwert83,642 % | 75,309 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Fable 5.1
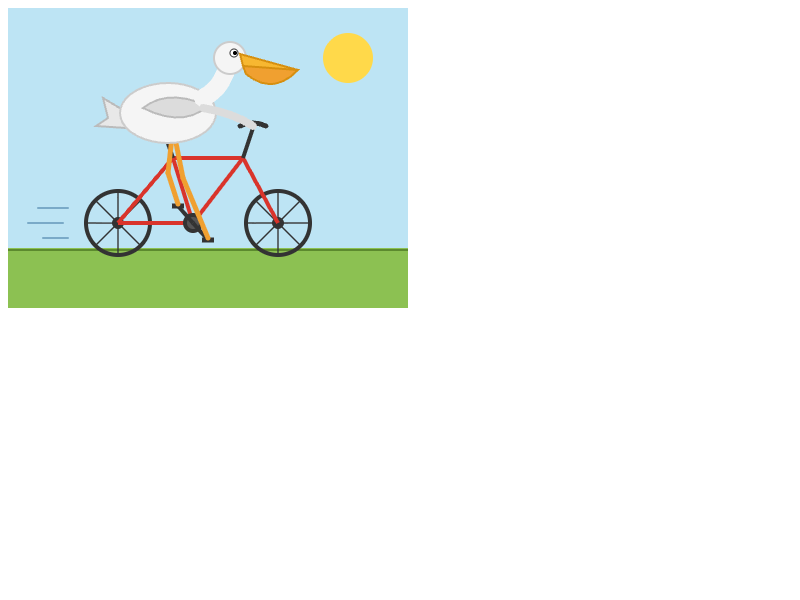
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Gemini 3.6 Flash
Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.
Reasoning (angefragt): high
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Fable 5.1 und Gemini 3.6 Flash mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.