Zum Hauptinhalt springen

InclusionAISprachmodellAktiv

Ling 3.1 Flash

Für Ling 3.1 Flash gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

Leistungnoch ohne Platz

k. A.Gesamtindexhöher ist besser

TempoPlatz 15 von 101

174Token pro Sekundehöher ist besser

Preiskein API-Preis

k. A.je 1 Mio. Tokenniedriger ist besser

KontextPlatz 31 von 102

1 Mio.Token auf einmal≈ 1.500 A4-Seiten

BeliebtheitPlatz 236 von 875

42von 100+1 zum Vormonat

Zusammenfassung

Mit 174 Token pro Sekunde schreibt es schneller als ein typisches Modell (87).

Ling 3.1 Flash aktiviert 25 Milliarden seiner insgesamt 560 Milliarden Parameter pro Token. InclusionAIs hybrides Reasoning-Modell verarbeitet im Vercel AI Gateway 262K Token Kontext.

Laut Modellkarte stehen die Gewichte unter MIT und der Checkpoint verarbeitet 1M Token Kontext. Das Vercel AI Gateway führt das Modell über einen eigenen API-Zugang mit 262K Token Kontext.

Selbst ansehen: ein Auftrag, ein Versuch

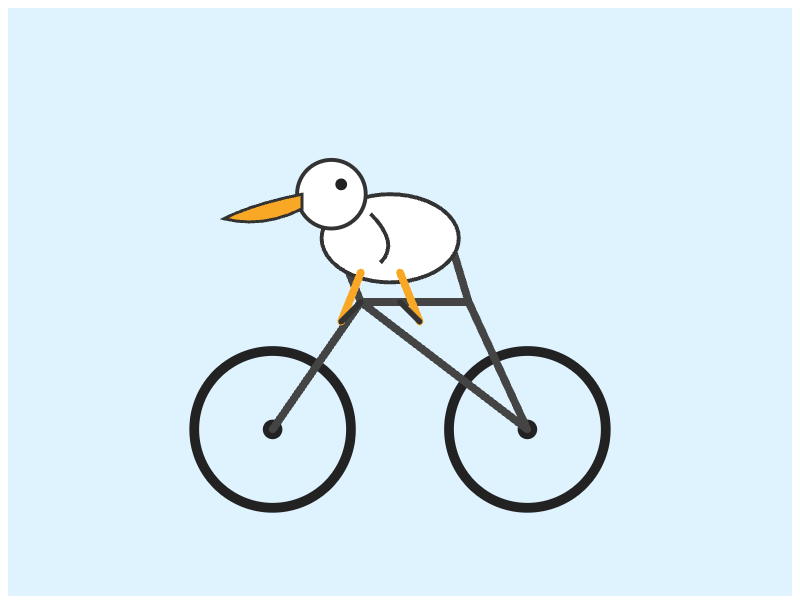
SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Ling 3.1 Flash

Ling 3.1 Flash: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0002 $

Testdetails
Testlauf
14.10.2026
Anbieter
novita
API-Modell
inclusionai/ling-3.1-flash
Ausgabe
667 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0002 $
Testrunde
43b8c5c46830
Frühere Tests

In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

05.10.2026

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
05.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
inclusionai/ling-3.1-flash
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Festgelegter Endpunkt
Novita | inclusionai/ling-3.1-flash-20261002
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt
Ursprung der Aufgabe: Simon Willison

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 75 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 7

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

CritPt v2: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
18
Bewertung
18
Messgröße
pass@1 accuracy
Einheit
%
Benchmark-Version
v2
Kategorie
reasoning
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
disputed
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Kennung des Quellmodells: artificial-analysis/a6043b9b-628a-4a76-a021-2834e0627d05/ling-3-1-flash/ling-3-1-flash. Name des Quellmodells: Ling 3.1 Flash. Anbieter laut Quelle: InclusionAI. Modellstand: Ling 3.1 Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled. Angezeigter Wert: 18,0 %. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-critpt-v2:v2:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. Der vollständige CritPt-v2-Lauf umfasst 70 Fragen mit fünf Wiederholungen. Der offizielle Grading-Server bewertet pass@1.. Werkzeugrichtlinie: Python functions, symbolic expressions, and numerical answers; official grading server. Versuche: 70 questions, five repeats per question, pass@1. Reasoning: reasoning enabled
Einordnung
Die AA-Quelle enthält hier den ursprünglichen CritPt-Wert. Die frühere Zuordnung zu CritPt v2 ist falsch; Wert und frühere Beschriftung bleiben als strittiger Altbeleg erhalten.. Der Quelldatensatz markiert diesen Wert als umstritten. Er bleibt als dokumentierte Evidenz sichtbar, ist aber kein belastbarer Vergleichsnachweis.
Quelle Artificial Analysis
GSM8K completion stop rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
99.77
Bewertung
99.77
Messgröße
completion stop rate, H200 NEXTN Low-Latency
Einheit
%
Richtung
Keine Richtung veröffentlicht
Quellentyp
independent-evaluator
Auswertung
SGLang Documentation, Ling-3.1-flash cookbook
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. SGLang-GSM8K-Abschluss-Stop-Rate für das H200-NEXTN-Low-Latency-Rezept. Derselbe Abschnitt nennt eine Evaluierung aller 1.319 Fragen; die veröffentlichte Stop-Rate-Zeile nennt jedoch weder den Nenner der abgeschlossenen Läufe noch Wiederholungen oder KI.
Einordnung
Dies ist eine Prüfung der Generierungs-Stop-/Abschlussrate, keine GSM8K-Antwortgenauigkeit. Die Quelle nennt für die angezeigte Stop-Rate weder den Nenner abgeschlossener Läufe noch Wiederholungen oder KI.
Quelle SGLang Documentation, Ling-3.1-flash cookbook
GSM8K completion stop rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
99.92
Bewertung
99.92
Messgröße
completion stop rate, H200 NEXTN High-Throughput
Einheit
%
Richtung
Keine Richtung veröffentlicht
Quellentyp
independent-evaluator
Auswertung
SGLang Documentation, Ling-3.1-flash cookbook
Status
active
Abrufdatum
2026-10-19
Methodik
Unabhängige Evaluation. SGLang-GSM8K-Abschluss-Stop-Rate für das H200-NEXTN-High-Throughput-Rezept. Derselbe Abschnitt nennt eine Evaluierung aller 1.319 Fragen; die veröffentlichte Stop-Rate-Zeile nennt jedoch weder den Nenner der abgeschlossenen Läufe noch Wiederholungen oder KI.
Einordnung
Dies ist eine Prüfung der Generierungs-Stop-/Abschlussrate, keine GSM8K-Antwortgenauigkeit. Die Quelle nennt für die angezeigte Stop-Rate weder den Nenner abgeschlossener Läufe noch Wiederholungen oder KI.
Quelle SGLang Documentation, Ling-3.1-flash cookbook
GDPval-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1626.38
Bewertung
1626.38
Messgröße
GDPval-AA Elo
Einheit
Elo
Benchmark-Version
v2.1
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-11-02
Methodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Kennung des Quellmodells: artificial-analysis/a6043b9b-628a-4a76-a021-2834e0627d05/ling-3-1-flash/ling-3-1-flash. Name des Quellmodells: Ling 3.1 Flash. Anbieter laut Quelle: InclusionAI. Modellstand: Ling 3.1 Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-02-67d46be20a5b. Prüfsumme der Quelldaten: 67d46be20a5b412db6cfb60ad190441fcaa5513500b8fd47d033168d0e97b6b2. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-11-02. Quellenkohorte: artificial-analysis-gdpval-aa:v2.1:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
GDPval-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1626.56
Bewertung
1626.56
Messgröße
GDPval-AA Elo
Einheit
Elo
Benchmark-Version
v2.1
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
superseded
Abrufdatum
2026-10-29
Methodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Kennung des Quellmodells: artificial-analysis/a6043b9b-628a-4a76-a021-2834e0627d05/ling-3-1-flash/ling-3-1-flash. Name des Quellmodells: Ling 3.1 Flash. Anbieter laut Quelle: InclusionAI. Modellstand: Ling 3.1 Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-10-29-5a1b1cf41cd1. Prüfsumme der Quelldaten: 5a1b1cf41cd14d4fa7e1b5c737732505ff7f014395c8a19ff9385c13df09b106. Parserversion: artificial-analysis-rsc-models-v3. Importiert am: 2026-10-29. Quellenkohorte: artificial-analysis-gdpval-aa:v2.1:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). AA-Quellenwert für durchschnittliche Reasoning-Tokens vor der Antwort: 2.000. Die Methodik mittelt 60 unterschiedliche Prompts und setzt 2.000 an, wenn kein Durchschnitt verfügbar ist. Das ist kein Tokenlimit. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled
Einordnung
Dieser Wert wird als historische Evidenz geführt und ist nicht mit aktuellen Ergebnissen gleichzusetzen.
Quelle Artificial Analysis
GDPval-AA: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1626.38
Bewertung
1626.38
Messgröße
GDPval-AA Elo
Einheit
Elo
Benchmark-Version
v2.1
Kategorie
agentic
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-11-06
Methodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Kennung des Quellmodells: artificial-analysis/a6043b9b-628a-4a76-a021-2834e0627d05/ling-3-1-flash/ling-3-1-flash. Name des Quellmodells: Ling 3.1 Flash. Anbieter laut Quelle: InclusionAI. Modellstand: Ling 3.1 Flash. Evaluator: Artificial Analysis. Datensatztyp: artificial-analysis-evaluation. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled. Quellenkennung: artificial-analysis. Kennung der Evidenzaufnahme: aa-model-page-2026-11-06-ec1194e008b3. Prüfsumme der Quelldaten: ec1194e008b3638ef60dbf5249daf9e6047364e22905e745a4af64c5f3f080fe. Parserversion: artificial-analysis-rsc-models-v4. Importiert am: 2026-11-06. Quellenkohorte: artificial-analysis-gdpval-aa:v2.1:standalone:reasoning:effort=unspecified:suffix=unspecified
Vergleichsmethodik
Exakte AA-Konfiguration: Ling 3.1 Flash (Release ling-3-1-flash, Zeile ling-3-1-flash, UUID a6043b9b-628a-4a76-a021-2834e0627d05, reasoning=true, effort=nicht angegeben, suffix=nicht angegeben). Diese Quellenfassung enthält keine durchschnittliche Reasoning-Tokenzahl. 220 Aufgaben mit je einem Lauf. AA wertet die Ergebnisse durch paarweise Vergleiche eines Expertenpanels aus und verankert die Elo-Skala bei DeepSeek V4.1 Flash (Max) auf 1.600.. Harness: Artificial Analysis Stirrup. Agent: Stirrup agent. Werkzeugrichtlinie: Agentic task completion with file outputs. Versuche: 220 tasks, one run per task; panel pairwise judgments. Reasoning: reasoning enabled
Quelle Artificial Analysis
Artificial Analysis Intelligence Index (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
41.0906200397391
Bewertung
41.0906200397391
Messgröße
Artificial Analysis Intelligence Index
Einheit
points
Benchmark-Version
Artificial Analysis Intelligence Index v4.3.2
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. Artificial Analysis independent evaluation on dedicated hardware; the exact page identifies Ling 3.1 Flash as reasoning-enabled with 2,000 reasoning tokens.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe.
Quelle Artificial Analysis
AA-Briefcase (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1400.35
Bewertung
1400.35
Messgröße
AA-Briefcase
Einheit
elo
Benchmark-Version
AA-Briefcase v1.1
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. 91-task agentic knowledge-work evaluation; the AA page describes a combined Elo over rubric pass rate, analytical-quality Elo and presentation Elo.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe.
Quelle Artificial Analysis
GDPval-AA (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
1621.75
Bewertung
1621.75
Messgröße
GDPval-AA
Einheit
elo
Benchmark-Version
GDPval-AA v2.1
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. 220 real-world work tasks, agent loop with shell/web access via Stirrup, blind pairwise comparisons; AA evaluator result for the exact Ling 3.1 Flash slug.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe.
Quelle Artificial Analysis
AutomationBench-AA (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.6174373352506193
Bewertung
0.6174373352506193
Messgröße
AutomationBench-AA
Einheit
ratio
Benchmark-Version
AutomationBench-AA (dataset version 1.0.6 noted on evaluator page)
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. 657 simulated SaaS workflow tasks across six business domains; exact model result from AA's dedicated-hardware evaluator.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe.
Quelle Artificial Analysis
Terminal-Bench (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.333333333333333
Bewertung
0.333333333333333
Messgröße
Terminal-Bench
Einheit
ratio
Benchmark-Version
Terminal-Bench 4.0
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
active
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. AA page states pass@1 averaged over three repeats per task with the mini-swe-agent harness; exact Ling result.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe.
Quelle Artificial Analysis
SciCode (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.540509259259259
Bewertung
0.540509259259259
Messgröße
SciCode
Einheit
ratio
Benchmark-Version
SciCode current AA implementation
Kategorie
source-specific
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Artificial Analysis
Status
disputed
Abrufdatum
2026-10-04
Methodik
Unabhängige Evaluation. 288 test-set subproblems from scientist-curated laboratory problems; independent AA evaluation of the exact checkpoint.
Einordnung
Quellenspezifische Beobachtung, keine gemeinsame Vergleichsgruppe. Die Auswertung ist beim Evaluator noch als „Under review“ markiert.
Quelle Artificial Analysis

Seite 1 von 7

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 5. November 2026

Ling 3.1 FlashDevstral SmallK2 Horizon 32BNaive-N0.5-FlashGLM-4.6V

Alle technischen Daten

Architektur

Modellklasse
Hybrides Reasoning-Sprachmodell
Quelle: Modellklasse
Parameter
560 Milliarden insgesamt, 25 Milliarden aktiv
Quelle: Parameter

Ein- und Ausgabe

Kontextfenster
1.000.000 Token laut Modellkarte
Quelle: Kontextfenster

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Zugang
Vercel AI Gateway API
Quelle: Zugang

API

Modellkennung
inclusionai/ling-3.1-flash
Quelle: Modellkennung

Weitere Angaben

API-Kontextfenster
262K Token laut Vercel AI Gateway
Quelle: API-Kontextfenster
Lokale Ausführung
Modellkarte dokumentiert Ausführung mit SGLang und vLLM
Quelle: Lokale Ausführung

Preise

Kein Abo von InclusionAI mit diesem Modell. Über andere Anbieter ab ≈ 1,06 € im Monat (Command Code Go, mit begrenztem Guthaben). 5 Tarife in Deutschland.

TarifPreis im MonatHinweis
Command Code Go≈ 1,06 €mit begrenztem Guthaben
Command Code GOAT≈ 10,60 €mit begrenztem Guthaben
Command Code Pro≈ 21,20 €mit begrenztem Guthaben
Command Code Max 10×≈ 106,02 €mit begrenztem Guthaben
Command Code Max 20×≈ 212,05 €mit begrenztem Guthaben

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Ling 3.1 Flash

Wie groß ist das Kontextfenster von Ling 3.1 Flash?

1 Mio. Token. So viel Text liest Ling 3.1 Flash auf einmal, das sind rund 1.500 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
Ling 3.1 FlashPlatz 31 von 1021 Mio.
Claude Opus 5.51 Mio.
Gemini 4 Carbon1 Mio.
Claude Fable 5.11 Mio.
Claude Sonnet 5.51 Mio.
Muse Wonder Full1 Mio.
Claude Opus 51 Mio.

Wie schnell ist Ling 3.1 Flash?

174 Token pro Sekunde. Das ist schneller als ein typisches Modell mit 87.

Gemessen von Artificial Analysis am 06.11.2026. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt.

TempoToken pro Sekunde · höher ist besser
Gemini 3 Flash Preview191
Gemini 3.5 Flash184
Gemini 3.6 Flash182
DeepSeek-V4.1-Flash176
Ling 3.1 FlashPlatz 15 von 101174
DeepSeek V4.1 Flash 1017172
Qwen 3.7 Max165

Kann ich Ling 3.1 Flash lokal nutzen?

Ja, die Gewichte sind offen. Mit 560 Mrd. Parametern braucht es aber sehr viel Speicher, eher einen Server als einen Laptop.

Angaben von InclusionAI

Offene Gewichte
ja
Lizenz
MIT
Parameter
560 Mrd.
davon aktiv je Token
25 Mrd.

Wo kann ich Ling 3.1 Flash nutzen?

Nicht im Abo von InclusionAI. Zusammen mit anderen Anbietern sind es 5 Tarife in Deutschland.

Abo-Vergleich, Preise in Deutschland inkl. USt

Bei InclusionAI

Kein Abo von InclusionAI mit diesem Modell.

Über andere Anbieter

5 Tarife bei 1 Anbieter, ab ≈ 1,06 € im Monat (Command Code Go), mit begrenztem Guthaben.

Quellen und Datenstand

Alle 28 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Artificial Analysis8110

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Geschwindigkeit

InclusionAI, Reasoning enabled; effort unspecified. AA 3.0.0, einschließlich Zeit bis zum ersten Token, über verfügbare Workloads und fünf Tage gemittelt. Abgerufen am 6. November 2026.

RecherchestandRecherchestand 4. Oktober 2026. 21 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Ungeklärt

scicode-and-critpt-evaluation-status

Originalwortlaut

Artificial Analysis labels the SciCode and CritPt observations Under review. They are retained as disputed observations and do not establish confirmed benchmark coverage.

Nicht veröffentlicht

score scale, denominator, serving revision and confidence interval

Hinweis

Die geprüfte Quelle veröffentlicht für diese Scorezellen nicht alle Einheiten, Nenner, Serving-Revisionen oder Konfidenzintervalle; unbekannte Werte bleiben offen.

Nicht veröffentlicht

GameBench 2 Gruppe Intensive

Hinweis

Diese Gruppe wird laut Quelle vom Modell nicht unterstützt.

Nicht veröffentlicht

GameBench 2 Gruppe Balanced

Hinweis

Für diese Gruppe ist laut Quelle kein Ergebnis veröffentlicht.

Weitere QuelleVercel AI Gateway Ling 3.1 Flash (abgerufen 3. Oktober 2026; 4. Oktober 2026) · Vercel AI Gateway Ling 3.1 Flash · Redaktionelle Beschreibung geprüft am 25. Oktober 2026
Weitere QuelleInclusionAI Ling 3.1 Flash model card (abgerufen 17. Oktober 2026; 25. Oktober 2026) · InclusionAI Ling 3.1 Flash model card · Redaktionelle Beschreibung geprüft am 25. Oktober 2026
Weitere QuelleArtificial Analysis (abgerufen 4. Oktober 2026; 2. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 4. Oktober 2026; 29. Oktober 2026; 2. November 2026; 6. November 2026)
Weitere QuelleArtificial Analysis (abgerufen 4. Oktober 2026)12345678
Weitere QuelleDataLLM Lab (abgerufen 17. Oktober 2026)
Weitere QuelleMathBench AI, Ling-3.1-flash results (abgerufen 17. Oktober 2026)
Weitere QuelleSGLang Documentation, Ling-3.1-flash cookbook (abgerufen 19. Oktober 2026)
Weitere QuelleDataLLM Lab (abgerufen 17. Oktober 2026; 19. Oktober 2026)
Weitere QuelleDuelLab GameBench 2 model results (abgerufen 28. Oktober 2026; 2. November 2026; 5. November 2026)
Weitere QuelleModellmetadaten (abgerufen 4. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)12
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0