Zum Hauptinhalt springen

AlibabaSprachmodell

Qwen2.5-VL 72B Instruct

Für Qwen2.5-VL 72B Instruct gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen.

BeliebtheitPlatz 497 von 875

28von 100wie im Vormonat

Zusammenfassung

Qwen2.5-VL 72B Instruct wurde am 26. Januar 2025 veröffentlicht. Der konkrete Instruct-Checkpoint liegt im Repository Qwen/Qwen2.5-VL-72B-Instruct. Er analysiert visuelle Dokumente, erkennt Text und Layouts und findet relevante Stellen in Videos. Lokalisierte Bildbereiche lassen sich als Bounding Boxes, Punkte und strukturierte JSON-Daten ausgeben.

Das offene Modell verarbeitet Text, Bilder und Videos und gibt Text aus. Der Katalog führt 72 Milliarden Parameter, 131.072 Token Kontext und höchstens 8.192 Ausgabe-Token. Das Instruct-Finetuning zielt auf direkte Chat- und Extraktionsaufgaben und unterscheidet den Checkpoint vom Base-Modell.

Selbst ansehen: ein Auftrag, ein Versuch

Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

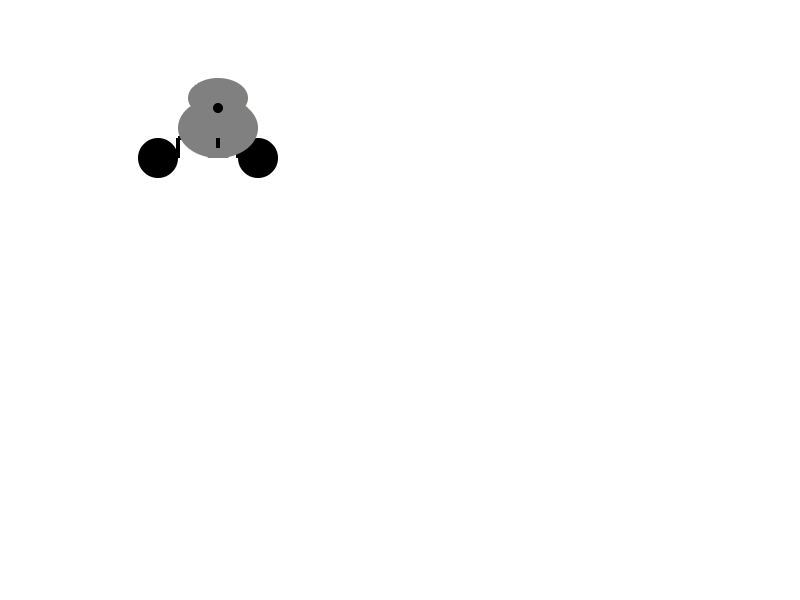
Qwen2.5-VL 72B Instruct: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

01.10.2026 · 9,2 s · 0,0006 $

Testdetails
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
qwen/qwen2.5-vl-72b-instruct
Reasoning-Einstellung
nicht vorgegeben
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
604 Token
Kosten des Versuchs
0,0006 $
Antwortzeit
9,2 s
API-Modell laut Antwort
qwen/qwen2.5-vl-72b-instruct
Festgelegter Endpunkt
Parasail | qwen/qwen2.5-vl-72b-instruct
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Ursprung der Aufgabe: Simon Willison
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Qwen2.5-VL 72B Instruct

Kein unabhängiger Test. Dieser API-Zugang ist ein Alias von qwen-2.5-vl-72b.

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 118 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 10

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

AndroidWorld success rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
35
Bewertung
35
Messgröße
success rate
Einheit
%
Benchmark-Version
AndroidWorld_SR
Kategorie
agent
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Qwen Team Qwen2.5-VL-72B-Instruct model card
Status
active
Abrufdatum
2026-10-15
Methodik
Vom Anbieter veröffentlichter Wert. Exakte Modellzeile bzw. Benchmark-Widget für Qwen2.5-VL-72B-Instruct. Quelle: „Qwen Team Qwen2.5-VL-72B-Instruct model card“. Benchmark-Prompt, Sampling-/Decoding-Einstellungen, Reasoning-Aufwand, Quantisierung und Ausführungsdatum sind im zitierten Ergebnis nicht angegeben; dazu werden keine Annahmen getroffen.
Quelle Qwen Team Qwen2.5-VL-72B-Instruct model card
AEGIS FSD accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
37.63
Bewertung
37.63
Messgröße
Forgery Scope Discrimination single-choice accuracy (ACC), percent of evaluated cases correct
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS FSD macro-F1 (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
33.16
Bewertung
33.16
Messgröße
Forgery Scope Discrimination macro-averaged F1, reported as percent
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS TAR accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
70.81
Bewertung
70.81
Messgröße
Textual Artifact Recognition accuracy (ACC), percent of evaluated cases correct
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS TAR macro-F1 (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
70.76
Bewertung
70.76
Messgröße
Textual Artifact Recognition macro-averaged F1, reported as percent
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS MC accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
51.76
Bewertung
51.76
Messgröße
Manipulation Classification accuracy (ACC), percent of evaluated cases correct
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS MC macro-F1 (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
35.96
Bewertung
35.96
Messgröße
Manipulation Classification macro-averaged F1, reported as percent
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS TP region-level Correct Localization Accuracy (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
32.29
Bewertung
32.29
Messgröße
Tampering Pinpointing region-level Correct Localization Accuracy (CLA), percent of evaluated cases meeting the paper's localization rule
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
AEGIS TP Over Localization Rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
0.53
Bewertung
0.53
Messgröße
Tampering Pinpointing Over Localization Rate (OLR), percent of cases with excessive predicted regions; lower is better
Einheit
%
Benchmark-Version
AEGIS Table 2; ACL 2026 Long Papers, July 2026
Kategorie
multimodal
Richtung
Weniger ist besser
Quellentyp
independent-evaluator
Auswertung
AEGIS, ACL 2026, Table 2
Status
active
Abrufdatum
2026-10-16
Methodik
Unabhängige Evaluation. AEGIS-Hauptergebnis aus Tabelle 2 für die exakte Zeile „Qwen2.5-VL-72B“. Anhang B.2 nennt als Zugangsroute https://bailian.console.aliyun.com/cn-beijing?tab=model#/model-market/detail/qwen2.5-vl-72b-instruct?serviceSite=asia-pacific-china. Die Studie nennt hochauflösende PNG-Eingaben. Die Gesamtgröße des Datensatzes von 8.210 Beispielen ist nicht N dieser Metrik. Aufgabenspezifischer Nenner, Anfragedatum, Temperatur, weitere Decoding-Einstellungen und unveränderlicher Serving-Checkpoint sind nicht veröffentlicht.
Einordnung
Dies ist ein AEGIS-Ergebnis zur Forensik akademischer Bilder, kein allgemeiner Modellqualitätsscore. Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder unveränderlichen Serving-Checkpoint noch Anfragedatum.
Quelle AEGIS, ACL 2026, Table 2
MobileMiniWob++ success rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
68
Bewertung
68
Messgröße
success rate
Einheit
%
Benchmark-Version
Qwen2.5-VL model card revision 89c86200743eec961a297729e7990e8f2ddbc4c5
Kategorie
agent
Richtung
Mehr ist besser
Quellentyp
vendor-reported
Auswertung
Qwen2.5-VL-72B-Instruct model card, Qwen Team
Status
active
Abrufdatum
2026-10-17
Methodik
Vom Anbieter veröffentlichter Wert. Exakte Spalte Qwen2.5VL-72B in der Agenten-Benchmarktabelle der gepinnten Modellkarte. Die Karte nennt weder Testdatum, Prompts, Decoding-Einstellungen, Quantisierung noch die je Aufgabe gewerteten Nenner.
Quelle Qwen2.5-VL-72B-Instruct model card, Qwen Team
Creation-MMBench (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
13.2
Bewertung
13.2
Messgröße
Pairwise win rate versus GPT-4o-1120 baseline
Einheit
%
Benchmark-Version
ICCV 2025 supplement, Table 5
Kategorie
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Creation-MMBench authors, ICCV 2025 supplement
Status
active
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. Exakte Zeile in Tabelle 5: Qwen2.5-VL-72B-Instruct. Die Win-Rate bezieht sich auf paarweise GPT-4o-Vergleiche mit GPT-4o-1120 und vertauschten Antwortpositionen. Dieselbe Tabelle nennt sechs deutlich bessere, 196 bessere, 984 gleiche, 302 schlechtere, 42 deutlich schlechtere und null fehlgeschlagene Urteile.
Einordnung
Die ausgewiesenen Ergebniszahlen summieren sich auf 1.530 Judge-Urteile aus doppelten Evaluationen und nicht auf unabhängige Benchmark-Fälle. Daraus wird kein sampleCount abgeleitet. Der Bericht nennt weder eine unveränderliche Checkpoint-Revision noch den Inferenzweg oder ein modellbezogenes Testdatum.
Quelle Creation-MMBench authors, ICCV 2025 supplement
GitChameleon 2.0 Qwen 2.5-VL Instruct 72B Greedy decoding hidden success rate (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
48.2
Bewertung
48.2
Messgröße
Greedy decoding hidden success rate
Einheit
%
Benchmark-Version
GitChameleon 2.0, ACL 2026
Kategorie
code-agent
Richtung
Mehr ist besser
Stichprobe
328
Quellentyp
independent-evaluator
Auswertung
GitChameleon 2.0, ACL 2026 paper
Status
active
Abrufdatum
2026-10-17
Methodik
Unabhängige Evaluation. GitChameleon 2.0, exakte öffentlich benannte Modellvariante. Die Studie evaluiert 328 manuell erstellte, versionsgebundene Python-API-Änderungsaufgaben mit Hidden Tests. Serving-Revision und vollständige Decoding-Parameter sind nicht angegeben. Qwen 2.5-VL Instruct 72B; Tabelle 1 berichtet Greedy-Decoding, Greedy mit Self-Debug und Zero-Shot-Chain-of-Thought. Hidden-/Visible-Testvarianten bleiben getrennt.
Einordnung
Die Tabelle druckt ±-Werte, nennt aber weder ihre statistische Bedeutung noch ein Konfidenzniveau; es wird kein KI-Feld gesetzt. Die verwendete Serving-Revision ist nicht gepinnt.
Quelle GitChameleon 2.0, ACL 2026 paper

Seite 1 von 10

Beliebtheit im Vergleich

Wie oft das Modell gesucht, genutzt und erwähnt wird, im Vergleich mit allen Modellen dieser Kategorie.

Beliebtheitsindex

Die 100 beliebtesten Modelle dieser Kategorie, 0 bis 100, höher ist beliebter

20 von 101 Modellen

Stand November 2026 · Quelle: gradually.ai Beliebtheitsindex

Zeitlicher Verlauf

Wochenwerte vom 18. Oktober 2026 bis 5. November 2026

Qwen2.5-VL 72B InstructGLM-4.7-FlashXMiniMax-M2.7-highspeedOLMo 2 13BQwen3 VL 235B A22B Instruct

Alle technischen Daten

Architektur

Parameter
72 Mrd.
Quelle: Parameter
Knowledge Cutoff
April 2024
Quelle: Knowledge Cutoff

Ein- und Ausgabe

Kontextfenster
131.072 Token
Quelle: Kontextfenster
Maximale Ausgabe
8.192 Token
Quelle: Maximale Ausgabe
Eingaben
Text, Bild, Video
Quelle: Eingaben
Ausgaben
Text
Quelle: Ausgaben
Tool-Aufrufe
Ja
Quelle: Tool-Aufrufe

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Watermarking-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Gewichte
Open Weights
Quelle: Gewichte
Lizenz
Qwen License
Quelle: Lizenz

Preise

In keinem Abo in Deutschland enthalten.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Qwen2.5-VL 72B Instruct

Bis wann reicht das Wissen von Qwen2.5-VL 72B Instruct?

Bis April 2024, laut Alibaba. Das ist 9 Monate vor der Veröffentlichung.

Angabe von Alibaba

Wie groß ist das Kontextfenster von Qwen2.5-VL 72B Instruct?

131.072 Token. So viel Text liest Qwen2.5-VL 72B Instruct auf einmal, das sind rund 200 A4-Seiten.

Seitenzahl als Faustregel nach Artificial Analysis

KontextfensterToken, die das Modell auf einmal liest · höher ist besser
GLM-5.1200 Tsd.
DeepSeek-V3 0324164 Tsd.
Qwen2.5-VL 72B InstructPlatz 93 von 102131 Tsd.
GLM-4.5131 Tsd.
GPT OSS 120B131 Tsd.
DeepSeek-V3.2128 Tsd.
DeepSeek-R1128 Tsd.

Kann ich Qwen2.5-VL 72B Instruct lokal nutzen?

Ja, die Gewichte sind offen.

Angaben von Alibaba

Offene Gewichte
ja
Lizenz
Qwen License
Parameter
72 Mrd.
davon aktiv je Token
k. A.

Quellen und Datenstand

Alle 21 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
Eingabe

Dokumentierte Modalitäten. Abgerufen am 2. Oktober 2026.

Ausgabe

Dokumentierte Modalitäten. Abgerufen am 27. Oktober 2026.

RecherchestandRecherchestand 15. Oktober 2026. 13 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

evaluation-protocol

Hinweis

Die Modellkarte veröffentlicht Benchmarktabellen, nennt für diese Zeilen jedoch weder die exakten Inferenz-Prompts noch Quantisierung, Reasoning-Aufwand oder Ausführungsdaten.

Nicht veröffentlicht

evaluation-denominator

Hinweis

AEGIS nennt insgesamt 8.210 Datensatzbeispiele, veröffentlicht aber keinen Nenner gültiger oder ausgewerteter Fälle für jede Metrik in Tabelle 2.

Ungeklärt

serving-snapshot

Hinweis

Die Studie nennt Modellbezeichnung und Zugangsroute, aber weder das Datum der Modellanfrage noch eine unveränderliche Provider-Version.

Nicht veröffentlicht

evaluation-protocol-and-units

Hinweis

Die gepinnte Karte nennt weder Testdaten noch aufgabenspezifische Nenner, Prompts oder Decoding-Einstellungen. Die Score-Einheit bleibt unbekannt, außer bei der ausdrücklich als Prozent ausgewiesenen MobileMiniWob++ Erfolgsrate.

Nicht veröffentlicht

Creation-MMBench category sample counts and exact model revision

Hinweis

Der Bericht nennt insgesamt 765 Fragen, aber keine Fallzahlen je Kategorie, kein modellbezogenes Testdatum und keine unveränderliche Checkpoint-Revision oder Inferenzroute.

Weitere Quelleqwenlm.github.io (abgerufen 2. Oktober 2026) · Qwen2.5-VL official release · Redaktionelle Beschreibung geprüft am 2. Oktober 2026
Weitere QuelleAEGIS, ACL 2026, Table 2 (abgerufen 16. Oktober 2026)
Weitere QuelleQwen2.5-VL-72B-Instruct model card, Qwen Team (abgerufen 17. Oktober 2026)
Weitere QuelleCreation-MMBench authors, ICCV 2025 (abgerufen 17. Oktober 2026)
Weitere QuelleCreation-MMBench authors, ICCV 2025 supplement (abgerufen 17. Oktober 2026)
Weitere QuelleGitChameleon 2.0, ACL 2026 paper (abgerufen 17. Oktober 2026)
Weitere QuelleBenchmarking large multimodal models for ophthalmic visual question answering with OphthalWeChat (abgerufen 17. Oktober 2026)
Weitere QuelleGeoLaux: A Benchmark for Evaluating MLLMs’ Geometry Performance on Long-Step Problems Requiring Auxiliary Lines (abgerufen 17. Oktober 2026)
Weitere QuelleBeyond Screenshots: Evaluating VLMs’ Understanding of UI Animations (abgerufen 18. Oktober 2026)
Weitere QuelleSciVideoBench authors (abgerufen 19. Oktober 2026)
Weitere QuelleReasonMap project page (abgerufen 23. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 17. Oktober 2026)
Weitere QuelleModellmetadaten (abgerufen 19. Oktober 2026)
Weitere QuelleOpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleVercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0
Weitere QuelleOllama: kumulierte Downloads für den Beliebtheitsindex
Weitere QuelleReplicate: kumulierte Ausführungen für den Beliebtheitsindex
Weitere QuelleGoogle Trending Now: begrenzte Feed-Auswahl für Deutschland und USA
Weitere QuelleCreative Commons Attribution 4.0