Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
48
verschiedene Benchmarks
21
jüngster Abruf
29.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Allgemeine Daten von Grok 4.3 und Mistral Medium 3.5
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Anbieterpreise von Grok 4.3 und Mistral Medium 3.5
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Grok 4.3
Mistral Medium 3.5
Coding: 100 / 70,7 (4 Benchmarkfamilien)
Reasoning: 100 / 68,6 (2 Benchmarkfamilien)
Mathematik: 99,4 / 100 (1 Benchmarkfamilie)
Wissen: 100 / 93,4 (2 Benchmarkfamilien)
Finanzen: 100 / 80,9 (7 Benchmarkfamilien)
Recht: 100 / 86,4 (3 Benchmarkfamilien)
Agenten-Aufgaben: 100 / 81,3 (1 Benchmarkfamilie)
Gesundheit: 100 / 92,5 (3 Benchmarkfamilien)
48 passende Messreihen aus 20 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 11 vergleichbaren Kategorien.
Grok 4.3Mistral Medium 3.5
Code MigrationOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner6,795 %
Mistral Medium 3.55,127 %
CorpFin v2Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner68,532 %
Mistral Medium 3.558,78 %
EMBOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner18,394 %
Mistral Medium 3.511,185 %
Finance Agent (v2)Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner37,728 %
Mistral Medium 3.532,103 %
GPQA DiamondOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner91,414 %
Mistral Medium 3.534,848 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gleichstand0,417 %
Mistral Medium 3.5Gleichstand0,417 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner15,385 %
Mistral Medium 3.59,135 %
LMArena Text, Style ControlOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner1.441,593
Mistral Medium 3.51.426,128
MedCodeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner38,068 %
Mistral Medium 3.533,752 %
MedScribeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner74,399 %
Mistral Medium 3.567,728 %
MMLU-ProOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner85,838 %
Mistral Medium 3.575,335 %
MortgageTaxOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Grok 4.3Gewinner48,252 %
Mistral Medium 3.528,895 %
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Benchmarkwerte von Grok 4.3 und Mistral Medium 3.5
Benchmark und Aufgabe
Grok 4.3
Mistral Medium 3.5
Quelle
Code MigrationOverallTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besser
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 71.054 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 11.693 anonymen Paarvergleichen.
Gewinner1.441,593
95-%-Konfidenzintervall: ±3,641Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.426,128
95-%-Konfidenzintervall: ±6,42Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 14.291 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 2.256 anonymen Paarvergleichen.
Kein klarer Vorsprung1.439,761
95-%-Konfidenzintervall: ±6,298Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.430,173
95-%-Konfidenzintervall: ±12,827Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 4.531 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 621 anonymen Paarvergleichen.
Kein klarer Vorsprung1.477,707
95-%-Konfidenzintervall: ±9,633Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.446,524
95-%-Konfidenzintervall: ±23,931Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 19.949 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 3.282 anonymen Paarvergleichen.
Kein klarer Vorsprung1.488,001
95-%-Konfidenzintervall: ±5,656Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.477,898
95-%-Konfidenzintervall: ±10,854Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 12.909 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 1.999 anonymen Paarvergleichen.
Gewinner1.422,565
95-%-Konfidenzintervall: ±6,566Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.397,828
95-%-Konfidenzintervall: ±13,94Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 32.389 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 5.562 anonymen Paarvergleichen.
Kein klarer Vorsprung1.451,053
95-%-Konfidenzintervall: ±4,742Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.442,84
95-%-Konfidenzintervall: ±8,53Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlEntertainment, sports and mediaTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 16.950 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 2.618 anonymen Paarvergleichen.
Gewinner1.415,952
95-%-Konfidenzintervall: ±5,995Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.394,24
95-%-Konfidenzintervall: ±12,151Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 54.500 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 8.856 anonymen Paarvergleichen.
Gewinner1.440,278
95-%-Konfidenzintervall: ±4,803Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.419,562
95-%-Konfidenzintervall: ±8,482Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 7.511 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 1.205 anonymen Paarvergleichen.
Kein klarer Vorsprung1.452,353
95-%-Konfidenzintervall: ±7,918Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.433,7
95-%-Konfidenzintervall: ±17,235Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 2.579 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 453 anonymen Paarvergleichen.
Kein klarer Vorsprung1.462,083
95-%-Konfidenzintervall: ±13,943Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.435,855
95-%-Konfidenzintervall: ±29,943Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 1.041 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 173 anonymen Paarvergleichen.
1.439,453
95-%-Konfidenzintervall: ±19,291Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.447,96
95-%-Konfidenzintervall: ±43,885Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 47.683 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 7.627 anonymen Paarvergleichen.
Kein klarer Vorsprung1.456,21
95-%-Konfidenzintervall: ±4,348Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.444,677
95-%-Konfidenzintervall: ±7,686Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 22.338 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 3.821 anonymen Paarvergleichen.
Kein klarer Vorsprung1.462,76
95-%-Konfidenzintervall: ±5,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.455,806
95-%-Konfidenzintervall: ±10,148Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 25.157 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 3.827 anonymen Paarvergleichen.
1.414,928
95-%-Konfidenzintervall: ±5,274Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.420,763
95-%-Konfidenzintervall: ±10,011Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 1.126 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 188 anonymen Paarvergleichen.
Kein klarer Vorsprung1.406,339
95-%-Konfidenzintervall: ±19,258Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.392,677
95-%-Konfidenzintervall: ±43,291Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLegal and governmentTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 5.787 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 893 anonymen Paarvergleichen.
Kein klarer Vorsprung1.438,605
95-%-Konfidenzintervall: ±8,8Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.437,755
95-%-Konfidenzintervall: ±20,721Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlLife, physical and social scienceTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 11.811 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 1.939 anonymen Paarvergleichen.
Gewinner1.457,152
95-%-Konfidenzintervall: ±6,629Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.435,825
95-%-Konfidenzintervall: ±13,971Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 33.192 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 5.065 anonymen Paarvergleichen.
Gewinner1.443,332
95-%-Konfidenzintervall: ±5,001Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.428,117
95-%-Konfidenzintervall: ±9,119Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 3.404 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 565 anonymen Paarvergleichen.
1.419,092
95-%-Konfidenzintervall: ±10,768Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.428,606
95-%-Konfidenzintervall: ±24,143Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 3.921 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 653 anonymen Paarvergleichen.
1.431,793
95-%-Konfidenzintervall: ±10,225Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.438,481
95-%-Konfidenzintervall: ±22,896Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlMedicine and healthcareTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 5.339 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 844 anonymen Paarvergleichen.
Kein klarer Vorsprung1.450,98
95-%-Konfidenzintervall: ±9,194Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.421,161
95-%-Konfidenzintervall: ±21,257Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 12.874 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 1.925 anonymen Paarvergleichen.
Kein klarer Vorsprung1.447,044
95-%-Konfidenzintervall: ±6,532Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.432,256
95-%-Konfidenzintervall: ±14,007Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 38.664 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 6.131 anonymen Paarvergleichen.
Gewinner1.428,048
95-%-Konfidenzintervall: ±4,521Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.406,139
95-%-Konfidenzintervall: ±8,159Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 1.205 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 235 anonymen Paarvergleichen.
Kein klarer Vorsprung1.444,892
95-%-Konfidenzintervall: ±17,617Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.415,979
95-%-Konfidenzintervall: ±38,135Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 7.515 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 1.242 anonymen Paarvergleichen.
Gewinner1.440,06
95-%-Konfidenzintervall: ±7,682Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.410,34
95-%-Konfidenzintervall: ±17,157Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlSoftware and IT servicesTestdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 28.553 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 4.587 anonymen Paarvergleichen.
Kein klarer Vorsprung1.479,419
95-%-Konfidenzintervall: ±5,003Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.468,806
95-%-Konfidenzintervall: ±9,304Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 2.048 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 393 anonymen Paarvergleichen.
Gewinner1.441,644
95-%-Konfidenzintervall: ±14,576Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.392,394
95-%-Konfidenzintervall: ±31,573Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlWriting, literature and languageTestdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGrok 4.3: Snapshot: grok-4.3, Harness: Arena text, style control Mistral Medium 3.5: Snapshot: mistral-medium-3.5, Harness: Arena text, style controlGrok 4.3: Stilbereinigte Arena-Bewertung aus 18.396 anonymen Paarvergleichen.Mistral Medium 3.5: Stilbereinigte Arena-Bewertung aus 2.919 anonymen Paarvergleichen.
Gewinner1.423,851
95-%-Konfidenzintervall: ±5,775Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.403,766
95-%-Konfidenzintervall: ±11,409Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Unsere Tests
Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
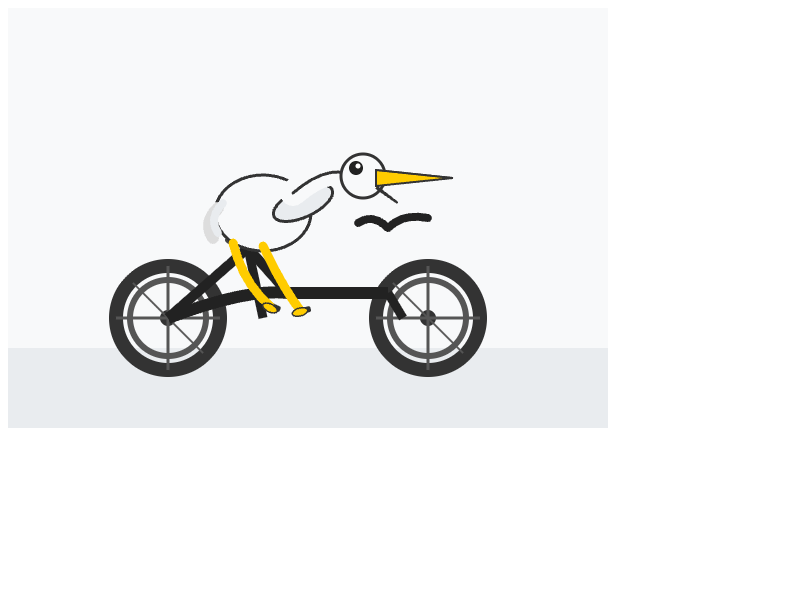
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
Grok 4.3
Community-Klassiker für eine freie SVG-Zeichnung.
Reasoning (angefragt): high
Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
x-ai/grok-4.3
API-Modell laut Antwort
x-ai/grok-4.3
Reasoning-Einstellung
high
Festgelegter Endpunkt
xAI | x-ai/grok-4.3-20260430
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
149 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Mistral Medium 3.5
In diesem Testlauf war kein API-Zugang verfügbar. Das Modell wurde nicht bewertet.
Reasoning (angefragt): high
Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
mistralai/mistral-medium-3-5
Reasoning-Einstellung
high
Festgelegter Endpunkt
Mistral | mistralai/mistral-medium-3.5-20260430
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht ausgeführt
Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche Grok 4.3 und Mistral Medium 3.5 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.